


構造化データとは?AI検索・LLMOで効く理由と、企業サイトの実装手順
構造化データとは、ページに書かれている社名、著者、価格、日付といった情報を、検索エンジンなどのプログラムが読み取れる決まった形式で記述したデータのことです。人が読む本文はそのまま残し、その裏側に「これは会社名」「これは公開日」という目印を付けます。目印の語彙を定めているのが、Google、Microsoft、Yahoo、Yandexの参加するschema.orgです。
この分野には「入れれば順位が上がる」「AIに引用されるための必須条件だ」という期待と、「もう意味がない」という切り捨てが混ざっています。Googleの文書を原文で読むと、どちらも正確ではありません。構造化データは検索結果の見え方を広げるためのもので、順位を押し上げる装置でも、生成AIに載るための切符でもない、というのがGoogleの文書の立場です。
想定する読み手は、自社サイトの改修や記事制作を預かるマーケティング部門の方と、その判断を求められる上司の方です。定義と語彙、3つの書式、Googleができると言っていることと言っていないこと、普及の統計、AI検索との関係、企業サイトで優先する型、実装の9手順、チェックの方法、よくあるエラーの順に進めます。数字と引用はいずれも、本記事の確認日(2026年10月25日時点)に開いた公式文書と調査に基づきます。
目次
- 構造化データとは:Googleの定義と、schema.orgという共通語彙
- JSON-LD・microdata・RDFaの違い:3つの書式とGoogleが推奨する理由
- 構造化データで「できること」と「できないこと」:Googleの公式見解を原文で確かめる
- 普及の実態:3つの統計で見る構造化データの採用率
- 構造化データとAI検索・LLMO:公式に書かれていること、調査が示すこと、根拠のない主張
- 企業サイトで優先する構造化データの型:10種類の用途と必須プロパティ
- 構造化データの実装手順:9つのステップとJSON-LDの書き方の例
- 構造化データのチェック・テスト:リッチリザルト テスト、Schema Markup Validator、Search Console
- よくあるエラーとガイドライン違反:手動による対策を避ける書き方
- よくある質問(FAQ)
- まとめ:構造化データは「AIのため」ではなく「事実を正確に伝えるため」に入れる
- 出典・参考資料
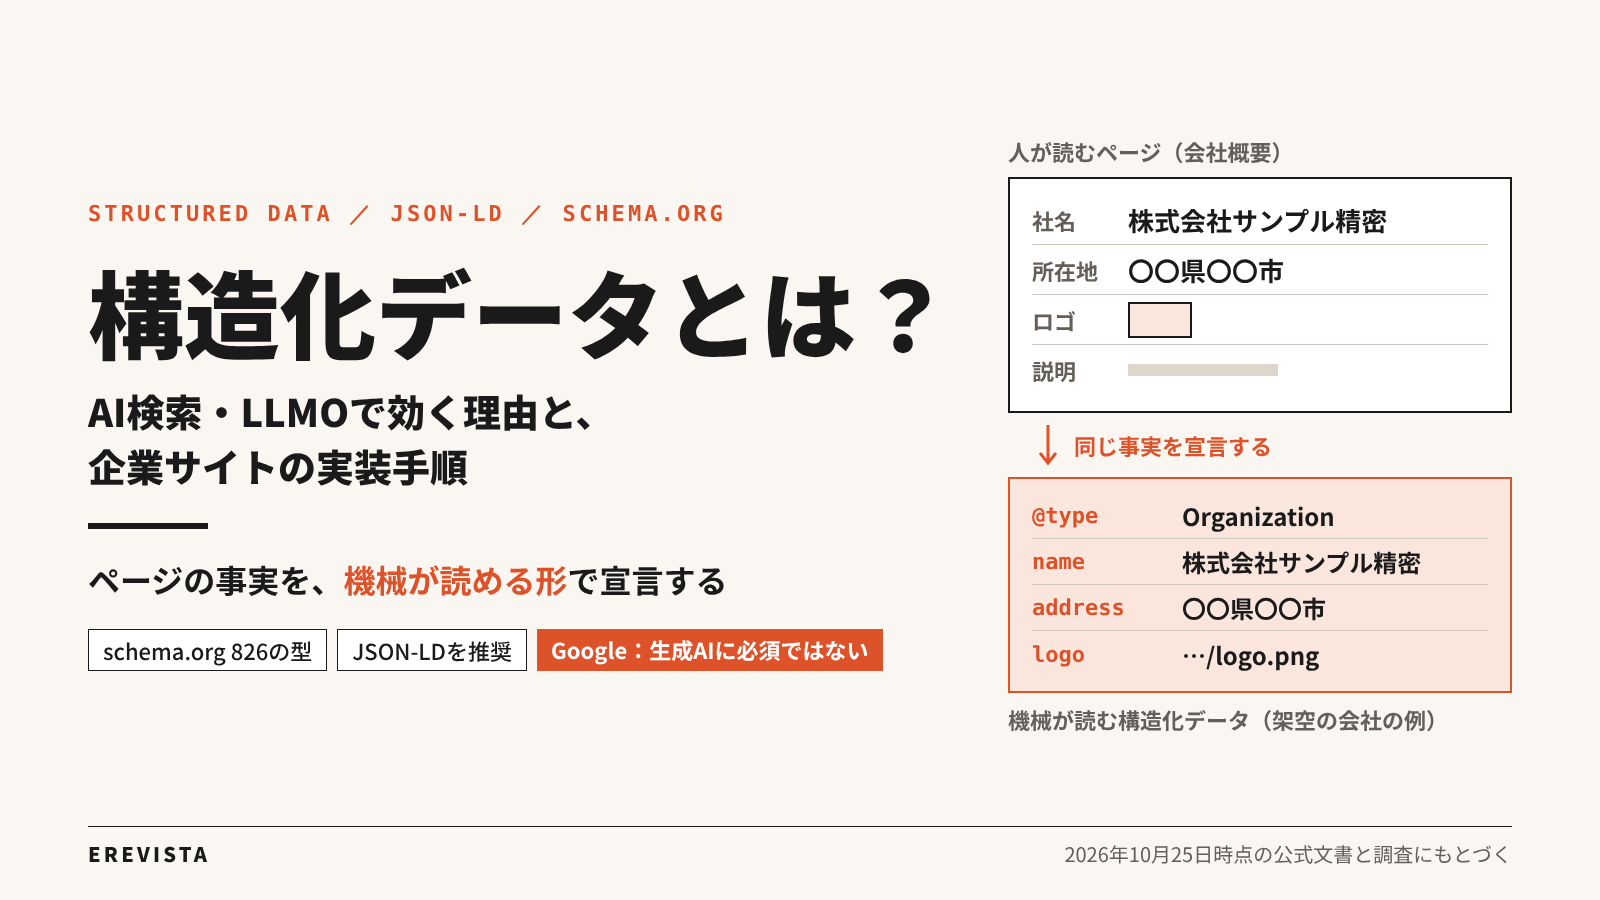
構造化データについて最初に確かめた5つの事実
- schema.orgは2011年6月2日にGoogle、Bing、Yahoo!が共同で発表した共通語彙で、2026年9月16日公開のバージョン30.1には826の型(Type)と1,540のプロパティが収録されています。
- Googleが受け付ける書式はJSON-LD、microdata、RDFaの3つで、Googleは「実装と管理を最も容易に行うことができる」理由からJSON-LDを勧めています。W3Techsの2026年10月25日時点の集計では、調査対象サイトの56.3%がJSON-LDを使っています。
- Googleの検索ギャラリーには、2026年10月19日更新の版で25種類のリッチリザルトが載っています。FAQ(よくある質問)向けの拡張表示は2026年5月7日に終了し、同年6月15日には文書も削除されました。
- GoogleのAI機能向けのガイドには「生成 AI 検索に構造化データは必要ありません」とあります。それでも、リッチリザルトの候補になるのに役立つとして、SEO全体の一部として使い続けることを勧めています。
- 2026年5月11日公開のAhrefsの調査では、JSON-LDを新たに追加した1,885ページのAI引用数は、AIによる概要で−4.6%、AIモードで+2.4%、ChatGPTで+2.2%と、追加による増加は確認されませんでした。
構造化データとは:Googleの定義と、schema.orgという共通語彙
構造化データとは、Googleの言葉を借りれば「ページに関する情報をさまざまなサイトで活用できるように標準化したデータ形式」です。標準化の中身は2つに分かれます。何を表す言葉を使うかという語彙(これを定めるのがschema.org)と、その語彙をHTMLのどこにどう書くかという書式(JSON-LDなど)です。
Googleの定義:ページの情報を「標準化したデータ形式」で渡す
Google 検索セントラルの構造化データの入門ページ(2025年12月18日の版)は、構造化データを「ページに関する情報をさまざまなサイトで活用できるように標準化したデータ形式」と定義しています。例はレシピページで、材料、加熱時間、加熱温度を項目ごとに渡せる、という説明です。
企業サイトなら、会社概要ページの「社名」「所在地」「設立年」、記事ページの「著者」「公開日」「更新日」がこれにあたります。HTMLは「この文字列は会社名である」という意味までは伝えないため、検索エンジンが本文から行う意味の推定を、運営者の宣言で補うのが構造化データの役目です。
同じ入門ページは、検索用の構造化データでは主にschema.orgのボキャブラリが使われるとしつつ、Google検索での動作の定義はGoogle 検索セントラルの文書を見るよう促しています。語彙の全部がGoogle検索の表示に使われるわけではなく、必須と推奨のプロパティもGoogle側の文書で決まるためです。
schema.orgとは:2011年に検索エンジン3社が始めた語彙
schema.orgは、ウェブ上の構造化データの語彙を作り、維持し、普及させることを使命とする共同プロジェクトです。Googleの公式ブログによると、発表日は2011年6月2日で、Google、Bing、Yahoo!の3社が共同で立ち上げました。発表時点で100を超える新しいカテゴリの語彙が用意され、2009年に始まったリッチスニペットの表示回数が2年間で10倍を超えていた、という当時の数字も記されています。
現在のschema.orgのトップページは、創設企業としてGoogle、Microsoft、Yahoo、Yandexの4社を挙げています。語彙は「エンティティ(実体)、エンティティ同士の関係、アクション」を扱い、RDFa、Microdata、JSON-LDのどの書式でも使えます。schema.org自身の記述では、2024年時点で4,500万を超えるドメインが4,500億を超えるschema.orgのオブジェクトを記述しているとされます。自己申告の値で、第三者の集計は普及データの章で扱います。概要ページによると、運営はリリースを承認する小規模なステアリンググループと、2015年4月から議論の場になっているW3C(ウェブ技術の標準化団体)のコミュニティグループの二層です。
語彙の規模:バージョン30.1で826の型と1,540のプロパティ
schema.orgのスキーマ一覧には、語彙が現在826の型(Type)、1,540のプロパティ、19のデータ型、96の列挙型、544の列挙メンバーから成ると書かれています。画面に出るバージョンは30.1、日付は2026年9月16日です。型は階層になっており、最上位のThing(「最も汎用的なもの」と定義された型)の直下に、組織、人、創作物(記事はその下位)、商品、イベント、場所など11の型が並びます。
リリース履歴によれば改訂は年に数回で、2025年12月8日の29.4で会議イベントを表すConferenceEventが加わり、2026年9月16日の30.1ではEUのデジタル製品パスポートと電子商取引向けの語彙が増えています。
JSON-LD・microdata・RDFaの違い:3つの書式とGoogleが推奨する理由
Googleが受け付ける書式はJSON-LD、microdata、RDFaの3つで、Googleは管理のしやすさを理由にJSON-LDを勧めています。3つは「同じ語彙を、HTMLのどこに、どんな文法で書くか」の違いであり、正しく書けばどれも有効です。
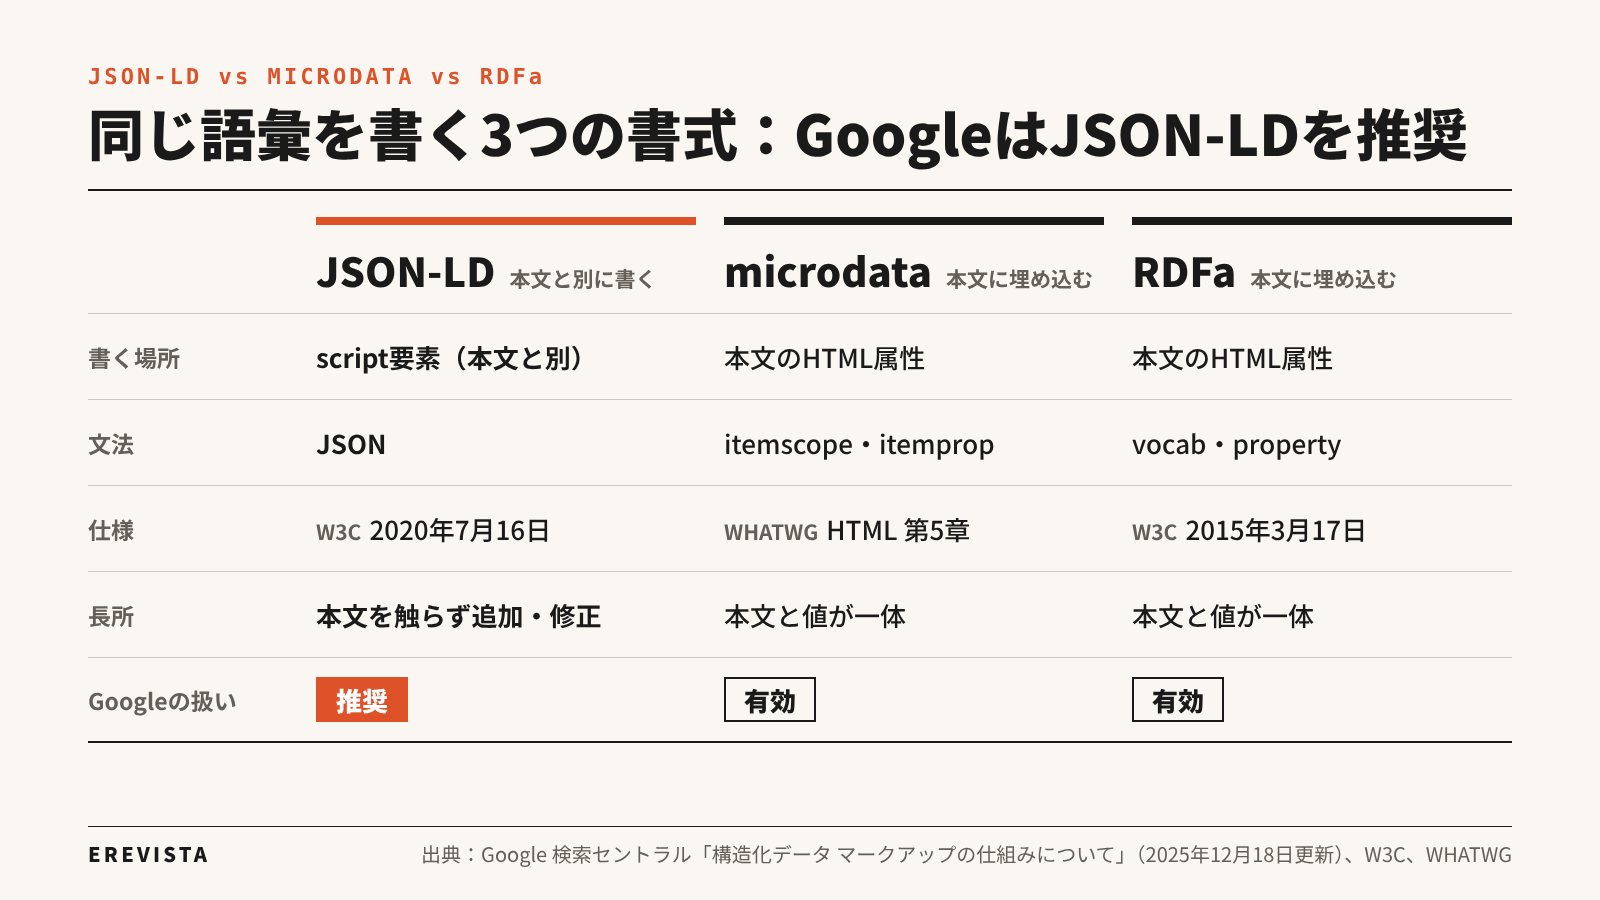
図:構造化データの3つの書式の比較(Google 検索セントラル、W3C、WHATWGの文書をもとに作成)
3つの書式の比較表
| 比較項目 | JSON-LD | microdata | RDFa |
|---|---|---|---|
| 書く場所 | script要素の中に、本文とは別に書く | 本文のHTMLタグに属性として書く | 本文のHTMLタグに属性として書く |
| 文法 | JSON(波かっことコロンで項目と値を並べる形式) | itemscope、itemtype、itemprop などの属性 | vocab、typeof、property などの属性 |
| 仕様の管理 | W3C(勧告は2020年7月16日のJSON-LD 1.1) | WHATWG(HTML Living Standardの第5章) | W3C(勧告は2015年3月17日のRDFa Core 1.1 第3版) |
| 長所 | 本文を触らずに追加・修正できる。入れ子の表現が簡単 | 本文と値が同じ場所にあり、食い違いが起きにくい | microdataと同様に本文と一体 |
| 短所 | 本文と二重管理になり、更新漏れで食い違いが起きうる | テンプレートの改修が必要で、入れ子が複雑になる | 構文が複雑で、採用例が少ない |
| Googleの扱い | 推奨 | 有効 | 有効 |
JSON-LD:本文とは別の場所にJSONで書く
JSON-LDは、JSONと呼ばれるデータ形式に「意味のつながり(リンクトデータ)」を表す約束を加えた書式です。W3CのJSON-LD 1.1仕様は2020年7月16日に勧告となり、JSONと100%互換であると記されています。Googleの入門ページは、head要素またはbody要素のscriptタグ内に埋め込む表記と説明しています。見えるテキストの間にマークアップが挟まらないため、入れ子になった項目を簡単に表せる点が長所です。
microdata:HTMLの属性として本文に埋め込む
microdataは、HTMLのタグにitemscope、itemtype、itemprop、itemid、itemrefの5つの属性を付けて、本文の文字列そのものに意味を与える書式です。仕様はWHATWG(ブラウザ各社が参加するHTMLの標準化団体)のHTML Living Standard第5章にあります。2026年10月22日更新の版では、名前と値の組を既存の内容と並行して入れ子で追加できる仕組みと説明されています。
RDFa:W3Cの勧告で、HTMLの属性として書く
RDFaは、マークアップ言語の属性で構造化データを表す仕様です。W3CのRDFa Core 1.1 第3版は2015年3月17日の勧告で、「あらゆるマークアップ言語の中で構造化データを表現するための属性の仕様」という位置づけです。Googleの入門ページでは「リンクデータをサポートする HTML5 の拡張機能」という短い説明です。SNS向けのOpen Graphのmetaタグが同じproperty属性を使うため、統計上はRDFaの利用率が高く出ます。
Googleの推奨:「実装と管理を最も容易に行うことができる」JSON-LD
Googleは入門ページで、サイトの設定で許容されている限りJSON-LDの採用を勧めています。理由は、ウェブサイトの所有者が「実装と管理を最も容易に行うことができる(つまり、ユーザーエラーの発生する可能性が低い)」ためです。同時に、マークアップが有効で機能の文書どおりに実装されていれば「3 つの形式はいずれも有効です」とも明記しています。既存のテンプレートがmicrodataで書かれていてエラーが出ていないなら書き直す必要はなく、新しく実装するなら本文を触らずに済むJSON-LDが標準的な選択です。
構造化データで「できること」と「できないこと」:Googleの公式見解を原文で確かめる
Googleの文書で確認できる構造化データの役割は、ページ内容の認識を助けること、そしてリッチリザルトと呼ばれる拡張表示の候補になることの2つです。表示を保証する記述も、掲載順位を上げると述べた記述も、本記事で開いた文書にはありませんでした。
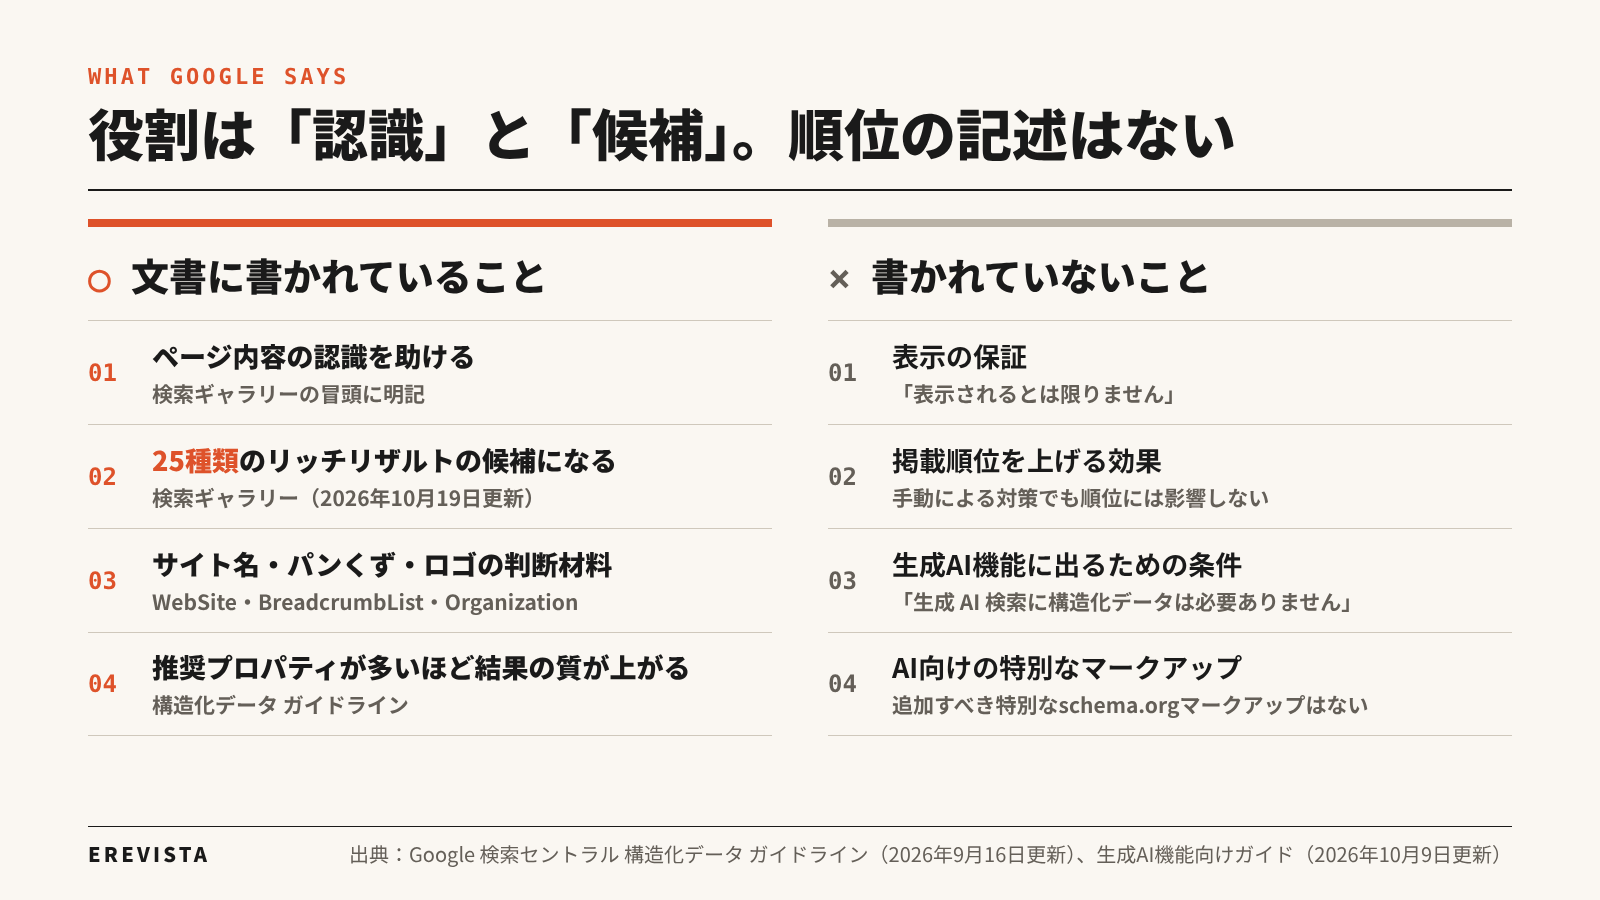
図:構造化データの役割についてGoogleの公式文書が述べていること・いないこと(Google 検索セントラルの文書をもとに作成)
できること1:ページの内容を認識する材料になる
Google 検索セントラルの検索ギャラリーは冒頭で、構造化データの用途を2つ挙げています。ページのコンテンツを認識することと、そのコンテンツを「リッチリザルト」と呼ばれる情報が豊富な検索結果に表示することです。拡張表示が出なくても、内容の認識を助けるという1つ目の用途は残ります。
できること2:25種類のリッチリザルトの候補になる
リッチリザルトとは、青いタイトルと説明文だけの検索結果に、評価の星、価格、パンくず、サムネイル、求人の条件などが付いた表示の総称です。2026年10月19日更新の検索ギャラリーに載る種類は25で、記事、パンくずリスト、カルーセル、コースリスト、データセット、ディスカッション フォーラム、教育向けQ&A、雇用主の総合評価、イベント、画像メタデータ、求人情報、ローカル ビジネス、数学の解法、映画、組織、商品、プロフィール ページ、Q&A、レシピ、クチコミ抜粋、ソフトウェア アプリ、読み上げ、定期購入とペイウォール コンテンツ、民泊、動画です。この一覧に、よくある質問(FAQ)とHowToは含まれていません。
できること3:サイト名、パンくず、ロゴの判断材料になる
Googleの各文書によると、サイト名はトップページに置くWebSiteの記述、パンくずはパンくずリストの記述、検索結果やナレッジパネルに出るロゴは組織の記述のlogoが情報源になります。SEOスターター ガイド(Google 検索セントラル)にも、パンくずは「構造化データによって影響を与えることもできます」とあります。
できないこと1:表示の保証
Googleの構造化データ ガイドライン(9月16日版)は、冒頭に「重要」と銘打った注記を置き、構造化データの有無にかかわらず表示は保証されない旨を述べています。正しく書いても出ない理由として、ページの主要内容を表していないか誤解を与えている可能性、リッチリザルト テストでは検出できない誤り、参照先がユーザーに見えない内容であること、各種ガイドラインへの不準拠が挙げられています。社内には「候補になる」と「表示される」を分けて伝えてください。
できないこと2:掲載順位を上げること
順位への効果については、本記事で開いたGoogleの文書に記載がありません。同ガイドラインは、違反で手動による対策が実施された場合、ページがリッチリザルトとして表示されなくなる一方、「Google ウェブ検索でのページの掲載順位には影響しません」とあります。
Googleが公開している効果の事例と、その読み方
入門ページには企業の事例が載っています。The Food Networkでは全ページの80%で検索結果の機能を有効にした結果アクセス数が35%増え、楽天では構造化データを実装したページの滞在時間が、ないページの1.5倍になりました。検索機能のあるAMPページのインタラクション率は、ない場合の3.6倍だったとも書かれています。
もう一つ、Google 検索セントラルが2024年6月4日付で公開したVidioの事例があります。インドネシアの動画配信サービスが既存の動画カタログにVideoObjectの記述を追加し、1年以内にGoogle検索での動画のインプレッション数が約3倍、クリック数が約2倍になった、という内容です。同じ期間に公開本数も約30%増えているうえ、どれも1社の結果なので、自社で同じ数字が出る保証とは読めません。
リッチリザルトの種類は増減する:2025年以降の変更履歴
リッチリザルトの種類は固定ではなく、Google 検索セントラルの更新履歴のページをたどると、2025年以降だけでも次の変更がありました。
| 日付 | 変更の内容 |
|---|---|
| 2025年1月22日 | パンくずリストはモバイル版の検索結果には表示されず、パソコン版にのみ表示されると記載 |
| 2025年6月12日 | 書籍アクション、コース情報、給与推定額、ClaimReview、学習用動画、特別なお知らせ、車両リスティングなどの廃止を予告するバナーを追加 |
| 2025年9月9日 | コース情報、給与推定額、学習用動画、特別なお知らせ、車両リスティングの文書を削除(検索結果に表示されなくなったため) |
| 2026年1月6日 | 練習問題の構造化データタイプの文書を削除 |
| 2026年5月8日 | よくある質問のリッチリザルト機能のサポート終了を告知(2026年5月7日以降は表示されない) |
| 2026年6月15日 | よくある質問のリッチリザルト機能に関する文書を削除 |
| 2026年7月7日 | 販売者リスティングにProduct.categoryを追加。セール価格の有効期間(validFrom、validThrough、priceValidUntil)の書き方を明確化 |
| 2026年7月24日 | 虚偽のクチコミと、報酬が伴うことが開示されていないクチコミに関する新しいガイドラインをクチコミ抜粋に追加 |
よくある質問(FAQPage):2023年の縮小から2026年5月の終了まで
FAQ向けの拡張表示は、段階的に縮小されたあと終了しています。米国のSEOニュースサイトSearch Engine Journalが2026年5月10日に出した記事が経緯をまとめています。Googleは2023年8月に、FAQの拡張表示を「よく知られた権威ある政府機関と医療のウェブサイト」に限ると発表し、同時にHowToをモバイルで廃止しました。そして2026年5月7日以降、FAQの拡張表示は検索結果に出なくなりました。
同じ報道によれば、Googleは2026年6月にレポートとテストツールでのFAQの対応を取り下げ、2026年8月にはSearch Console APIでの対応も外すと告知し、理由は説明していません。既存のマークアップを急いで消す必要はないとも記しています。
普及の実態:3つの統計で見る構造化データの採用率
2024年10月のウェブ全体のクロールでは、解析したページの52.1%、ドメインの44.1%に何らかの構造化データが含まれていました。書式ではJSON-LDが最多で、型ではWebSite、組織、パンくずリストが上位です。出どころの違う3つの統計を並べます。
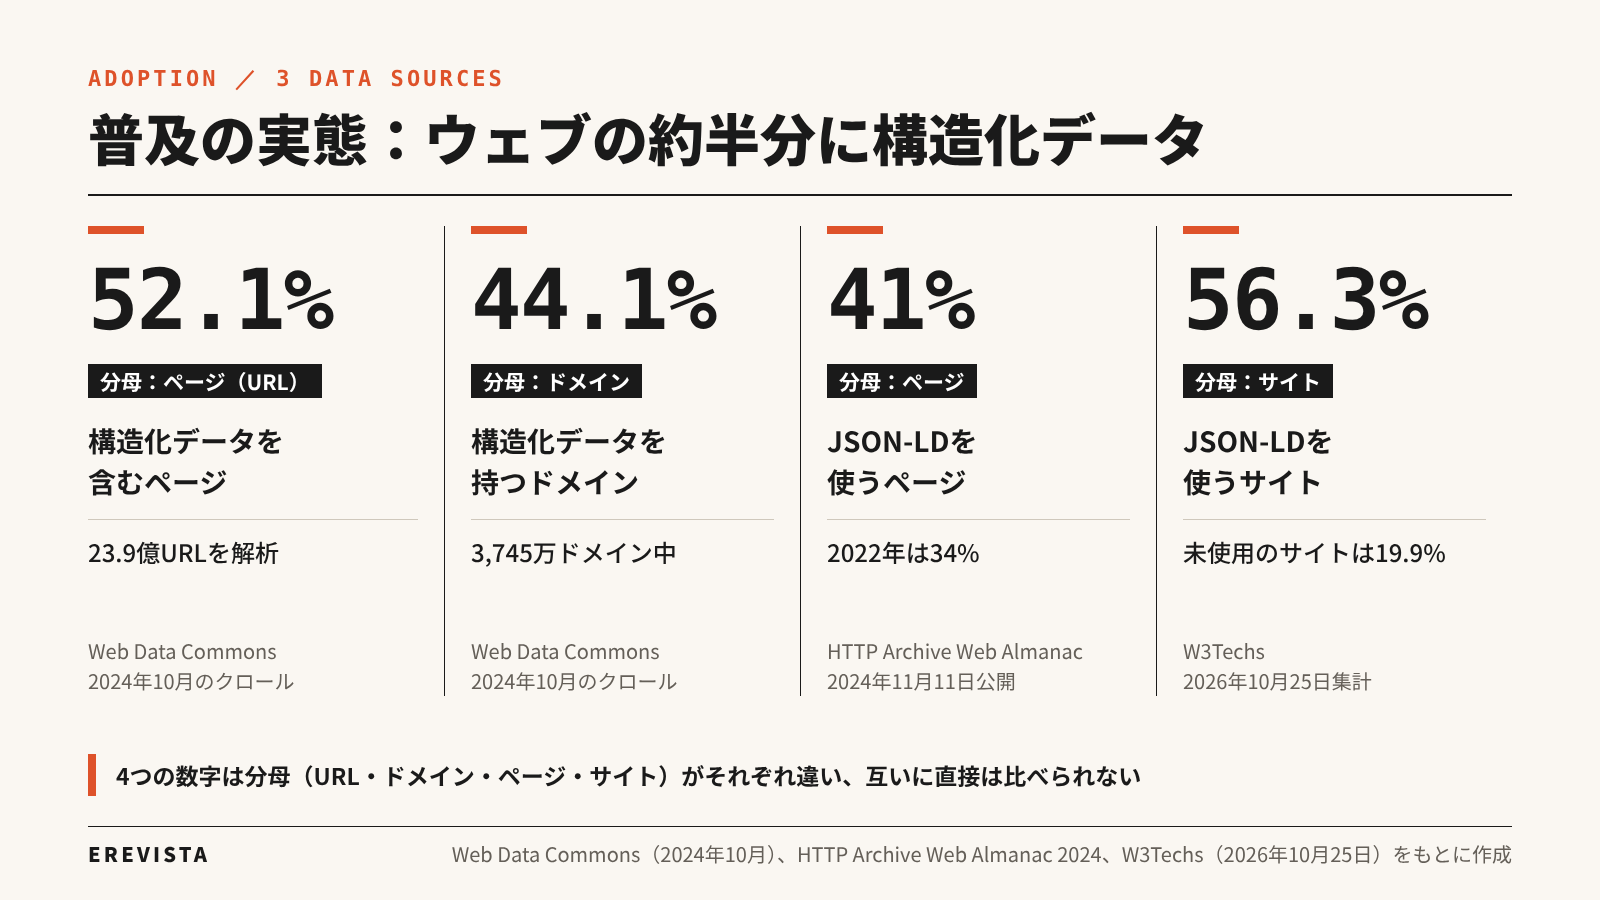
図:構造化データとJSON-LDの普及率(Web Data Commons、HTTP Archive Web Almanac 2024、W3Techsをもとに作成)
| 統計 | 時点 | 対象 | JSON-LD | microdata | RDFa |
|---|---|---|---|---|---|
| Web Data Commons | 2024年10月のクロール | 23.9億URL、3,745万ドメイン | 1,156万ドメイン(全体の30.9%) | 760万ドメイン(20.3%) | 47万ドメイン(1.3%) |
| HTTP Archive Web Almanac 2024 | 2024年11月11日公開 | HTTP Archiveがクロールしたページ | ページの41%(2022年は34%) | ページの26% | ページの66%(Open Graphを含む) |
| W3Techs | 2026年10月25日 | 2,000万超のサイト | サイトの56.3% | サイトの20.9% | サイトの36.3%(汎用RDFa) |
Web Data Commons:ページの52.1%、ドメインの44.1%に構造化データ
マンハイム大学(ドイツ)の研究グループが維持するWeb Data Commonsは、公開クロールデータのCommon Crawlから構造化データを毎年抽出して公開しています。最新の2024年10月分の統計ページでは、解析した23億9,103万9,772件のHTMLページのうち12億4,562万2,627件(52.1%。表の件数から本記事で計算した値で、同ページの要約文は51.25%と記しています)に構造化データがありました。ドメイン単位では、3,744万7,141のうち1,652万5,070(44.1%)が何らかの構造化データを持っていました。
書式別のドメイン数は、JSON-LDが1,156万2,359、microdataが759万9,792、RDFaが47万4,635です。構造化データを持つドメインのうち70.0%がJSON-LDを使っている計算になります(本記事で割り算した値)。JSON-LDの型をドメイン数で見ると、上位3つはWebSite(846万1,613)、ImageObject(687万3,617)、Organization(657万4,284)で、BreadcrumbList(620万6,556)は7位、Person(472万6,830)は10位です。
HTTP Archive Web Almanac:JSON-LDは2022年の34%から2024年の41%へ
HTTP Archiveが2024年11月11日に公開したWeb Almanac 2024の構造化データの章によると、JSON-LDを使うページの割合は2022年の34%から2024年の41%に増えました。microdataは26%で横ばい、RDFaは66%です。型別では、モバイルページの12.73%にサイト名、7.16%に組織、3.97%にローカル ビジネス、5.66%にパンくずリストの型がありました。Productは0.77%、Articleは0.18%、FAQPageはVideoObjectやEventと並んで約0.34%です。2025年版には構造化データの章がありません。
W3Techs:2026年10月時点でJSON-LDは56.3%、未使用は19.9%
技術利用統計のW3Techsが公開する構造化データ書式の利用統計(2026年10月25日集計)では、JSON-LDが56.3%、microdataが20.9%、汎用RDFaが36.3%でした。Open Graphは72.6%、Twitter/X Cardsは58.9%で、監視対象の書式を一つも使っていないサイトは19.9%です。同社の調査方法のページによると、対象は2,000万を超えるサイトで、サブドメインは別のサイトとして数えず、集計は毎日更新されます。
普及率を読むときの3つの注意
- 分母が違います。Web Data Commonsはドメイン、Web Almanacはページ、W3Techsはサイトが単位で、同じ「JSON-LDの割合」でも30.9%、41%、56.3%と開きます。
- RDFaの高い数字には、Open GraphなどRDFaと同じ属性を使うmetaタグが含まれ、schema.orgの型をRDFaで書いたサイトの割合とは別物です。
- 普及率は「正しく書かれている割合」ではなく、CMSが自動で出すサイト名やパンくずの記述が大半を占めます。
構造化データとAI検索・LLMO:公式に書かれていること、調査が示すこと、根拠のない主張
AI検索との関係で公式に確認できるのは3点です。Googleが「生成 AI 検索に構造化データは必要ありません」と明記していること、Microsoftが構造化データをAIの内容理解に役立つものとして説明していること、OpenAIの公開文書には言及がないことです。「構造化データを入れればAIに引用される」という主張を支える一次情報は、本記事の調査では見つかっていません。
Google:「生成 AI 検索に構造化データは必要ありません」
最終更新が2026年10月9日の生成AI向け最適化ガイド(Google 検索セントラル)には、「構造化データに対する過剰な取り組み」と題した項目があり、本文は「生成 AI 検索に構造化データは必要ありません」と始まります。続けて、追加すべき特別なschema.orgマークアップもないとしたうえで、リッチリザルトの候補になるのに役立つためSEO戦略全体の一部として使い続けることを勧める、という3文です。
Google 検索セントラルには「AI 機能とウェブサイト」という文書もあります(2025年12月31日版)。AI機能に出るために新しいファイルもマークアップも要らず、「特別な schema.org の構造化データを追加する必要もありません」と述べます。一方で推奨事項として「構造化データをページに表示されるテキストと一致させます」を挙げています。AIによる概要やAIモードに出る前提は3つで、インデックスに入っていること、スニペットを出せること、検索の技術要件を満たすことであり、構造化データは入っていません。要約に引用されるための施策はAIによる概要への対策の記事に譲ります。
AIによる概要そのものの仕組みと、表示をオフにする方法は、AIによる概要を主題にした別の記事で詳しく扱います。
Microsoft:AIシステムの内容理解を助けるコードとして説明
Microsoftの広告事業部門が公開したブログ記事(2025年10月8日公開)には、「スキーマ マークアップはAIがコンテンツを理解するのにどう役立つか」という見出しがあります。スキーマを「検索エンジンとAIシステムがコンテンツを理解するのを助けるコードの一種」で、多くはCMSを通じてJSON-LDで追加されるものと説明しています。AI検索での可視性のためのチェックリストには「スキーマ、明確な見出し、モジュール型のレイアウトでコンテンツを構造化する」が入っています。どの型をどれだけ入れると引用が増えるかという数字はなく、Bingのウェブマスター ガイドラインのページは本記事の環境では本文を開けなかったため、Bing側の引用はこのブログ記事に限ります。
OpenAIとPerplexity:公式文書での扱い
OpenAIについては、クローラーの解説、公開者向けFAQ、ChatGPTの商品表示に使う商品フィードの仕様の3文書を本記事の確認日に開きましたが、schema.orgや構造化データへの言及はありませんでした。ChatGPTの検索に載る条件として書かれているのは検索用クローラーOAI-SearchBotをブロックしないことで、商品情報はフィードとして別途提出する設計です。Perplexityの公式文書については、Perplexityを主題にした別の記事で確かめます。
第三者調査:Ahrefsが1,885ページを追跡した結果
一次情報が乏しい領域では、第三者の実測が判断材料になります。2026年5月11日に公開されたAhrefsの調査は、2025年8月から2026年3月の間に新たにJSON-LDを追加した1,885ページを対象にしています。追加前後30日間のAIからの引用数の変化を、追加していない対照ページと比べる設計です。対象はいずれも2025年2月時点でAIによる概要に100回以上引用されていたページです。
結果は、AIによる概要で−4.6%(統計的に有意だが小さい減少)、AIモードで+2.4%、ChatGPTで+2.2%(いずれも統計的にゼロと区別できない)でした。同じ調査は、約600万URLの集計でAIに引用されたページの53%に構造化データがあり、引用されたページは引用されていないページに比べて約3倍JSON-LDを持ちやすかったとも報告しています。筆者の解釈は、この相関は「構造化データを入れているサイトは他のSEOにも投資している」ことの反映だろう、というものです。
限界も明記されています。他の変更と切り分けられないこと、複数の型をまとめて扱っていること、観測が30日間であること、対象がすでに大量に引用されているページに偏っていることです。同記事は別の実験にも触れています。ChatGPT、Claude、Perplexity、Gemini、GoogleのAIモードの5つが利用者の指示でページを直接取得する場面では、どれも表示されるHTMLの内容だけを抽出していた、という内容です(その実験の原文は本記事では開いていません)。
本記事の整理:確認できたこと、推測されること、根拠のないこと
| 主張 | 根拠の種類 | 本記事の判断 |
|---|---|---|
| 構造化データはGoogleの生成AI機能の条件ではない | Googleの公式文書に明記 | 確認できた事実 |
| 構造化データを本文と一致させることは推奨される | Googleの公式文書に明記 | 確認できた事実 |
| MicrosoftはAIの内容理解に役立つものと位置づけている | Microsoftの公式ブログ | 確認できた事実(効果の数字はない) |
| 引用されるページは構造化データを持つ割合が高い | Ahrefsの約600万URLの相関 | 事実だが、因果ではない |
| 構造化データを追加すると引用が増える | Ahrefsの1,885ページの前後比較で増加なし | 本記事の時点で支持されない |
| AI向けの専用マークアップが存在する | 該当する公式文書なし。Googleは「ない」と明記 | 根拠のない主張 |
実務上の提案:一貫性とリッチリザルトのために入れる
本記事の提案は、「AIに引用させるため」ではなく「自社の事実を一貫して正確に伝えるため」に構造化データを入れる、というものです。AIの回答で自社が選ばれるための考え方の全体はLLMOの考え方と全体像の記事にあり、構造化データはその技術的な土台の一項目です。
順番は本文が先で、独自の一次情報、結論から書く構成、著者と更新日の明示がそろったページに、矛盾のない構造化データを添えます。文章側の手法を研究論文から整理した生成エンジン最適化(GEO)は、GEOを主題にした記事で読めます。
点検はLLMO対策の自社チェックリストの8番目の項目として合否で確かめられます。
AIに向けた案内文ファイルであるllms.txtは、構造化データと混同されやすい存在です。役割の違いは、llms.txtの解説にある4つのファイルの比較表で確かめられます。
企業サイトで優先する構造化データの型:10種類の用途と必須プロパティ
企業サイトで検討する型は10種類で足ります。会社を表す組織とサイト名、ページの位置と作り手を表すパンくずリスト、記事、プロフィール ページ、事業に応じて加える商品、ローカル ビジネス、求人情報、動画、イベントです(英語の型名は表のとおり)。用途、必須プロパティ、日本での表示の有無を、2026年9〜10月時点のGoogleの文書で確かめた範囲でまとめます。

図:企業サイトで優先する構造化データの型と必須プロパティ(Google 検索セントラルの各文書をもとに作成)
| 型 | 何に使われるか | 必須プロパティ | 主な推奨プロパティ | 日本でのリッチリザルト |
|---|---|---|---|---|
| Organization | 組織の管理情報の把握と、検索結果での組織の明確化。ロゴの表示 | なし | name、legalName、url、logo、sameAs、description、address、contactPoint、numberOfEmployees | 地域の限定記載なし |
| WebSite | 検索結果に出すサイト名の指定 | name、url | 別名(任意) | Google検索が可能なすべての言語で表示 |
| BreadcrumbList | 検索結果でのページの階層表示 | itemListElement(ListItemはitem、name、position) | — | パソコン版のみ。すべての地域と言語 |
| Article(BlogPosting、NewsArticle) | 記事のタイトル、画像、日付の適切な表示 | なし | author(name、url)、datePublished、dateModified、headline、image | 地域の限定記載なし |
| ProfilePage | 著者や従業員など単一の人物・組織の紹介ページの把握 | mainEntity(人または組織。nameは必須) | description、image、sameAs、identifier、dateCreated、dateModified | 地域の限定記載なし |
| Product(商品スニペット) | 評価、価格、在庫を付けた商品の検索結果 | name、およびreview・aggregateRating・offersのいずれか(offersではprice) | priceCurrency(スニペットでは推奨)、review、aggregateRating | 長所と短所の表示はGoogle検索を利用可能なすべての国 |
| Product(販売者リスティング) | 購入できるページの商品情報(配送、返品、サイズなど) | name、image、offers(priceCurrencyも必須) | aggregateRating、brand.name、category、gtin、review、shippingDetails、hasMerchantReturnPolicy | 地域の記載は確認できず(販売ページのみ対象) |
| LocalBusiness | 営業時間、部門、拠点情報の伝達 | name、address | openingHoursSpecification、telephone、url、geo、priceRange | 地域の限定記載なし |
| JobPosting | 求人検索での求人情報の表示 | datePosted、description、hiringOrganization、jobLocation、title | baseSalary、employmentType、validThrough(期限のある求人では必須)、jobLocationType | 対象地域の一覧に日本を含む |
| VideoObject | 動画の検索結果、動画モード、Discoverでの表示 | name、thumbnailUrl、uploadDate | description、duration、contentUrl、embedUrl、expires、hasPart(Clip) | Clipはすべての言語。SeekToActionは日本語を含む12言語 |
| Event | イベントの検索結果とGoogleマップでの表示 | location、name、startDate | description、endDate、eventStatus、image、offers、organizer、performer | 提供地域の一覧に日本は含まれない |
会社を表す型:組織とサイト名
Googleの組織向けの文書は2026年9月12日に更新されています。トップページに追加すればGoogleが組織の管理上の情報を把握する助けになり、検索結果でその組織をはっきり特定できるようになる、とあります。必須プロパティはありません。logoに指定する画像は112ピクセル角以上という条件があり、検索結果やナレッジパネルに出るロゴに影響します。置き場所はトップページか会社概要ページのいずれか1か所で十分です。
sameAsには、公式SNSのアカウントなど同じ組織を指す別サイトのURLを並べます。社名検索で出る情報ボックスの元になる情報の一つで、パネルの仕組みと認証・修正の手順は、ナレッジパネルの表示と修正の手順の記事で扱っています。
サイト名の文書(2026年2月20日版)によると、Googleのサイト名システムはtitleや見出し、SNS向けのサイト名のmetaタグも考慮します。それでも「希望するサイト名を指定するためには WebSite 構造化データが最も重要です」とあります。必須はnameとurlで、トップページに置きます。サイト名はドメインまたはサブドメインの単位で1つだけ対応し、サブディレクトリ単位では指定できません。
ページの位置と作り手を表す型:パンくずリスト、記事、プロフィール ページ
パンくずリストの文書(同じく9月12日版)は、検索結果内のページ情報を分類する際にページ本文のパンくずマークアップを使う、と説明しています。必須はitemListElementで、ListItemを2つ以上並べ、各ListItemにitem、name、positionを書きます。最後の項目(そのページ自身)のitemは省けます。表示はパソコン版のみで、Google検索が使えるすべての地域と言語が対象です。
記事の文書(同じく9月12日版)は、追加すると記事のタイトル、画像、日付情報を検索結果で適切に表示できるようになる、としています。必須プロパティはなく、author、datePublished、dateModified、headline、imageが推奨です。authorには人または組織を指定し、作成者を一意に識別するurl(またはsameAs)を添えることを「強くおすすめします」と書かれています。画像は16:9、4:3、1:1のいずれかの比率で、幅と高さの積が50,000ピクセル以上が条件です。
プロフィール ページの文書は、ウェブサイト内の個人や組織に関する情報を提供する型で、必須はmainEntity(人または組織)です。ニュースサイトの作成者ページや企業サイトの従業員ページが例で、記事のauthor.urlからこのページへつなぐと「誰が書いたか」が機械的にたどれます。著者と運営者の信頼をGoogleがどう評価するかは、E-E-A-Tを主題にした別の記事で扱います。
事業に応じて加える型:商品、ローカル ビジネス、求人情報、動画、イベント
Productの文書は、商品ページに追加するとGoogle検索(画像検索やGoogleレンズを含む)の商品情報が充実する、と説明し、2つの使い分けを示します。商品スニペットは利用者がその場で購入できない商品ページ向けで、nameに加えてreview、aggregateRating、offersのいずれかが必須です。販売者リスティングは購入できるページ向けで、Productのname、image、offersとpriceCurrencyが必須です。他の販売サイトへのリンクを並べたページは対象外です。
ローカル ビジネスの文書は、営業時間、部門の情報、拠点の所在地などを伝える型で、必須はnameとaddressです。aggregateRatingとreviewは他のローカルビジネスの情報を集めるサイトにのみ推奨され、自社の店舗ページに自社の評価を書く用途ではありません。求人情報の文書は、必須がdatePosted、description、hiringOrganization、jobLocation、titleの5つで、期限のある求人ではvalidThroughも必須です。期限切れの求人、ログインしないと読めない求人、応募方法のない求人は掲載できません。対象地域の一覧には日本が含まれています。
動画の文書(9月29日版)は、必須をname、thumbnailUrl、uploadDateの3つとし、動画はメインの検索結果、動画モード、画像検索、Discoverなどに表示されるとしています。イベントの文書は注意が必要です。必須はlocation、name、startDateですが、提供地域として挙がるのはオーストラリア、ブラジル、カナダ、ドイツ、インド、ラテンアメリカ、スペイン、英国、米国で、日本の名はありません。日本のセミナー告知にEventを書いても、拡張表示は現時点では期待できません。
表示が終わった型:FAQPageとサイトリンク検索ボックス
FAQPageは、前章のとおり2026年5月7日以降リッチリザルトが表示されなくなり、6月15日に文書も削除されたため、新しく追加する理由はありません。
社名検索で公式サイトの下にまとまって出るサイトリンクについても、構造化データで指定する方法は文書にありません。かつてあったサイトリンク検索ボックスの記述は、Googleの更新履歴の2024年11月29日の項に、検索結果から機能が消えたことを理由に文書を削除したとあります。サイトリンクに出るページを整える方法は、サイトリンクの仕組みと対策の記事で説明しました。
優先順位の付け方:本記事の提案
BtoBの企業サイトを想定した場合、本記事が提案する順番は次のとおりです。
- 組織とサイト名の記述をトップページに置く(会社の事実とサイト名を1か所で宣言する)
- パンくずリストの記述を全ページのテンプレートに入れる(階層の把握。パソコン版で表示)
- 記事ページに記事の記述を、著者ページにプロフィール ページの記述を入れ、author.urlでつなぐ
- 事業に応じて商品、ローカル ビジネス、求人情報、動画の記述を追加する
- FAQPageと日本のEventは、表示が期待できないため優先度を下げる
サイト名、組織、パンくずは多くのCMSが自動出力するため、差がつくのは組織の記述の正確さと、記事とプロフィール ページで作り手を示す部分です。
構造化データの実装手順:9つのステップとJSON-LDの書き方の例
実装は、型を決める、ページに割り当てる、値の出どころを決める、JSON-LDを書く、置く、本文とそろえる、テストする、公開して監視する、保守する、の9段階で進めます。組織とサイト名の記述だけなら半日、パンくずと記事の記述をテンプレートに組み込むなら、制作会社との調整を含めて2〜4週間が目安です(本記事の目安)。
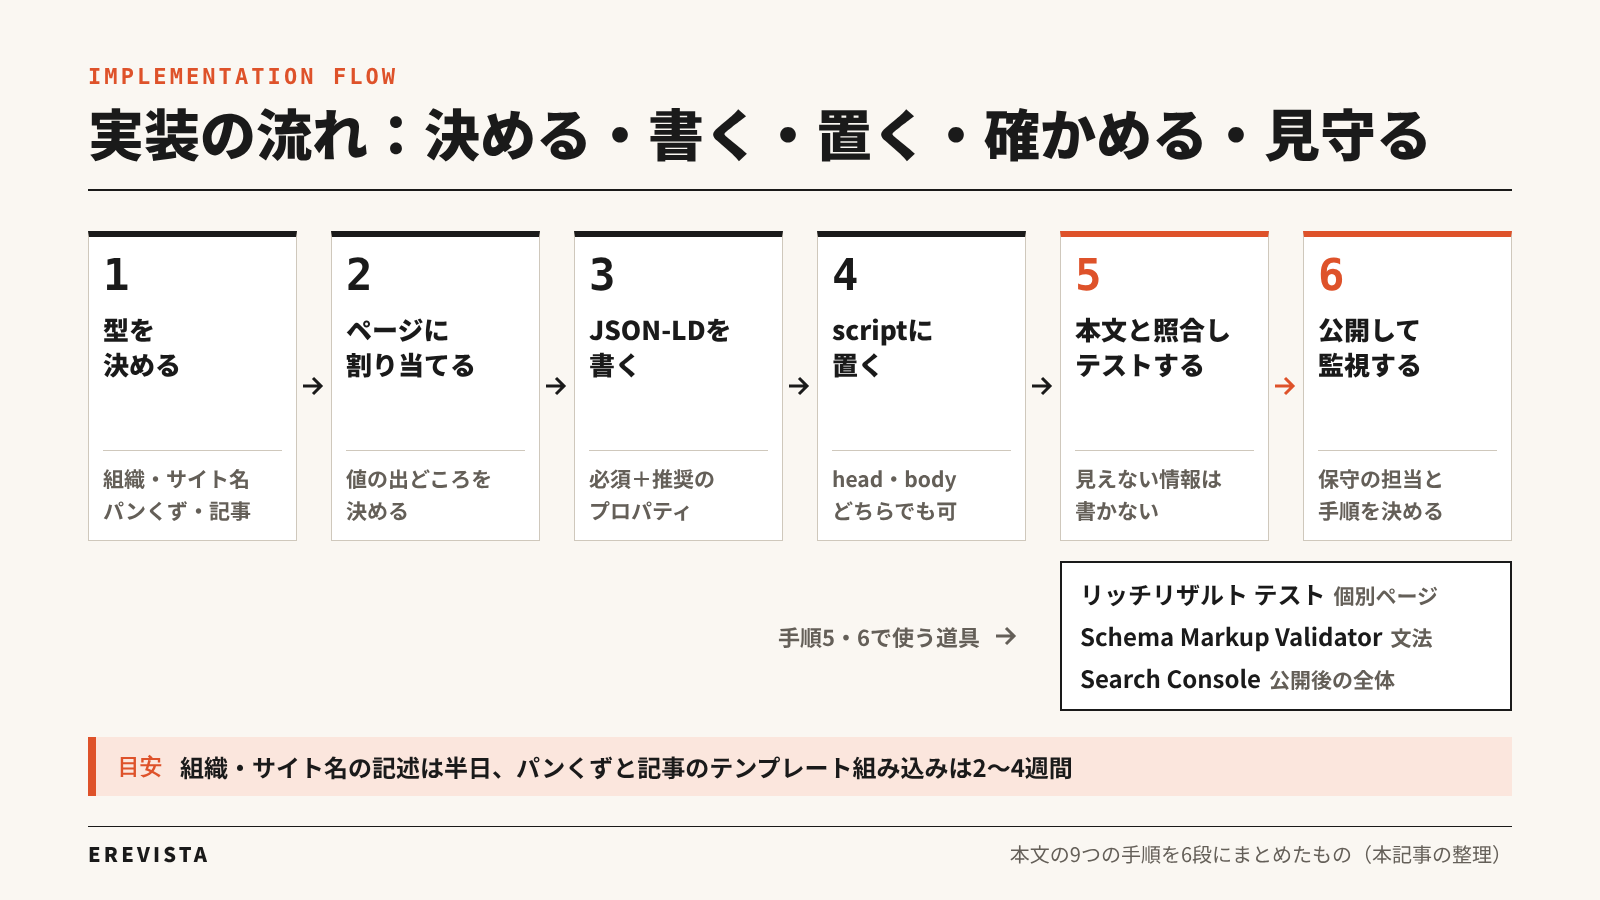
図:構造化データの実装手順(本記事の整理)
9つの手順
- 型を決める:前章の表から選ぶ。最初は組織、サイト名、パンくずリスト、記事の4つに絞る
- ページに割り当てる:組織とサイト名はトップページ1か所、パンくずは全ページ、記事は記事テンプレート、と一覧にする
- 値の出どころを決める:社名、住所、著者名、日付を本文と同じデータから出力する
- JSON-LDを書く:Googleの各型の文書にある必須と推奨のプロパティを埋める
- 置く:HTMLのhead要素またはbody要素の中に、type属性がapplication/ld+jsonのscript要素として置く
- 本文と照合する:値が同じページに表示されている文言と一致しているかを目で確かめる
- テストする:リッチリザルト テストで必須プロパティの不足と構文エラーを、Schema Markup Validatorで文法を確かめる
- 公開して監視する:数日〜数週間後にSearch Consoleの「拡張機能」や「ショッピング」のレポートで有効と無効の件数を見る
- 保守の手順を決める:社名、住所、代表者、ロゴ、著者の変更時に更新する担当と手順を文書にする
書き方の例:架空の製造業「株式会社サンプル精密」の組織情報
架空の会社「株式会社サンプル精密」(www.example.jp)のトップページに置く組織の記述の想定例で、社名、URL、所在地、電話番号はすべて架空です。本記事の書式ではコードを載せないため、プロパティと値の対応を表で示します。実際には、各行を「"name": "株式会社サンプル精密"」のように二重引用符とコロンで区切り、全体を波かっこで囲んで1つのscript要素に収めます。
| プロパティ | 値の例 | 補足 |
|---|---|---|
| @context | https://schema.org | 使う語彙の宣言。最初に書く |
| @type | Organization | 型の宣言。株式会社ならCorporation(その下位の型)も選べる |
| name | 株式会社サンプル精密 | サイト名(WebSiteのname)と同じ表記にする |
| alternateName | サンプル精密 | 通称や略称がある場合に書く |
| legalName | 株式会社サンプル精密 | 登記上の名称。nameと同じなら省いてよい |
| url | https://www.example.jp/ | 公式サイトのトップページ。組織を一意に識別する手がかり |
| logo | https://www.example.jp/img/logo.png | 112ピクセル角以上。クロールできるURL |
| description | 精密部品の受託加工と測定機器の販売を行う会社です。 | 会社概要ページの説明文と同じ内容にする |
| foundingDate | 1998-04-01 | ISO 8601形式(年-月-日) |
| numberOfEmployees | QuantitativeValue、value:120 | 従業員数。入れ子で書く |
| address | PostalAddress、streetAddress:〇〇1-2-3、addressLocality:〇〇市、addressRegion:〇〇県、postalCode:000-0000、addressCountry:JP | 会社概要ページの表記と一致させる |
| contactPoint | ContactPoint、telephone:+81-3-0000-0000、email:info@example.jp | 国番号つきの電話番号 |
| sameAs | 公式X、公式YouTube、公式LinkedInなどのURLを配列で | 同じ組織を指す外部ページのみ。他社や個人のページは入れない |
置き場所:headでもbodyでもよく、1ページに同じ型は1つ
Googleの入門ページは、JSON-LDをhead要素とbody要素のどちらのscriptタグにも埋め込める、としています。同じ型を同じページに2回書くとどちらが正しいか分からなくなるため1つにまとめますが、トップページに組織とサイト名、記事ページに記事とパンくず、と型の違う記述を並べるのは問題ありません。構造化データ ガイドラインは、重複ページがあれば正規ページだけでなく重複するすべてのページに同じ構造化データを入れることを勧めています。
本文との一致:見えない情報は書かない
Googleの入門ページは、ユーザーが閲覧しているページ画面に表示されない情報の構造化データは「その情報が正確であっても追加しないでください」と述べています。資本金のように本文に載せていない情報を構造化データだけに書くのは、この原則に反します。一致を保つ方法として堅いのは、本文と構造化データを同じデータから出力することです。更新漏れが起きやすいのは、記事のdateModified、商品の価格、求人のvalidThroughで、本文を直したのに構造化データの日付が古いままという状態は、機械には矛盾として映ります。
CMS・プラグイン・タグマネージャーで入れる場合の注意
出力方法は、テンプレートに直接書く、コンテンツ管理システム(CMS)のプラグインや拡張機能に生成させる、タグ管理ツールでJavaScriptから挿入する、の3つです。GoogleのJavaScriptで構造化データを生成する方法の文書(2025年12月18日の版)は、タグ管理ツールとカスタムJavaScriptの両方に触れています。どちらでも、Google検索がページをレンダリングする時点でDOM(ブラウザが組み立てたページの構造)内に有効な構造化データがあれば認識し、処理する、とあります。
ただし同じ文書には、動的に生成されたマークアップによってGoogleショッピングのクロールの頻度と信頼性が低下する可能性がある、という注意書きもあります。プラグインに任せる場合は、同じ型が二重に出力されていないか、初期値(authorに「admin」、logoにテーマの画像など)が残っていないかを公開後に見てください。個別の製品は確認していないため、製品名は挙げません。
技術的な前提:クロールできること
ガイドラインの技術要件には、Googlebotがアクセスできるように、robots.txtやnoindexなどで構造化データのあるページを遮らないことが含まれます。こうした土台の点検は、SEO内部対策の進め方の記事にまとめているので、先にそちらを確認してください。
構造化データのチェック・テスト:リッチリザルト テスト、Schema Markup Validator、Search Console
構造化データの確認では、リッチリザルト テスト、schema.orgのSchema Markup Validator、Search Consoleのレポートの3つを使い分けます。前の2つは公開前後の個別ページの検証、Search Consoleは公開後のサイト全体の監視が役割です。
2つのテストツールの違い
| 比較項目 | リッチリザルト テスト | Schema Markup Validator |
|---|---|---|
| 提供元 | Google(Search Consoleヘルプに解説) | schema.org(Googleの旧「構造化データ テストツール」を基に提供) |
| 確かめること | Google検索のリッチリザルトとして有効か。必須プロパティの不足と、Googleが対応する型だけを対象にする | schema.orgの定義に照らして文法が正しいか。Googleが対応しない型も含めて全体を抽出する |
| 対応する書式 | JSON-LD、RDFa、microdata | JSON-LD 1.0、RDFa 1.1、Microdata |
| 入力 | URLまたはコード。ユーザーエージェントをスマートフォンかパソコンで選べる | URLまたはコード。JavaScriptで挿入されたデータも抽出する |
| 向いている場面 | 公開前の最終確認、Search Consoleのエラーの再現 | 設計段階での文法確認、Googleが対応しない型の点検 |
リッチリザルト テストの使い方
Search Consoleヘルプのリッチリザルト テストの解説によると、テストはJSON-LD、RDFa、microdataの3書式に対応し、URLを入力する方法とコードを貼り付ける方法があります。テストに使う端末の種類はスマートフォンとパソコンから選べ、初期値はスマートフォンです。
- 公開前なら「コード」を選んでJSON-LDを貼り付け、公開後はURLを入力して実行する
- 検出された型の一覧に、意図した型が出ているかを確かめる
- エラーまたは警告があれば各項目を展開し、直して再実行する
- プレビューは参考程度に見る。ヘルプは、プレビューどおりに表示されない場合がある、と断っている
Schema Markup Validatorで見ること
schema.orgの解説ページによると、Schema Markup Validatorはウェブページに埋め込まれたschema.orgベースの構造化データを検証するサービスです。JSON-LD 1.0、RDFa 1.1、Microdataを抽出し、構文の誤りを見つけます。Googleが以前提供していた構造化データ テストツール(SDTT)を基にしたもので、schema.orgに特化しているため他の@context(語彙の参照先)は読み込みません。リッチリザルト テストはGoogle対応の型だけを見るため、一覧にない型の文法を確かめたいときはこの検証ツールを使います。
Search Consoleの「拡張機能」と「ショッピング」のレポート
リッチリザルト レポートの概要によると、Googleがサイトで有効なマークアップを検出し、それが対応している型である場合に、型ごとのレポートがナビゲーションバーの「拡張機能」に表示されます。商品スニペットと販売者リスティングのレポートは「ショッピング」の中です。各アイテムは、重大な問題がなくリッチリザルトとして表示できる「有効」と、表示を妨げる重大な問題がある「無効」に分かれます。ヘルプは、レポートが検出されるすべてのアイテムを網羅したものではない、とも断っています。
エラー・警告・無効の読み方と、合格しても表示されない理由
リッチリザルト テストの「エラー」とSearch Consoleの「無効」は、多くの場合、必須プロパティの欠落か構文の誤りで、そのアイテムはリッチリザルトの候補から外れます。「警告」は推奨プロパティの不足などで候補からは外れませんが、ガイドラインにあるとおり推奨プロパティが多いほど表示される検索結果の質は高くなります。エラーと無効をゼロにすることが先で、警告はページの重要度に応じて埋めます。
テストの合格は「候補になった」ことを意味し、「表示される」ことを約束しません。
よくあるエラーとガイドライン違反:手動による対策を避ける書き方
構造化データの問題は、ツールが見つけられる技術的なエラーと、ツールでは見つけられない品質ガイドライン違反の2種類に分かれます。後者は手動による対策の対象になり、該当ページのリッチリザルトが止まります。順位には影響しませんが、再審査には数日から数週間かかります。
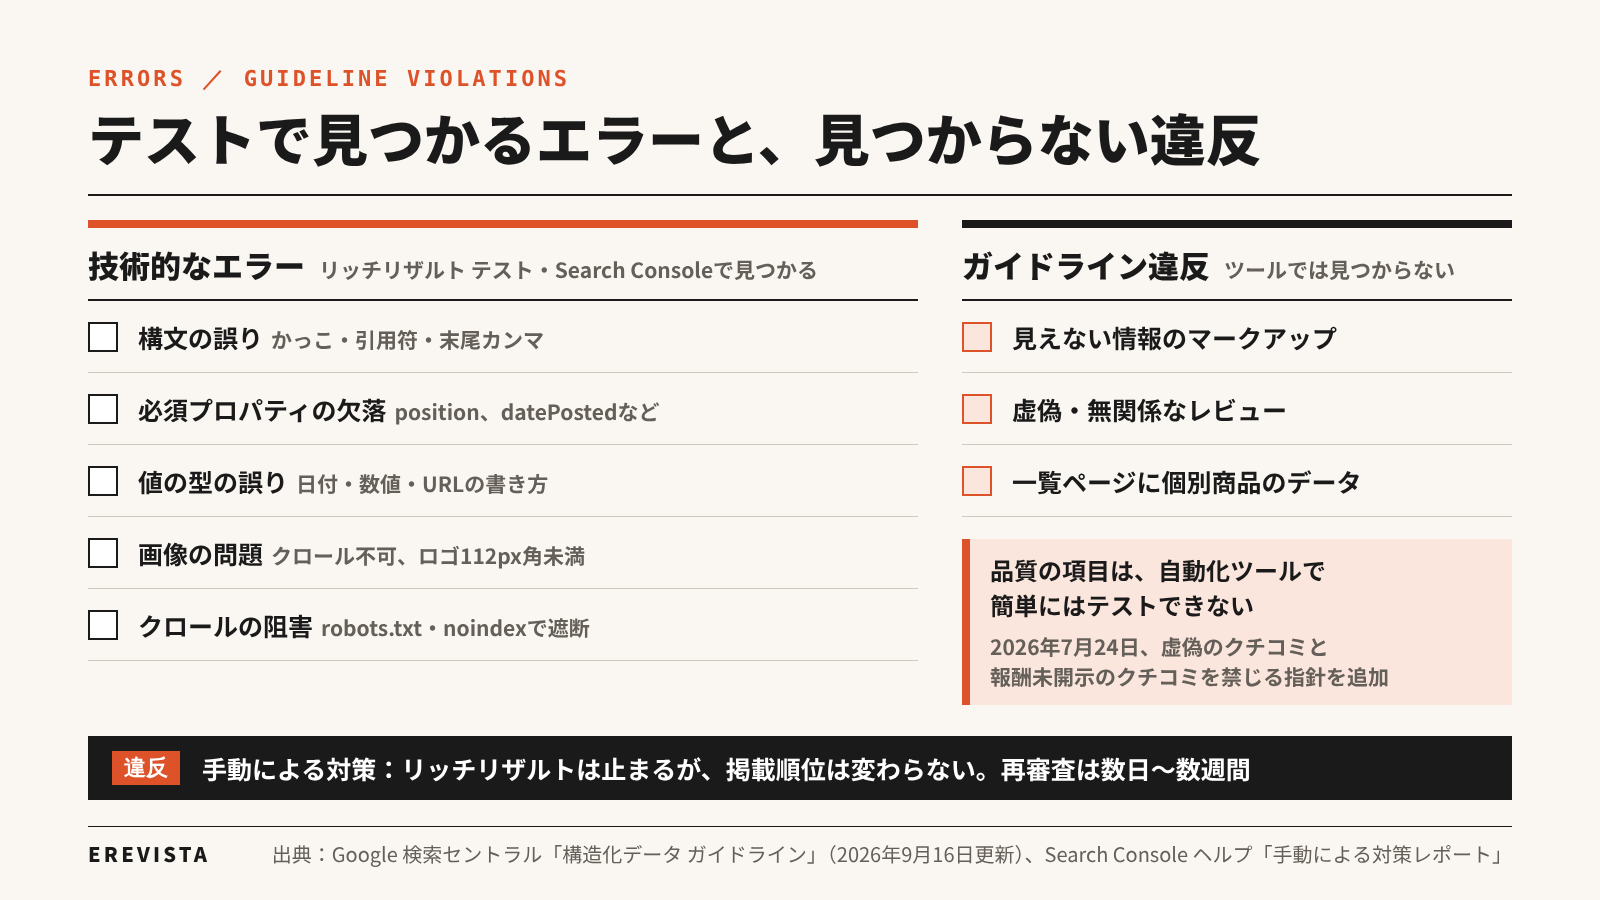
図:構造化データのエラーとガイドライン違反のチェックリスト(Google 検索セントラルとSearch Consoleヘルプをもとに作成)
技術的なエラー:テストで見つかる5つ
- 構文の誤り:かっこや引用符の閉じ忘れ、末尾のカンマ、全角の記号。JSON-LD全体が読まれなくなる
- 必須プロパティの欠落:パンくずのposition、求人のdatePostedなど。アイテムが「無効」になる
- 値の型の誤り:日付をISO 8601以外の書き方にする、数値を文字列にする、URLを相対パスで書く
- 画像の問題:logoやimageのURLがクロールできない、記事の画像が50,000ピクセル未満、ロゴが112ピクセル角未満
- クロールの阻害:構造化データを置いたページ自体がrobots.txtやnoindexで遮られている
直したら再テストし、Search Console側は次のクロール後にアイテムの状態が更新されるのを待ちます。
品質ガイドライン違反:ツールでは見つからないもの
前章までに引用した9月16日版の構造化データ ガイドラインは、品質に関するガイドラインは自動化ツールで簡単にテストできない、と前置きしたうえで、次の項目を挙げています。
| 項目 | ガイドラインの記述 | 企業サイトで起きやすい例 |
|---|---|---|
| コンテンツ | 最新の情報を提供する。自分またはユーザーが生成したオリジナルのコンテンツを提供する | 移転前の住所、退任した代表者名が構造化データに残る |
| 見えない内容 | ページの読者に表示されないコンテンツをマークアップしない | 本文にない資本金や受賞歴を構造化データだけに書く |
| 無関係・誤解 | 関連性がないコンテンツや誤解を招くコンテンツ(虚偽のレビュー、ページの内容と関係のないコンテンツなど)をマークアップしない | 自社で書いた感想をreviewとして付ける。商品がないページにProductを置く |
| 関連性 | 構造化データはページ コンテンツを正確に表している必要がある | 一覧ページに個別商品の価格を書く |
| 完全性 | 必須プロパティがないアイテムはリッチリザルトに表示されない。推奨プロパティが多いほど検索結果の質が高くなる | 必須だけ埋めて推奨を空のまま放置する |
| 場所 | 内容を記述するページに実装する。重複ページにも同じ構造化データを入れる | 全ページに組織の全情報をコピーする |
| 具体性 | schema.orgで定義されている最も具体的で適切なタイプとプロパティ名を使う | すべてをThingやWebPageで済ませる |
| 画像 | 指定する画像URLは、クロールして登録できるものであること | ログインが必要なストレージの画像URLを書く |
クチコミについては、2026年7月24日に、虚偽のクチコミと、報酬が伴うことが開示されていないクチコミを禁じるガイドラインが加わりました。第三者の評価を載せるときは、どこから集めた評価かを本文でも示しておくのが本記事の提案です。
違反が見つかったあと:手動による対策と再審査
Search Consoleヘルプの手動による対策レポートの解説によると、手動による対策とはGoogleの担当者が行う措置です。サイトのページを目視で審査し、Googleのスパム関連のポリシーに沿っていないと判断した場合に実施されます。項目の一つに「構造化データに関する問題」があり、ページの一部のマークアップでガイドラインに違反する手法が使われていると見られる場合に適用されます。
解除するには、違反しているマークアップを更新または削除したうえで、レポートの「審査をリクエスト」を選びます。ヘルプによれば、ほとんどの再審査は数日から数週間かかります。
月に1回の点検項目と、直す順番
直す順番は、手動による対策の確認、無効アイテムの修正、表記の一致、警告の解消です。点検では次の6つを見ます。
- Search Consoleの手動による対策レポートに、構造化データの項目が出ていないか
- 「拡張機能」と「ショッピング」のレポートで、無効なアイテムが前月より増えていないか
- トップページの組織とサイト名の記述をリッチリザルト テストにかけ、エラーがないか
- 会社概要の表記(社名、住所、代表者、電話番号)と、組織の記述の値が一致しているか
- 直近に公開した記事3本の記事の記述で、著者名と日付が本文と一致しているか
- プラグインやテーマの更新後に、同じ型が二重に出力されていないか
よくある質問(FAQ)
構造化データを入れると順位に効きますか?
順位に効くという根拠はありません。順位への効果を述べた記述は本記事で開いたGoogleの文書になく、違反で手動による対策が行われた場合でも「掲載順位には影響しません」と明記されています。変わるのは順位ではなく、リッチリザルトの候補になるかどうかです。
JSON-LDとmicrodataは、どちらを使うべきですか?
新しく実装するならJSON-LDです。Googleは「実装と管理を最も容易に行うことができる」理由でJSON-LDを勧めており、本文のHTMLを触らずに追加と修正ができます。microdataで書かれた既存のマークアップにエラーがなければ、書き直しは不要です。
構造化データと非構造化データの違いは何ですか?
データ管理の用語としての「構造化データ」は、本記事で扱うウェブの構造化データとは別の意味です。Oracleの解説(2022年4月1日)では、構造化データは「あらかじめ定義され、期待されるフォーマットを使用したデータ」、非構造化データは「定義がない」データ(文章、画像、音声など)とされています。ウェブの構造化データは、ページにschema.orgの定義済みの項目を添える作業です。
AI検索に引用されるために、構造化データは欠かせませんか?
欠かせない条件ではありません。Googleの生成AI向けガイドには「生成 AI 検索に構造化データは必要ありません」という一文があります。Ahrefsが2026年5月に出した1,885ページの追跡調査でも、JSON-LDの追加によるAI引用の増加は確認されませんでした。入れる理由は情報の正確さと、リッチリザルトの候補になることです。
FAQPageのマークアップは今も入れる価値がありますか?
Google検索での表示は得られません。FAQ向けの拡張表示は2026年5月7日以降は表示されず、6月15日に文書も削除されました。既存のマークアップを急いで消す必要はありませんが、新しく追加する理由もなく、質問と答えは本文として充実させるのが得策です。
構造化データのチェック・テストはどこでできますか?
個別ページはリッチリザルト テスト、schema.orgの文法はSchema Markup Validator、公開後のサイト全体はSearch Consoleの「拡張機能」と「ショッピング」のレポートが受け持ちます。リッチリザルト テストはURLとコードの両方を受け付けます。
エラーが出たらどうなりますか?
エラー(Search Consoleでは「無効」)のあるアイテムは、リッチリザルトの候補から外れます。必須プロパティの欠落や構文の誤りが主な原因で、直して再テストすれば解消します。通常の検索結果からページが消えることはなく、手動による対策の場合も順位は動きません。
CMSのプラグインで入れても大丈夫ですか?
大丈夫です。GoogleはタグマネージャーやJavaScriptで生成した構造化データも、レンダリング時にDOM内にあれば処理すると説明しています。注意点は、同じ型が二重に出力されていないか、初期値のままの著者名やロゴが残っていないか、商品データを動的に生成していないかの3つです。
何から入れるべきですか?
トップページの組織とサイト名の記述からです。会社の事実とサイト名を1か所で宣言でき、半日程度で済みます。次に全ページのパンくず、記事と著者ページのプロフィール ページへ進み、商品、拠点、求人、動画の型は事業に応じて加えます。
まとめ:構造化データは「AIのため」ではなく「事実を正確に伝えるため」に入れる
構造化データは、順位やAI引用を動かす装置ではなく、自社の事実を機械にも人にも同じ形で伝えるための記述であり、リッチリザルトの候補になるための前提です。
- 構造化データは、ページの情報を標準化した形式で記述したデータ。語彙はschema.org(826の型、1,540のプロパティ)、書式は3つで、GoogleはJSON-LDを推奨
- Googleの文書が認める役割は、内容の認識と25種類のリッチリザルトの候補になること。表示の保証も順位への効果も書かれていない
- Googleは「生成 AI 検索に構造化データは必要ありません」と明記。Ahrefsの1,885ページの調査でも、追加によるAI引用の増加は確認されなかった
- 普及率は調査によりJSON-LDが30.9%(ドメイン)、41%(ページ)、56.3%(サイト)。多くはCMSの自動出力で、正確さで差がつく
- 企業サイトの優先順位は、組織とサイト名、パンくず、記事とプロフィール ページの順。FAQPageと日本のEventは表示が期待できない
- 公開前にリッチリザルト テストとSchema Markup Validator、公開後はSearch Consoleで監視し、本文との一致を月1回点検する
最初にやることは、自社のトップページをリッチリザルト テストにかけ、組織とサイト名の記述が検出されるか、社名とロゴが会社概要の表記と一致しているかの確認です。記事の中身をどう作るかは、コンテンツSEOの基本と記事の作り方で扱っています。
構造化の次に点検する、残り3つの条件をまとめた資料
本記事で扱った「構造化」は、EREVISTAの資料「【AIO・LLMO】AIが“答え”を出す時代、その答えに選ばれているか」が挙げる引用の4条件の一角です。残る3つ、すなわちエンティティがはっきりしているか、第三者が語っているか、一次情報があるかを同じ資料のチェック欄で確かめると、構造化データを整えたあとに何が足りないかが見えます。資料の「最初の90日」は、可視化(30日まで)、実体を作る(60日まで)、分布を作る(90日まで)の3段で、本記事の見方では構造化データの実装は2段目に当たります。
出典・参考資料
記事内のデータは2026年10月25日時点で確認したものです。
- Google 検索セントラル「構造化データ マークアップの仕組みについて」(最終更新2025年12月18日)
- Google 検索セントラル「Google 検索上の構造化データ ガイドライン」(最終更新2026年9月16日)
- Google 検索セントラル「Google 検索でサポートされている構造化データ マークアップ(検索ギャラリー)」(最終更新2026年10月19日)
- Google 検索セントラル「ドキュメントの最新の更新内容」(2026年10月25日閲覧。2026年5月8日・6月15日・2024年11月29日などの項)
- Google 検索セントラル「AI 機能とウェブサイト」(最終更新2025年12月31日)
- Google 検索セントラル「Google 検索の生成 AI 機能向けにウェブサイトを最適化する」(最終更新2026年10月9日)
- Google 検索セントラル「組織(Organization)の構造化データ」(最終更新2026年9月12日)
- Google 検索セントラル「記事(Article、NewsArticle、BlogPosting)の構造化データ」(最終更新2026年9月12日)
- Google 検索セントラル「パンくずリスト(BreadcrumbList)の構造化データ」(最終更新2026年9月12日)
- Google 検索セントラル「プロフィール ページ(ProfilePage)の構造化データ」(最終更新2026年9月12日)
- Google 検索セントラル「Product の構造化データについて」(最終更新2025年12月18日)
- Google 検索セントラル「商品スニペット(Product、Review、Offer)の構造化データ」(最終更新2026年9月12日)
- Google 検索セントラル「販売者リスティング(Product、Offer)の構造化データ」(2026年10月25日閲覧)
- Google 検索セントラル「ローカル ビジネス(LocalBusiness)の構造化データ」(最終更新2026年9月12日)
- Google 検索セントラル「求人検索用の求人情報(JobPosting)の構造化データ」(最終更新2026年9月12日)
- Google 検索セントラル「動画(VideoObject、Clip、BroadcastEvent)の構造化データ」(最終更新2026年9月29日)
- Google 検索セントラル「イベント(Event)の構造化データ」(最終更新2026年9月12日)
- Google 検索セントラル「サイト名」(最終更新2026年2月20日)
- Google 検索セントラル「JavaScript を使用して構造化データを生成する」(最終更新2025年12月18日)
- Google 検索セントラル「検索エンジン最適化(SEO)スターター ガイド」(最終更新2025年12月18日)
- Google 検索セントラル「Vidio が Google 検索を活用し、地域関連性の高いビデオ オンデマンド(VOD)コンテンツをインドネシアで拡大した方法」(2024年6月4日)
- Search Console ヘルプ「リッチリザルト テスト」(2026年10月25日閲覧)
- Search Console ヘルプ「リッチリザルト レポートの概要」(2026年10月25日閲覧)
- Search Console ヘルプ「[手動による対策] レポート」(2026年10月25日閲覧)
- Google 公式ブログ「Introducing schema.org: Search engines come together for a richer web」(2011年6月2日)
- schema.org「Schema.org(トップページ)」(2026年10月25日閲覧)
- schema.org「About Schema.org」(2026年10月25日閲覧)
- schema.org「Organization of Schemas」(バージョン30.1、2026年9月16日)
- schema.org「Schema.org Releases」(2026年9月16日)
- schema.org「Thing」(バージョン30.1、2026年9月16日)
- schema.org「Schema Markup Validator」(2026年10月25日閲覧)
- W3C「JSON-LD 1.1」(2020年7月16日)
- W3C「RDFa Core 1.1 – Third Edition」(2015年3月17日)
- WHATWG「HTML Living Standard — 5 Microdata」(2026年10月22日更新)
- Web Data Commons「Web Data Commons – RDFa, Microdata, Embedded JSON-LD, and Microformats Data Sets」(2024年10月抽出、2026年10月25日閲覧)
- Web Data Commons「Statistics of the October 2024 extraction」(2024年10月抽出)
- HTTP Archive「Web Almanac 2024: Structured Data」(2024年11月11日)
- W3Techs「Usage Statistics of Structured Data Formats for Websites, October 2026」(2026年10月25日)
- W3Techs「Technologies Overview(調査方法)」(2026年10月25日閲覧)
- Ahrefs「We Tracked 1,885 Pages Adding Schema. AI Citations Barely Moved.」(2026年5月11日)
- Microsoft Advertising Blog「Optimizing Your Content for Inclusion in AI Search Answers」(2025年10月8日)
- Search Engine Journal「Google Drops FAQ Rich Results From Search」(2026年5月10日)
- OpenAI「Overview of OpenAI Crawlers」(2026年10月25日閲覧)
- OpenAI Help Center「Publishers and Developers – FAQ」(2026年10月25日閲覧)
- OpenAI Developers「Products – Agentic Commerce(商品フィードの仕様)」(2026年10月25日閲覧)
- Oracle「構造化データ型と非構造化データ型の比較」(2022年4月1日)