


SEO内部対策とは?やるべき施策と優先順位、チェックリスト
SEO内部対策とは、Googleがページを発見でき、内容を正しく読み取れ、訪れた人が快適に閲覧できるように、自社サイトの内側を整える施策のことです。記事の中身を書く仕事や、他のサイトからリンクを集める活動とは別の、サイトの土台にあたる部分です。
土台に不具合があると、どれほど良い記事を公開しても検索結果には出ません。Googleが検索に出るための最低条件として挙げている技術要件は、3つだけです。その一方で、点検ツールが大量に出す指摘の多くは、急いで直さなくてもよいものです。
この記事は、制作会社や社内のエンジニアと組んでサイトを動かしている、マーケティング担当の方と、その責任者の方に向けたものです。根拠には、Google
検索セントラルとSearch
Consoleヘルプの記載を使い、施策を3つの層に分けて説明します。扱うのは、確認方法、直し方、優先順位、チェックリスト、エンジニアへの依頼の書き方、そしてAI検索とのつながりです。
目次
- SEO内部対策とは?テクニカルSEO・オンページSEOとの関係
- 何から直すか:内部対策の優先順位と、その理由
- 第1層(クロールとインデックス):検索に出られる状態を保つ
- 第2層(理解):ページの内容を正しく伝える
- 第3層(体験):速さ、モバイル、安全性を整える
- 順位に関係するもの、しないもの:Googleの説明を整理する
- 内部対策チェックリスト25項目と、確認に使うツール
- よくある失敗:リニューアル後に起きやすい5つの事故
- エンジニアへの依頼の仕方:チケットに書く5つの要素
- AI検索と内部対策:AIによる概要・AIモードに出るための技術条件
- よくある質問(FAQ)
- まとめ:内部対策は「出られる・伝わる・快適」の順に整える
- 出典・参考資料
内部対策を始める前に:公式情報で確かめた5つの前提
- 検索に出るための技術要件は3つです。Googlebotがブロックされていないこと、ページがHTTP
200を返すこと、インデックス登録できる内容があることです。 - robots.txtは、検索結果からページを隠す手段ではありません。検索に出したくないページに付けるのはnoindexで、そのページのクロールは止めずにおきます。
- 順位づけに使われると明記されているのはCore Web
Vitalsです。「良好」の基準は、LCPが2.5秒以内、INPが200ミリ秒以内、CLSが0.1以下です。 - メタディスクリプションと構造化データは、順位を上げる手段としては説明されていません。前者はスニペットの材料、後者はリッチリザルトの対象になるための記述です。
- 指摘の件数と重要度は一致しません。Ahrefsが100万超のドメインを調べたところ、95.2%でリダイレクト、80.4%でalt属性の欠落が見つかりましたが、調査の筆者自身が、リダイレクトは通常心配するものではないと書いています。
SEO内部対策とは?テクニカルSEO・オンページSEOとの関係
内部対策とは、検索エンジンと利用者の両方に向けて、自社サイトの内側を整える施策の総称です。「テクニカルSEO」と「オンページSEO」は、その中身を2つに分けた呼び方だと考えると整理できます。
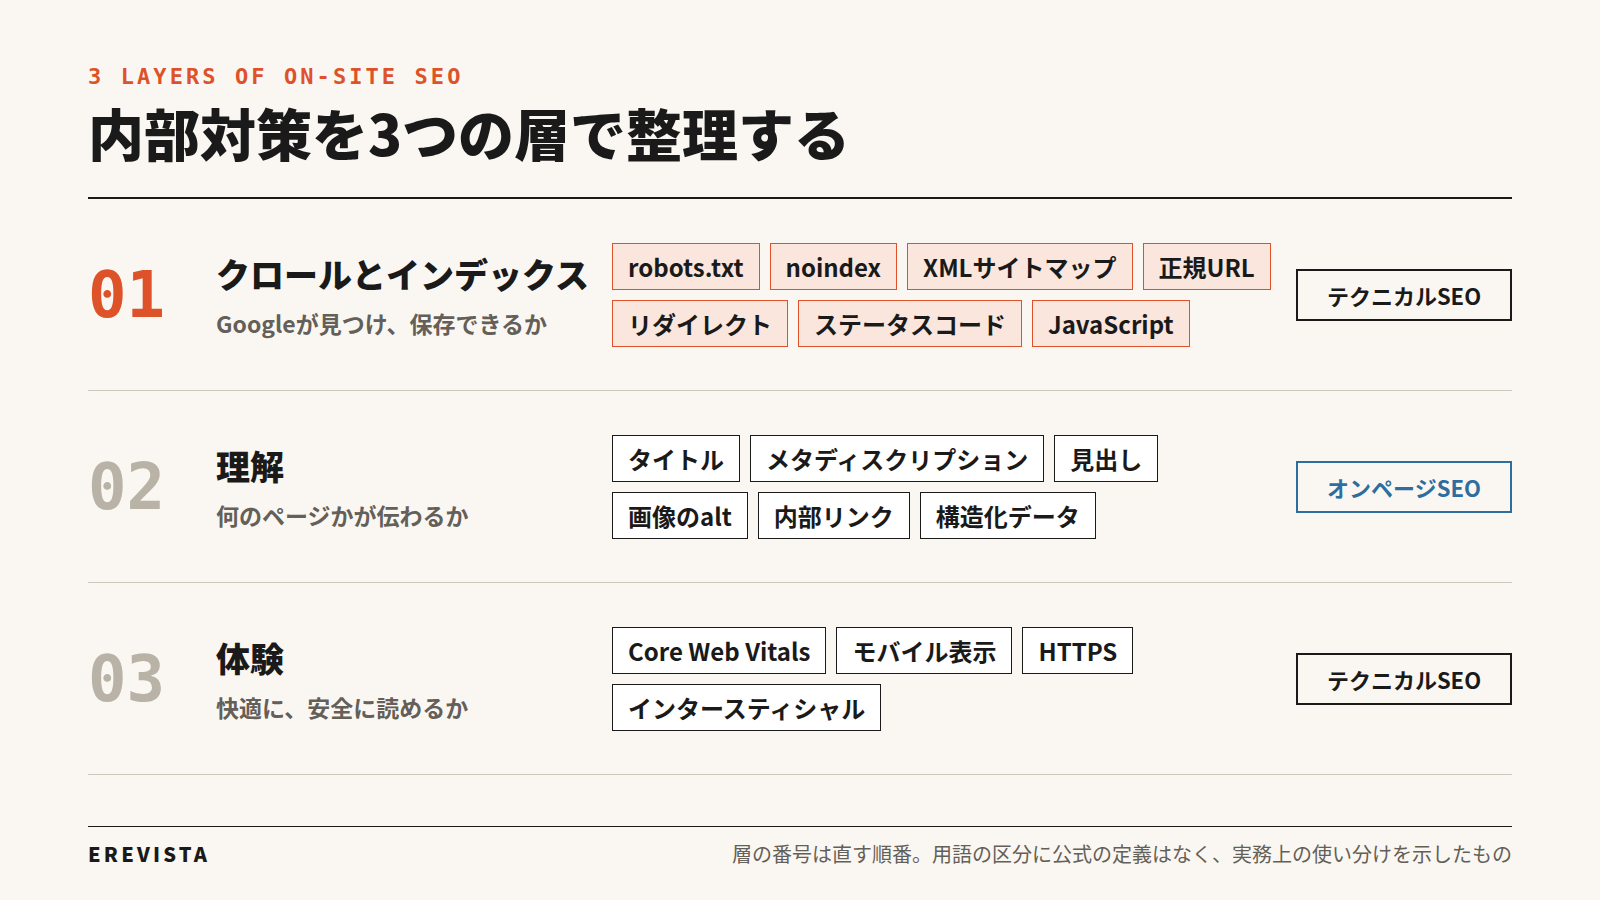
図:内部対策の3つの層と、テクニカルSEO・オンページSEOの対応(用語の区分は実務上の使い分け)
内部対策が扱う範囲
対象は、自社で直接変更できるものに限られます。サーバーの応答、URL、HTMLのタグ、リンクの張り方、表示速度などです。Googleは検索の流れを、クロール、インデックス登録、検索結果の表示という3段階で説明しています。内部対策は、この3段階のどこでもつまずかない状態を作る仕事です。
同じページによれば、クロールの頻度や掲載順位を上げる目的でGoogleが金銭を受け取ることはありません。運営者が動かせるのは、サイトの側だけです。
3つの用語の違い
3つの言葉に公式の定義はなく、Googleのドキュメントもこの区分を使っていません。実務では、おおむね次のように使い分けられています。
| 用語 | 主な対象 | 代表的な作業 |
|---|---|---|
| 内部対策 | サイトの内側すべて | 下の2つを合わせたもの |
| テクニカルSEO | サイト全体の仕組み | robots.txt、サイトマップ、正規URL、リダイレクト、表示速度、HTTPS |
| オンページSEO | 個々のページの記述 | タイトル、見出し、メタディスクリプション、画像のalt、内部リンク |
日本語の「内部対策」は、英語圏でいうテクニカルSEOとオンページSEOをまとめて指す場合が多い言葉です。会議で話がかみ合わないときは、相手がどの作業を指しているのかを最初に聞いてください。
外部対策・コンテンツSEOとの境界
SEOは一般に、内部対策、外部対策、コンテンツの3領域で語られます。外部対策は他のサイトからリンクや言及を得る活動、コンテンツSEOはキーワード選びと記事の作成・改善です。どちらも別の記事で扱うため、本記事ではサイトの内側だけを見ます。
本記事の整理:3つの層
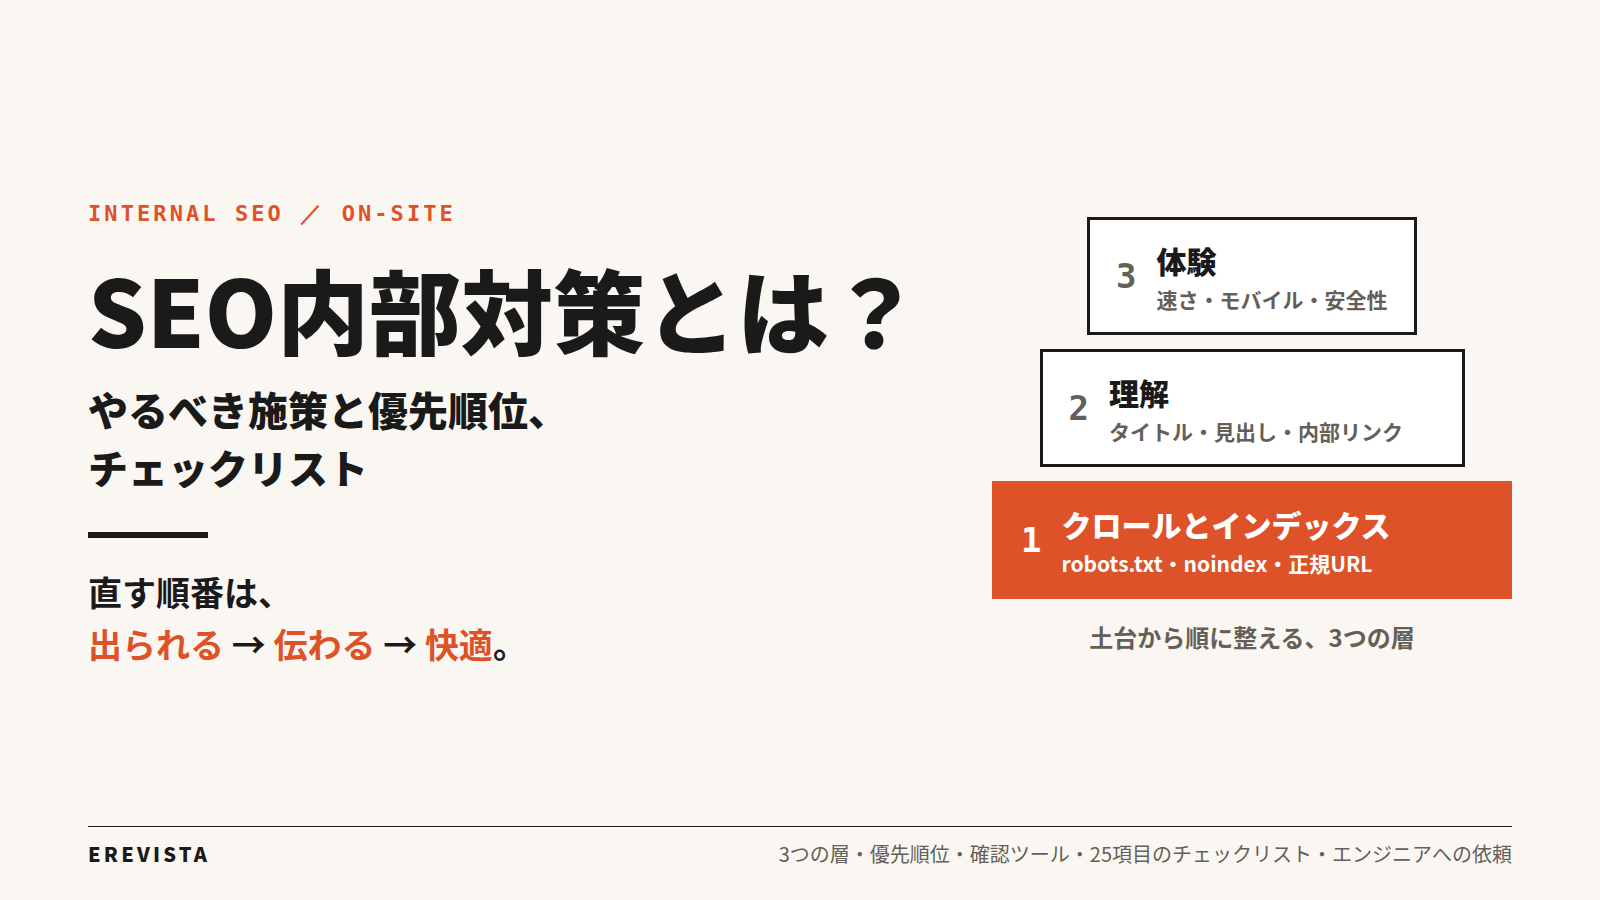
本記事では、内部対策を3つの層に分けます。
- 第1層「クロールとインデックス」:Googleがページを見つけ、保存できるか
- 第2層「理解」:各ページが、何のページなのかを明確に伝えているか
- 第3層「体験」:速さ、スマートフォンでの見やすさ、安全性が確保されているか
層の番号は、そのまま直す順番でもあります。
何から直すか:内部対策の優先順位と、その理由
優先順位は、第1層、第2層、第3層の順です。検索結果に出られないページは、タイトルや速度をどれだけ磨いても成果につながらないためです。
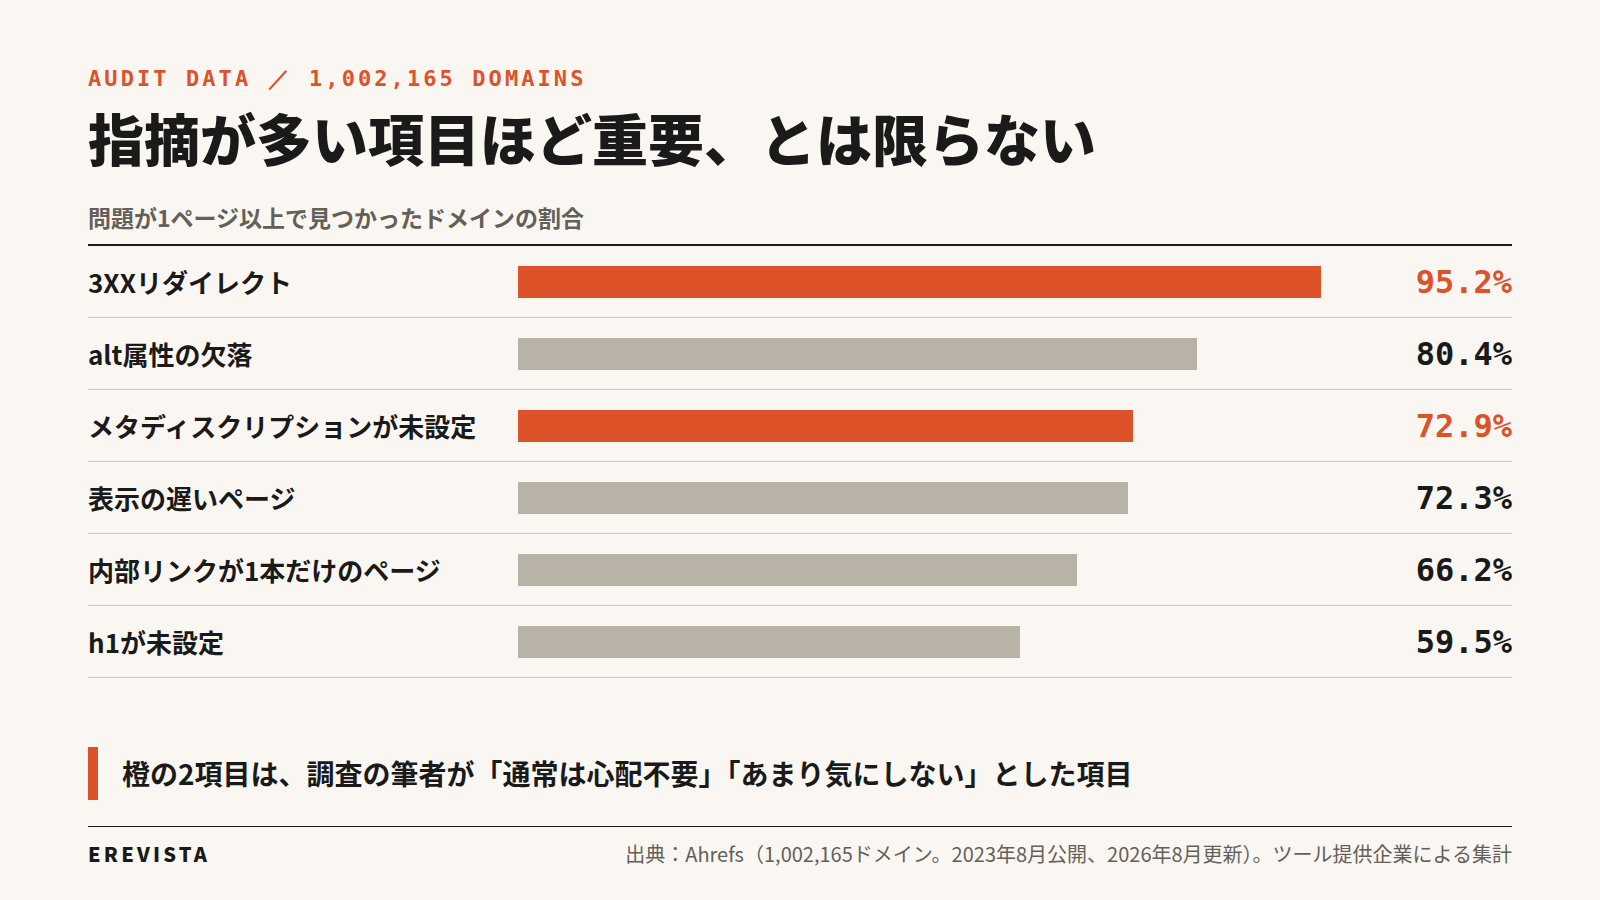
図:点検ツールで指摘されやすい項目(Ahrefsの調査をもとに作成。ツール提供企業による集計)
| 優先度 | 対象 | 代表的な症状 | 先に直す理由 |
|---|---|---|---|
| 1 | 第1層(クロールとインデックス) | 重要ページのnoindex、robots.txtでのブロック、404、誤った正規URL | 検索結果に出る資格そのものを失う |
| 2 | 第2層(理解) | タイトルの重複、主題の分からない見出し、内部リンクの不足 | 出ていても、何のページかが伝わらない |
| 3 | 第3層(体験) | 表示が遅い、スマートフォンで崩れる、HTTPのまま | 順位への影響は限定的だが、訪問後の離脱につながる |
最優先は「検索結果に出られない」原因の解消
Googleは検索の技術要件として3点を挙げています。Googlebot(Googleのクローラー)がブロックされていないこと、ページが機能してHTTP
200を返すこと、インデックス登録できるコンテンツがあることです。この3点を欠いたページは、検索結果に出ません。
3点をそろえた先の登録までは約束されていない、という注記も添えられています。それでも、ここが崩れていれば第2層と第3層の作業は成果を生みません。
次に、売上に近いページから「理解」を整える
第2層は、全ページを一度に直さなくて構いません。サービス紹介、料金、事例、問い合わせにつながる記事など、成果に近いページから着手します。対象を20〜30ページに絞ると、エンジニアへの依頼も具体的になります。
「体験」は基準を下回るものから
第3層は、Search
Consoleで「低速」と判定されたページ群から手を付けます。速度の改善は工数が大きくなりやすい作業です。基準を満たしたあとの磨き込みは、後回しで問題ありません。
指摘の数が多い項目が、重要とは限らない
点検ツールを使うと、数百件の指摘が並ぶことがあります。Ahrefsは自社の監査ツールで1,002,165ドメインを調べ、問題が1ページ以上で見つかったドメインの割合を公表しています(公開は2023年8月、最終更新は2026年8月。集計時期は書かれていません)。
- 3XXリダイレクト:95.2%
- alt属性の欠落:80.4%
- メタディスクリプションが未設定または空:72.9%
- 表示の遅いページ:72.3%
- 内部リンクが1本しかないページ:66.2%
- h1が未設定または空:59.5%
ほぼすべてのサイトに当てはまる項目が上位に並びます。調査の筆者は、リダイレクトは通常心配するものではなく、メタディスクリプションの欠落もあまり気にしないと書いています。集計したのがツールの提供企業である点も、割り引いて読んでください。判断の基準は件数ではなく、どの層の問題か、どのページで起きているか、の2点です。
第1層(クロールとインデックス):検索に出られる状態を保つ
第1層の目的は、検索結果に出したいページがGoogleに見つかり、インデックスと呼ばれる検索用の保管庫へ登録される状態を保つことです。不具合は、発見、クロール、レンダリング、登録のいずれかの段階で起きます。ここでは10の項目を、役割、確認方法、直し方の順に見ていきます。
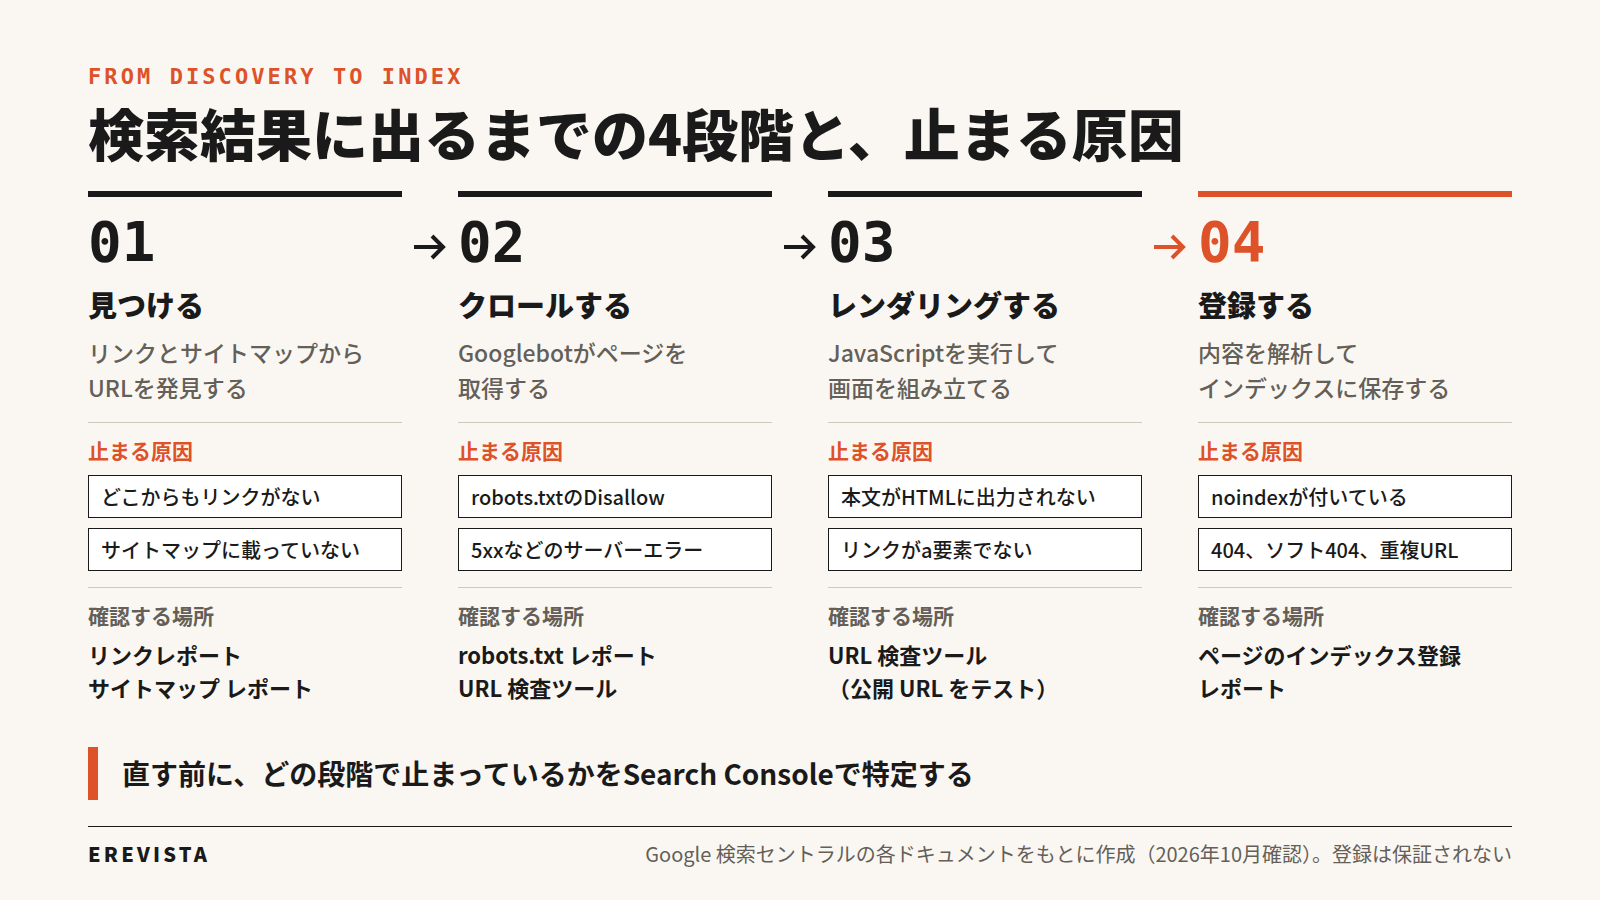
図:発見からインデックス登録までの流れと、止まりやすい原因(Google
検索セントラルの各ドキュメントをもとに作成)
| やりたいこと | 使う手段 | 避ける手段 |
|---|---|---|
| 検索結果に出さない | noindex、パスワード保護 | robots.txtのDisallow |
| クロールの負荷や無駄を減らす | robots.txt | noindex |
| 重複するURLを1本にまとめる | 301リダイレクト、rel=”canonical” | robots.txt、noindex |
| URLを恒久的に変える | 301または308のリダイレクト | 一時的な302 |
| 新しいページを早く知らせる | XMLサイトマップ、内部リンク | なし |
robots.txt:クロールを制御するファイルで、非表示の手段ではない
robots.txtは、クローラーに「どのURLを取得してよいか」を伝えるテキストファイルです。置き場所はサイトの最上位で、URLは「ドメイン名/robots.txt」になります。Googleの解説は、主な用途をクローラーのトラフィックの管理とし、ウェブページをGoogleに表示させないための仕組みではない、と注意しています。
ブロックしたURLでも、他のページからリンクされていれば、説明文のない形で検索結果に出ることがあります。現状は、Search
Consoleの設定にあるrobots.txt
レポートで見られます。「Disallow:
/」の1行があると、サイト全体のクロールが止まります。公開中のサイトに残っていないかを最初に見てください。
noindex:検索結果に出さないページを指定する
noindexは、ページをGoogleの検索結果に表示させない指定です。書く場所は2つあり、HTMLのhead内(metaタグ)か、サーバーが返すHTTPヘッダー(X-Robots-Tag)です。
落とし穴が2つあります。まず、noindexのドキュメントにあるとおり、robots.txtでブロックしたページではnoindexが読み取られません。次に、必要なページに誤って付くと、そのページが検索結果から消えます。Search
Consoleの「ページのインデックス登録」レポートを開き、「URL に noindex
が指定されています」の一覧に、残したいURLが紛れ込んでいないかを調べます。
XMLサイトマップ:登録してほしいURLの一覧を渡す
サイトマップは、サイト内のページやファイルの情報をGoogleに伝えるファイルです。Googleの説明では、およそ500ページ以下で、内部リンクが行き届いた小さなサイトには必須でないとされています。大規模なサイトや、新しくて外部からのリンクが少ないサイトでは役に立ちます。
載せるのは、検索結果に出したいURLだけです。1ファイルの上限は50,000件、圧縮前で50MBです。作成のガイドを読むと、Googleはpriorityとchangefreqの値を無視し、lastmodは正確だと検証できる場合に使うことが分かります。
送信は、Search Consoleのサイトマップ
レポートで行い、ステータスが「成功」かどうかを見ます。送信しただけで、クロールと登録が確定することはありません。
正規URL(canonical):同じ内容のURLを1本にまとめる
正規URLとは、内容が重複する複数のURLのうち、Googleが代表として選ぶ1本のことです。httpとhttps、並べ替えや絞り込みのパラメータ、消し忘れたデモ環境などが原因で、同じ内容のURLは簡単に増えます。Googleは正規化の解説で、重複そのものは珍しくなく、スパム扱いにもならないと述べています。
ただし、代表にしたいURLは運営者が示しておくほうが安全です。指定方法のドキュメントは、リダイレクトとrel=”canonical”を強いシグナル、サイトマップへの掲載を弱いシグナルと位置づけています。サイト内のリンクも、正規URLへ向けるのが原則です。
確認にはURL 検査ツールを使います。「ユーザーが指定した正規
URL」と「Google が選択した正規
URL」が食い違っていれば、シグナルのどこかが矛盾しています。その場合は、canonical、リダイレクト、サイトマップ、内部リンクが同じURLを指すようにそろえます。
リダイレクト:URLを変えたら恒久的な転送で引き継ぐ
リダイレクトは、古いURLへのアクセスを新しいURLへ転送する設定です。Googleのドキュメントでは、恒久的なリダイレクト(301や308)なら検索結果に転送先が、一時的なリダイレクト(302など)なら転送元が表示されると整理されています。URLをずっと変えるのであれば、サーバー側の恒久的なリダイレクトが第一の選択肢です。
転送が何段も続く「リダイレクトチェーン」には上限があります。サイト移転のガイドに書かれた上限は、最大10ホップです。段数は5個未満、理想は3個以下に抑えるよう案内されています。設定したリダイレクトは、一般に1年以上は維持します。段数と種類(301か302か)は、ブラウザの開発者ツールで確かめられます。
ステータスコード:404、ソフト404、5xxを見分ける
ステータスコードは、サーバーがリクエストに返す3桁の応答です。Googleの解説では、404や410を返したURLは、登録済みであればインデックスから削除されます。5xx(サーバーエラー)はクロールのペースを落とさせ、くり返されるとURLが削除されます。
見落としやすいのがソフト404です。中身が空やエラー文なのに、200を返しているページを指します。存在しないページには404を、移転したページには301を返すよう直します。件数は、Search
Consoleのレポートにある「見つかりませんでした(404)」「ソフト
404」「サーバーエラー(5xx)」の各項目で把握できます。
描画にJavaScriptを使うページ:本文とリンクを読める形で出す
JavaScriptで画面を組み立てるサイトは、クロール、レンダリング、インデックス登録の3段階で処理されます。JavaScript
SEOの基本を読むと、レンダリングは順番待ちになる場合があると分かります。また、リンクとして検出されるのは、aタグのhref属性にURLを書いたものに限られます。
クリックの処理だけで画面を切り替えるボタンは、リンクとして扱われません。URL
検査ツールの「公開 URL
をテスト」でレンダリング後のHTMLを開き、本文とリンクが出力されているかを確認します。出力されていなければ、サーバー側での描画や、事前の描画(プリレンダリング)を検討します。
URLの付け方:意味のある単語をハイフンでつなぐ
URLは、内容が推測できる単語で作ります。URL構造のガイドが推奨するのは、長いID番号より意味のある単語を選ぶことと、単語の区切りをアンダースコアではなくハイフンにすることです。大文字と小文字は、別のURLとして扱われます。
すでに登録されているURLを、見た目を整える目的だけで変更する理由はありません。変更にはリダイレクトと内部リンクの張り替えが伴うためです。規則は、新しく作るページからそろえます。
多言語サイトのhreflang:相互に指定する
hreflangは、同じ内容の言語別・地域別ページをGoogleに伝える指定です。HTML、HTTPヘッダー、サイトマップの3通りで書けます。ローカライズ版のページに関する解説では、ページ同士が互いを参照していない指定は無視されるとされています。日本語だけのサイトには不要です。
クロールバジェットは、多くのサイトで気にしなくてよい
クロールバジェットとは、Googleがそのサイトでクロールできて、かつクロールする必要があるURLの集まりです。専用のガイドが対象にしているのは、重複のないページが100万以上あるサイトと、1万以上あって毎日更新されるサイトです。
それ以外のサイトは、サイトマップを最新に保ち、登録状況を定期的に見れば足りるとされています。Search
Consoleのクロールの統計情報レポートについても、1,000ページ未満のサイトなら使う必要はない、とヘルプが案内しています。
第2層(理解):ページの内容を正しく伝える
第2層の目的は、各ページが「何について書かれたページか」を、Googleと利用者の両方にひと目で伝えることです。対象は、タイトル、メタディスクリプション、見出し、画像、内部リンク、構造化データの6つです。
タイトル(title要素):ページごとに固有で、内容を言い切る
title要素は、検索結果に青字で出る見出し(タイトルリンク)の主な材料です。Googleのタイトルリンクの解説を読むと、材料はtitle要素だけではないと分かります。ページ上で目立つ大見出し、h1をはじめとする見出しタグ、og:titleのmetaタグ、リンクの文言も使われます。文字数の上限は示されていません。
書き換えが起きやすいのは、title要素の一部が空、内容が古い、不正確、定型文のくり返し、といった場合です。Ahrefsが検索上位10位以内の953,276ページを調べた分析(2021年11月公開)では、title要素と異なるタイトルが表示された割合は33.4%でした。そのうち50.76%では、h1が使われていました。5年前の海外の調査ですが、titleとh1の内容をそろえておく意味は読み取れます。
点検では、全ページのtitleを一覧に書き出し、重複しているものと、社名や定型文だけのものを探します。直すときは、そのページ固有の内容を先に書き、社名は短く添えます。
メタディスクリプション:順位ではなく、クリックのための要約
メタディスクリプションは、ページの内容を短くまとめたmetaタグです。Googleはスニペットの解説ページで、スニペット(検索結果の説明文)の主な材料はページの本文だとしています。メタディスクリプションが使われるのは、そちらのほうがページを適切に表している場合です。長さに制限はありません。
順位との関係を見ると、このページにも、Googleが対応するメタタグの一覧にも、順位づけに使うとは書かれていません。一覧にあるのは、スニペットに使用される場合もある、という説明です。順位を上げる手段ではなく、検索結果での見え方を整える手段だと捉えてください。
Ahrefsによる2020年の調査(2万キーワードの上位ページが対象)では、メタディスクリプションの62.78%が、検索結果では別の文に置き換わっていました。全ページに手書きしなくても構いません。成果に近いページから、ページ固有の要約を書いていきます。
見出し(h1〜h3):内容の区切りを示す
見出しは、ページの構成を示すHTMLの要素です。Googleが公開しているSEOスターターガイドには、見出しが順番どおりに使われていなくてもGoogle検索では問題にならず、理想的な見出しの数も存在しないとあります。
そのため、見出しタグの数や順番を機械的にそろえる作業は、優先度が高くありません。大事なのは、h1がページの主題を表し、h2とh3を拾い読みすれば全体が分かることです。文字を大きく見せるためだけに見出しタグを使っている箇所は、通常のテキストに戻します。
画像とalt属性:内容を言葉で補う
alt属性は、画像が何を表しているかを文字で伝える記述で、代替テキストとも呼ばれます。Googleの画像SEOのドキュメントは、画像の情報を伝えるうえで最も重要な属性が代替テキストだと述べています。CSSで背景として表示した画像は、インデックスの対象になりません。
内容を伝える画像はimg要素で配置し、何が写っているかを短い文で書きます。altにキーワードを並べ立てる書き方は、避けるべき例に挙げられています。区切り線のような飾りの画像にまで、説明を付けなくて構いません。
内部リンクとアンカーテキスト:重要なページへ言葉で導く
内部リンクは、同じサイトのページ同士をつなぐリンクです。Googleのリンクのドキュメントでは、リンクの用途が2つ挙げられています。ページの関連性の判断と、新しいページの発見です。検索に出したいページには、同じサイトの他ページから最低1本のリンクを張っておく、というのがGoogleの推奨です。
アンカーテキスト(リンクになっている文言)は、リンク先の内容を伝える手がかりです。「こちら」「詳細」ではなく、「料金プランの比較表」のように具体的に書きます。1ページに置くリンクの本数については、理想の値はないという立場です。
どこからもリンクされていないページは、孤立ページと呼ばれます。Search
Consoleにあるリンクレポートを開くと、サイト内から多くリンクされているページを順に見られます。重要なページが下位に沈んでいないかが、見るべき点です。
構造化データ:リッチリザルトの対象になるための記述
構造化データは、ページの情報を決まった形式で書き、検索エンジンに伝えるデータです。Googleの入門ドキュメントは、用途として内容の理解とリッチリザルト(評価の星や価格などが付いた検索結果)を挙げ、形式はJSON-LDを推奨しています。
同じドキュメントには企業の事例も載っています。構造化データのあるページのクリック率が25%高かった例(Rotten
Tomatoes)や、リッチリザルトが出たページのクリック率が82%高かった例(Nestlé)です。いずれも個別企業の結果で、同じ効果が出るとは限りません。
期待しすぎないための注意が3つあります。
- ガイドラインの冒頭に、構造化データを書いても検索結果に表示されるとは限らない、という注意書きがあります。
- 対応する種類は入れ替わります。「よくある質問」のリッチリザルトは、2026年5月7日を境にGoogleの検索結果へ出なくなりました(ドキュメントの更新記録、2026年5月8日の項)。
- 順位が上がると述べた箇所は、今回確認したドキュメントにはありませんでした。
実装後の検証には、リッチリザルト
テストを使います。URLかコードを入力すると、検出された項目とエラーが表示されます。会社情報を表すOrganizationやサイト名の構造化データ、サイトリンクとの関係は、ナレッジパネルとサイトリンクの記事にまとめています。
第3層(体験):速さ、モバイル、安全性を整える
第3層の目的は、検索から訪れた人が、待たされず、崩れのない画面で、安全に読める状態にすることです。この層でGoogleが数値の基準を示しているのは、Core
Web Vitalsです。
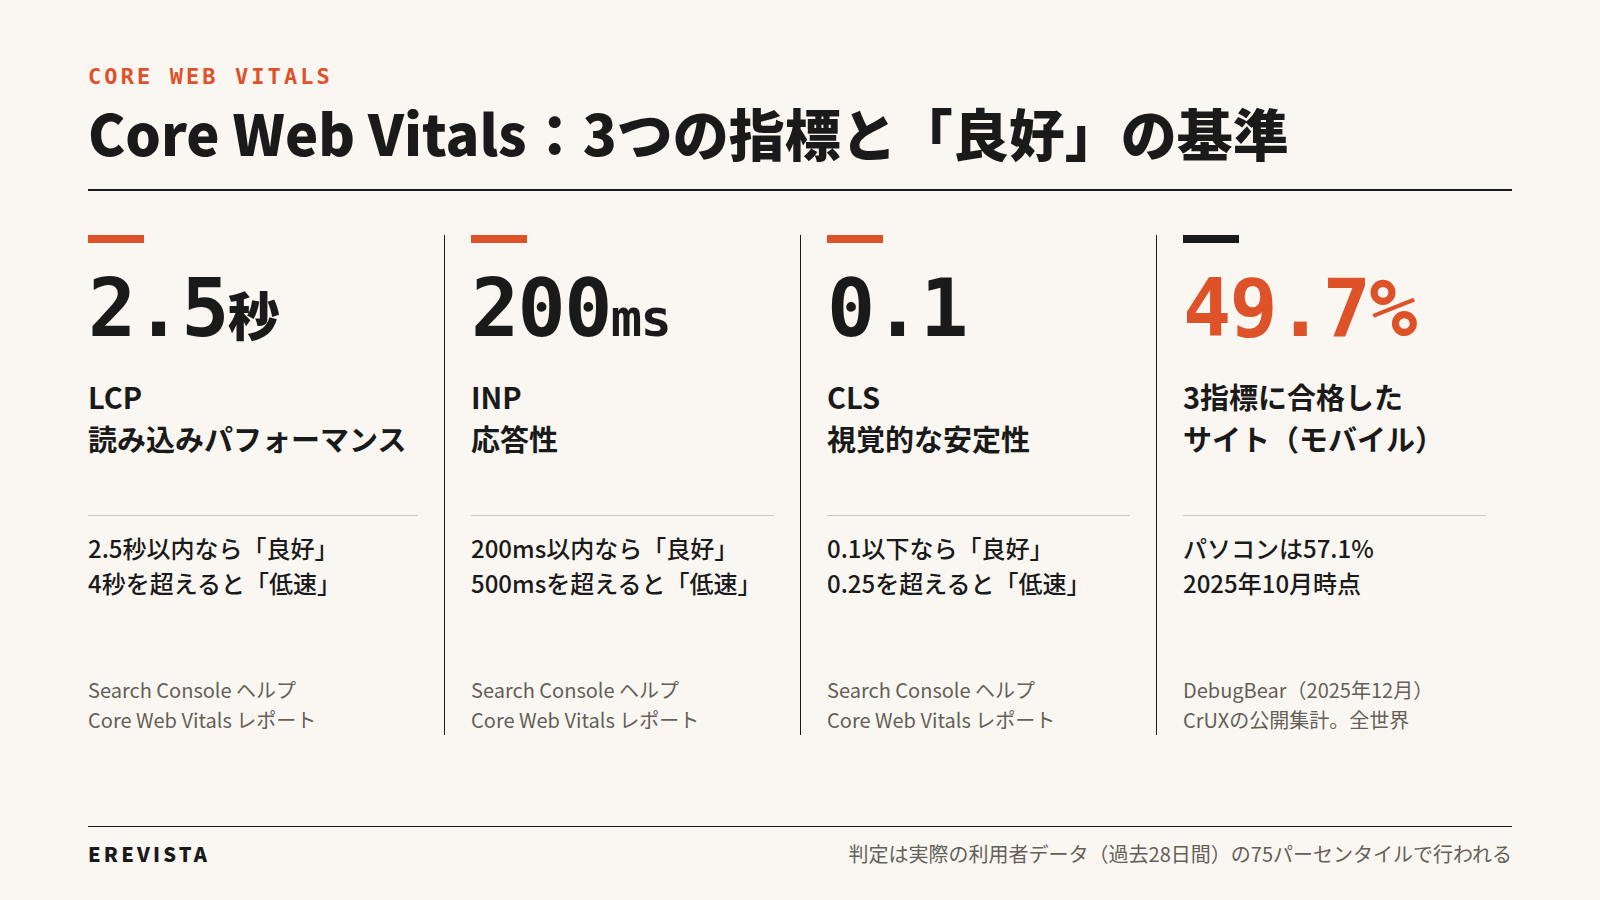
図:Core Web Vitalsの基準値と合格率(Search
Consoleヘルプ、DebugBearがまとめたCrUXの公開集計をもとに作成)
Core Web
Vitals:3つの指標と基準値
Core Web
Vitals(コアウェブバイタル)は、読み込みの速さ、操作への応答、表示の安定性を、実際の利用者のデータで測る3つの指標です。指標の意味はGoogleのドキュメント、3段階の区切りはSearch
Consoleヘルプの表記に従ってまとめます。LCPはLargest Contentful
Paint、INPはInteraction to Next Paint、CLSはCumulative Layout
Shiftの略です。
| 指標 | 測るもの | 良好 | 改善が必要 | 低速 |
|---|---|---|---|---|
| LCP | 読み込みパフォーマンス | 2.5秒以内 | 4秒以内 | 4秒超 |
| INP | 応答性 | 200ミリ秒以内 | 500ミリ秒以内 | 500ミリ秒超 |
| CLS | 視覚的な安定性 | 0.1以下 | 0.25以下 | 0.25超 |
世界全体で見ると、基準を満たすサイトは半数ほどです。表示速度の計測サービスを提供するDebugBearが、CrUX(Chromeの利用者データ)の公開集計をもとにまとめた記事(2025年12月)によると、2025年10月時点で3指標の評価に合格したサイトは、モバイルで49.7%、パソコンで57.1%でした。1年前は46.7%と55.3%です。海外を含む全体の数字で、日本だけの値ではありません。
測り方:Search
ConsoleとPageSpeed Insightsを使い分ける
サイト全体の傾向はSearch Console、個別ページの原因調査はPageSpeed
Insightsで見ます。Search ConsoleのCore
Web Vitals
レポートは、実際の使用状況データをもとに、似たページをURLグループにまとめ、「良好」「改善が必要」「低速」で示します。ヘルプでは「ウェブに関する主な指標」とも表記されています。
PageSpeed
Insightsは、URLを入力すると、過去28日間の実測データと、その場で計測したラボデータを表示します。合否は、実測データの75パーセンタイルで判定されます。ラボデータは原因の特定に役立つ一方、実際のボトルネックを捉えていないおそれもある、という注意が付いています。
改善の進め方:テンプレート単位で直す
速度の問題は、多くの場合、ページ単位ではなくテンプレート単位で起きます。記事ページ、一覧ページ、トップページといった型ごとに代表のURLを1つ選び、原因を調べます。容量の大きい画像、読み込みを妨げるスクリプト、あとから差し込まれるバナーは、よく見つかる原因です。
修正後にレポート上で検証を始めると、28日間の観測期間に入ります。結果がすぐには変わらないことを、関係者に先に伝えておきます。
モバイル:スマートフォン版が評価の基準になる
Googleは、スマートフォン用のクローラーで取得したモバイル版の内容を、インデックス登録と順位づけに使います。これをモバイルファースト
インデックスと呼びます。モバイルサイトの解説は、実装と維持が最も簡単な方法として、レスポンシブ
ウェブ デザインを挙げています。
注意したいのは、パソコン版にだけ存在する内容です。モバイル版で本文、構造化データ、titleを省いていると、その情報は評価の材料になりません。利用者が操作しないと読み込まれない本文も、避けるべきものに挙げられています。URL
検査ツールでクロール済みのページのHTMLを開き、省かれた本文がないかを見ておきます。
HTTPS:全ページを暗号化して配信する
HTTPSは、通信を暗号化してページを届ける方式です。Googleが示す体験面の自己点検の項目に入っており、同じ内容であればHTTPSのURLが正規URLとして優先されます。
Search ConsoleのHTTPS
レポートでは、登録済みのURLがHTTPSとHTTPのどちらで何件あるかを確認できます。HTTPSになっていない理由も表示されます。証明書が無効である、サイトマップがHTTPを参照している、などです。
インタースティシャルと安全性
インタースティシャルは、本文を覆い隠す全画面の表示です。Googleは専用のドキュメントで、ページ全体を覆う形をやめ、画面の一部だけを使うバナーへ替えるよう促しています。法律で義務付けられた同意や年齢確認の表示は、対象外です。
安全性は、Search Consoleのセキュリティの問題レポートで確認します。ハッキングされたコンテンツやマルウェアが検出されると、検索結果やブラウザに警告が出ることがあります。月に1回は開いて、検出がゼロであることを見ておきます。
順位に関係するもの、しないもの:Googleの説明を整理する
Googleが順位づけに使うと明記している内部対策の項目は、今回確認した範囲ではCore
Web
Vitalsです。メタディスクリプション、構造化データ、見出しの順番などは、順位を上げる要素としては説明されていません。
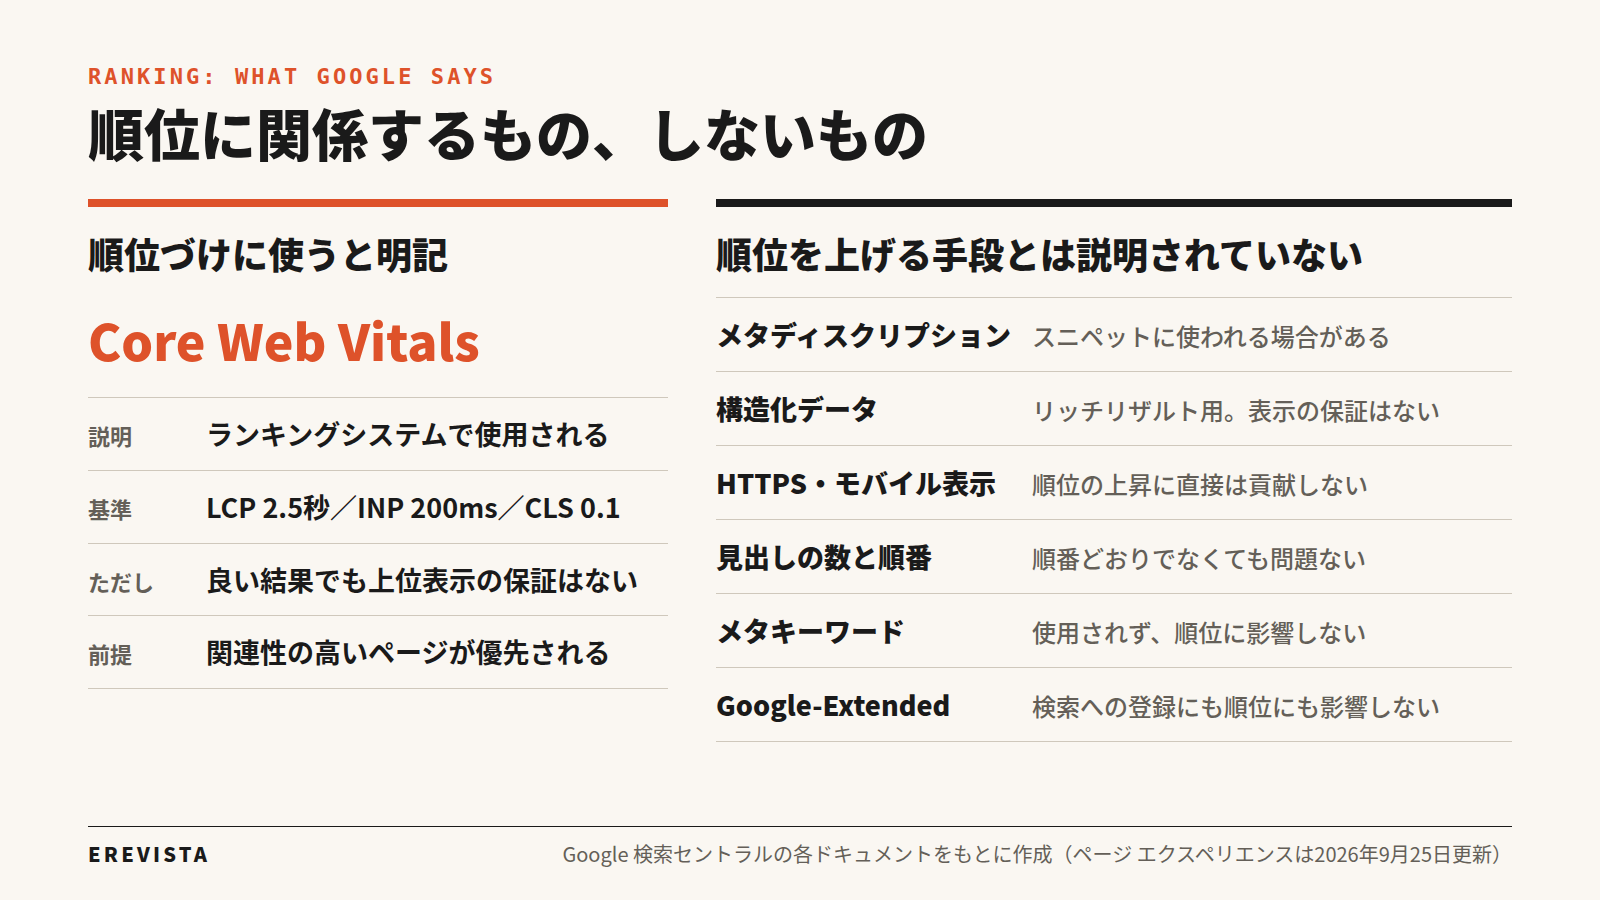
図:Googleのドキュメントが順位との関係をどう説明しているか(Google
検索セントラルをもとに作成)
| 項目 | Googleの説明 | 実務での扱い |
|---|---|---|
| Core Web Vitals | ランキングシステムで使用される。良い結果が出ても、上位に出る保証はない | 「低速」を解消する。満点は目指さない |
| HTTPS、モバイル表示、インタースティシャル | Core Web Vitals以外の要素は、順位の上昇に直接は貢献しない | 訪れた人のために整える |
| メタディスクリプション | スニペットに使用される場合がある | クリックのために書く |
| メタキーワード | 使用されず、登録にも順位にもまったく影響しない | 書かなくてよい |
| 構造化データ | 内容の理解とリッチリザルトに使う。表示は保証されない | 対応する種類だけ実装する |
| 見出しの数と順番 | 順番どおりでなくても問題ない。理想の数もない | 読みやすさを基準にする |
| Google-Extended | 検索への登録にも順位にも影響しない | AIの学習利用への方針で決める |
Core Web
Vitalsは「使われるが、決め手ではない」
ページ
エクスペリエンスに関するドキュメント(最終更新2026年9月25日)には、Googleのランキングシステムで
Core Web Vitals が使用される、と明記されています。ただし、Search
Consoleのレポートで良い結果が出ても、上位に出ることまでは保証しない、という断りが続きます。
体験の良し悪しを表す単一のシグナルは存在しない、とも説明されています。Google検索は、体験が平均を下回るページも含め、最も関連性の高い内容を表示する設計だとされています。速度は、内容の関連性が同じくらいのページ同士で差になりうる要素、と読むのが妥当です。
HTTPSやモバイル表示は「直接は貢献しない」
同じドキュメントは、Core Web
Vitals以外の要素について、検索結果でのランキング上昇に直接貢献することはないとしています。HTTPS、モバイルでの表示、広告の量、インタースティシャルが、これにあたります。順位への直接の効果がなくても、訪れた人の満足には関わるため、整える価値は変わりません。
メタディスクリプションとメタキーワード
メタキーワードは、Google検索では使用されません。インデックス登録にもランキングにもまったく影響しないと、先ほどの対応メタタグの一覧に明記されています。メタディスクリプションは、同じ一覧でスニペットの材料として紹介されているだけです。「メタディスクリプションにキーワードを入れると順位が上がる」という説を、公式の文書で裏付けることはできませんでした。
構造化データ
構造化データのガイドラインには、違反が見つかって手動の対策が行われたときの扱いも書かれています。リッチリザルトとしては出なくなるものの、ウェブ検索での掲載順位は変わりません。構造化データは見え方を変える手段であり、順位を動かす手段としては書かれていないのです。
文字数、見出しの数、URL内のキーワード
SEOスターターガイドの後半には、気にしなくてよいことの箇条書きがあります。コンテンツの長さだけを調節しても上位表示には意味がない、URLやドメイン名に含めたキーワードの効果はほとんどない、といった内容です。古い解説にある「〇文字以上」「見出しにキーワードを〇回」のような基準は、Googleの文書のどこにも出てきません。
内部対策チェックリスト25項目と、確認に使うツール
点検は、Search
Consoleのレポートと、2つの検証ツールでほぼ足ります。先にツールとの対応を示し、そのあとに層ごとのチェック項目を並べます。
確認したいことと、ツールの対応表
| 確認したいこと | 使うツール・レポート | 見る場所 |
|---|---|---|
| 登録されていないページと、その理由 | Search Console「ページのインデックス登録」レポート | 「URL に noindex が指定されています」など理由別の一覧 |
| 個別URLの登録状況、正規URL、描画結果 | Search Console「URL 検査ツール」 | 「公開 URL をテスト」「クロール済みのページを表示」 |
| robots.txtの取得状況 | Search Console「robots.txt レポート」 | 前回のクロール日、警告、エラー |
| サイトマップの処理状況 | Search Console「サイトマップ レポート」 | 「成功」「取得できませんでした」「エラーがあります」 |
| 速度と安定性(サイト全体) | Search Console「Core Web Vitals レポート」 | モバイル・パソコン別のURLグループ |
| 速度と安定性(個別ページ) | PageSpeed Insights | 実測データとラボデータ |
| HTTPSの状況 | Search Console「HTTPS レポート」 | HTTPSでないURLと、その理由 |
| 構造化データの検証 | リッチリザルト テスト | 検出された項目、エラー、警告 |
| 内部リンクの集まり方 | Search Console「リンクレポート」 | サイト内からリンクされている上位のページ |
| ハッキングやマルウェア | Search Console「セキュリティの問題レポート」 | 検出された問題の種類 |
レポート名は、Search
Consoleヘルプの表記に合わせました。登録状況のレポートについて、ヘルプは、サイトのURLが残らず登録されることはない、と前置きしています。登録率100%を目標にせず、重要なページが漏れていないかを見てください。修正後に「修正を検証」を始めると、通常は2週間ほどで結果が出ます。
URL
検査ツールには、「インデックス登録をリクエスト」の機能があります。リクエストを送っても登録が確約されるわけではなく、1日あたりの件数にも上限があります。
第1層のチェック項目(10項目)
- robots.txtに、サイト全体や公開ディレクトリのクロールを止める指定が残っていない
- 重要なページにnoindexが付いていない
- noindexを付けたページを、robots.txtでブロックしていない
- XMLサイトマップを送信し、ステータスが「成功」になっている
- サイトマップに載せているのが、検索に出したいURLだけである
- httpとhttps、wwwの有無が、301で1つのURLに統一されている
- rel=”canonical”が、そのページ自身か、意図した代表のURLを指している
- 削除したページは404を、移転したページは301を返している
- リダイレクトが3回以内で最終のURLに着く
- JavaScriptで出す本文とリンクが、レンダリング後のHTMLに入っている
第2層のチェック項目(9項目)
- title要素が全ページにあり、同じ文言のページがない
- titleとh1が、同じ主題を表している
- 主要なページに、ページ固有のメタディスクリプションがある
- h2とh3だけを読んで、ページの流れが分かる
- 内容を伝える画像がimg要素で置かれ、altに説明がある
- 売上に近いページが、本文やナビゲーションからリンクされている
- アンカーテキストが、リンク先の内容を具体的に表している
- 構造化データの中身が、ページに表示している文面と食い違っていない
- リッチリザルト テストの結果に、エラーが残っていない
第3層のチェック項目(6項目)
- Core Web Vitals レポートのモバイルに、「低速」のURLグループがない
- LCP、INP、CLSの3指標が、主要なテンプレートで「良好」に入っている
- モバイル版とパソコン版で、本文と構造化データが同じである
- 全ページがHTTPSで配信され、証明書が有効である
- 本文を覆う全画面のポップアップを使っていない
- セキュリティの問題レポートに、検出された問題がない
点検の頻度
25項目のうち、第1層の10項目は毎月、残りは3か月ごとの点検を目安にしてください。リニューアルや大きな改修の直後は、時期を問わず第1層を確認します。
よくある失敗:リニューアル後に起きやすい5つの事故
内部対策の失敗は、知識の不足よりも、公開作業の手順漏れから起きます。サイトのリニューアルや、CMS(コンテンツ管理システム)の入れ替えの直後は、次の5つを確認してください。
失敗1:テスト環境のnoindexやrobots.txtが本番に残る
公開前のテスト環境では、検索に出ないようnoindexやクロール全体の拒否を設定するのが一般的です。その設定が本番にそのまま持ち込まれると、サイト全体が検索結果から外れていきます。公開当日に、トップページと主要ページのHTML、そしてrobots.txtを目で確かめます。
失敗2:URLを変えたのにリダイレクトがない
リニューアルでURLが変わると、古いURLは404になります。404を返すURLはインデックスから削除されるため、検索からの流入も途切れます。Googleのサイト移転のガイドは、旧URLと新URLの対応表を移転作業の重要な項目に挙げています。小規模から中規模のサイトでも、大半のページの移転が反映されるまでに数週間かかります。
失敗3:リダイレクトチェーンが積み重なる
移転のたびに転送を継ぎ足すと、A→B→C→Dのように段数が増えていきます。上限の10ホップに届かなくても、段数が増えるほど表示までの待ち時間は延びます。古いリダイレクトは、最終のURLへ直接向かうよう書き換えます。サイト内のリンクも、転送を経由しないURLに張り替えます。
失敗4:タイトルが全ページで同じになる
テンプレートの設定を誤ると、全ページのtitleが社名だけになったり、同じ定型文になったりします。前述のとおり、定型文のくり返しや不正確なtitleは、タイトルリンクが書き換えられる原因です。公開後にtitleを一覧で出力し、重複を数えれば見つけられます。
失敗5:孤立ページと、パソコン版だけの内容
ナビゲーションを作り直すと、どこからもリンクされないページが生まれます。Googleはリンクをたどって新しいページを見つけるため、孤立したページは発見されにくくなります。もう1つは、スマートフォン版で本文やリンクを省く設計です。評価の基準はモバイル版なので、省いた内容は評価の材料に入りません。
事故を防ぐ、公開前後の4つの手順
- 公開前:旧URLと新URLの対応表を作り、301の設定をテストする
- 公開直後:robots.txt、noindex、canonical、titleを主要な10ページで目視する
- 公開から1週間:Search
Consoleで、除外理由ごとの件数の増減を毎日見る - 公開から1か月:登録ページ数、検索からのクリック数、Core Web
Vitalsを公開前と比べる
エンジニアへの依頼の仕方:チケットに書く5つの要素
内部対策の依頼は、対象、現状、あるべき状態、根拠、確認方法の5点をそろえて出すと進みます。エンジニアが知りたいのは、何をどう変えれば完了なのか、という点だからです。
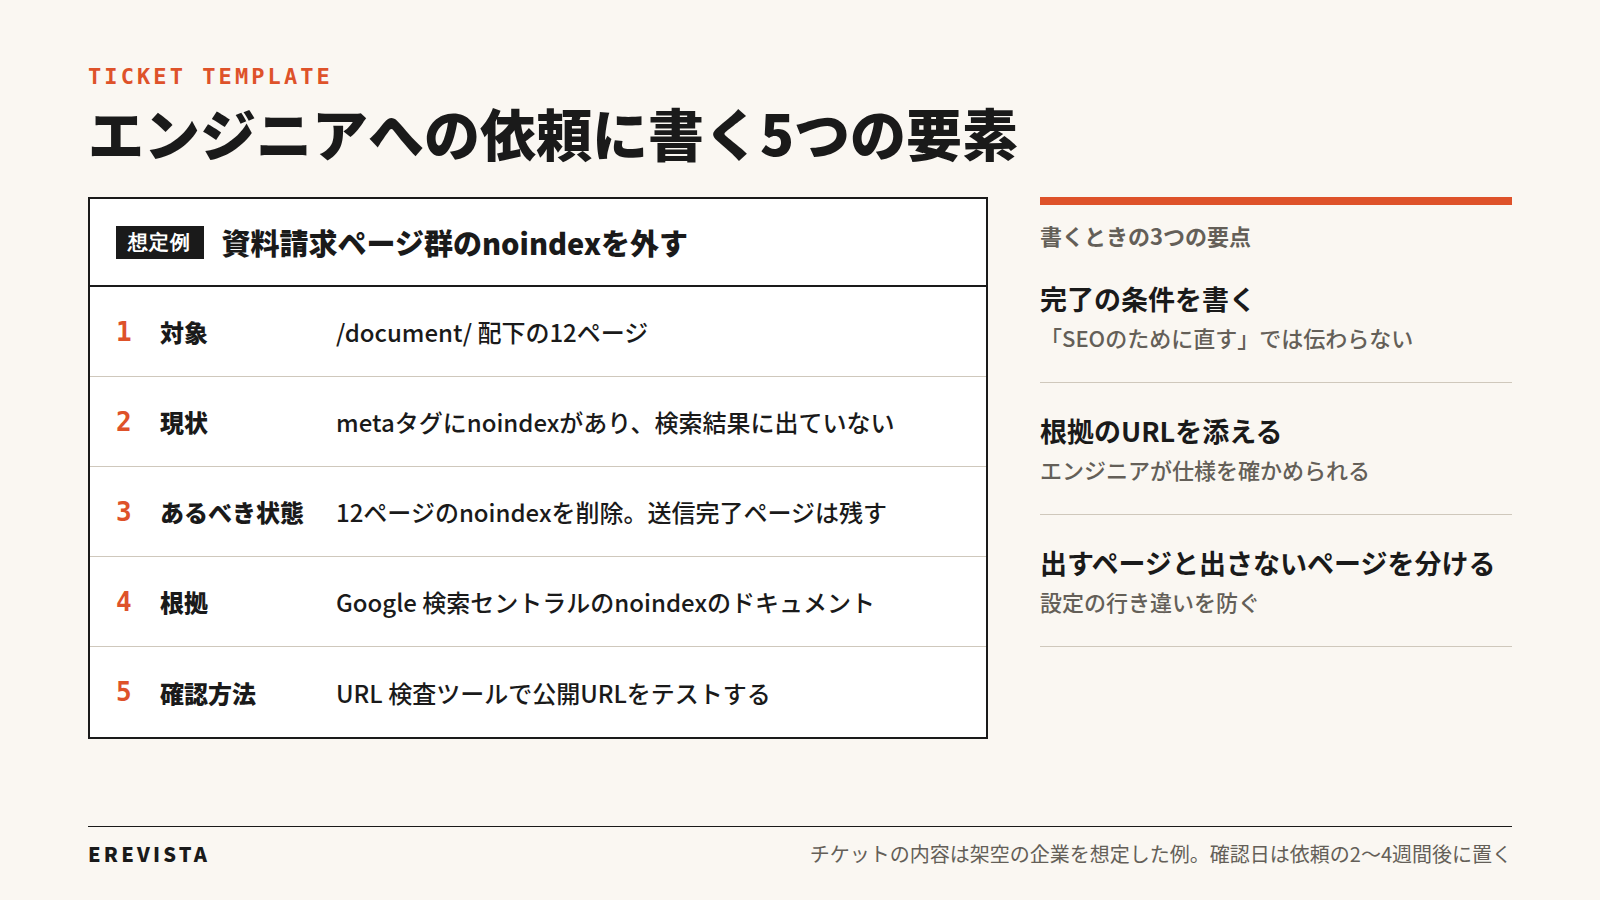
図:エンジニアに渡すチケットの書き方(架空の企業を想定した例)
チケットに入れる5つの要素
- 対象:URLやテンプレートの範囲を書く(例:/blog/
配下の記事テンプレート) - 現状:起きている事象と、それを確認した場所を書く(例:Search
Consoleで「URL に noindex が指定されています」に入っている) - あるべき状態:完了の条件を書く(例:title要素を「記事名|社名」の形式で出力する)
- 根拠:Google 検索セントラルの該当ページのURLを添える
- 確認方法:誰が、どのツールで確かめるかを書く(例:公開後に5つのURLをURL
検査ツールで確認)
「SEOのために直してほしい」という依頼では、完了の条件が伝わりません。根拠のURLがあれば、エンジニアが自分で仕様を確かめられます。
書き方の想定例
次は、架空のBtoB企業を想定したチケットの例です。
- 件名:資料請求ページ群のnoindexを外す
- 対象:/document/ 配下の12ページ
- 現状:metaタグにnoindexがあり、12ページとも検索結果に出ていない
- あるべき状態:12ページのnoindexを削除する。送信完了ページ(/document/thanks/)のnoindexは残す
- 根拠:Google 検索セントラルのnoindexのドキュメント
- 確認方法:反映後にURL
検査ツールで公開URLをテストし、登録をリクエストする
検索に出したいページと、出したくないページを分けて書くと、設定の行き違いを防げます。
優先度と工数を一緒に決める
依頼は、影響の大きさと工数の2軸で並べます。noindexの解除やtitleの修正は、工数が小さく、結果も確認しやすい作業です。速度の改善と、表示方式(JavaScriptでの描画)の変更は、工数が大きく、他の開発との調整が要ります。
第1層の不具合は、通常の開発の順番を待たずに直す。この方針を事前に合意しておくと、事故のときの判断が早くなります。
反映までの期間を共有する
直した内容が検索結果に表れるまで、日数がかかります。SEOスターターガイドによれば、反映は早ければ数時間、遅ければ数か月と開きがあります。評価は、数週間おいてから行うのが目安です。
修正の翌日に数字が動かなくても、失敗とは限りません。依頼の時点で、確認日を2〜4週間後に置いておきます。
リリース前のチェックを、開発の手順に入れる
毎回の点検を人の記憶に頼ると、漏れが出ます。本番公開のチェック項目に、robots.txt、noindex、canonical、title、リダイレクトの5つを加えてもらいます。自動テストに組み込めるかどうかも、エンジニアに相談する価値があります。
AI検索と内部対策:AIによる概要・AIモードに出るための技術条件
GoogleのAI機能でリンクとして出るための技術的な条件は、ふだんの検索結果に出るための条件と変わりません。登録が済み、スニペットを表示できる状態であれば、追加の設定は求められていません。
条件は「登録されていること」と「スニペットを出せること」
Google 検索セントラルの「AI
機能とウェブサイト」は、AIによる概要やAIモードにリンクが出るページの条件を3点にまとめています。インデックス登録が済んでいること、スニペットを表示できること、検索の技術要件に合っていることです。追加の技術要件は設けられていません。
したがって、第1層の整備は、そのままAI検索への備えになります。noindexの付いたページや、クローラーが読めないページは、AI機能にも出ません。
AI機能のためだけに追加する設定はない
同じドキュメントは、AI機能向けに新しいファイルを置いたり、専用のマークアップや構造化データを足したりする必要はない、と明言しています。2026年7月に更新された、生成AI機能への最適化を扱う英語のガイドも同様です。AIに読ませるために文章を小さな断片へ刻む必要はなく、構造化データも必須ではないとしています。
ChatGPTなど他社のAIは、それぞれ独自のクローラーと基準を持っています。ここで述べたのは、Googleの検索とそのAI機能に限った話です。
表示を制限したいときの手段
AI機能での使われ方を制限する手段も、多くは以前からある仕組みです。
- nosnippet:ページのheadかHTTPヘッダーに書くrobots向けの指定です。スニペットが表示されなくなり、AIによる概要とAIモードの入力にも使われなくなります。
- max-snippet:スニペットの最大文字数を決める指定です。AI機能の入力に使われる量も、あわせて制限されます。
- data-nosnippet:div・span・sectionという3種類の要素に付けられる、HTMLの属性です。その部分だけがスニペットから外れます。
- Google-Extended:robots.txtに書く名前です。Geminiの学習とグラウンディング(回答の根拠づけ)への利用を管理するもので、検索への登録と順位には影響しません。
前の3つはrobotsメタタグのドキュメント、Google-Extendedはクローラーの一覧に説明があります。nosnippetを付けると、通常の検索結果からも説明文が消えます。制限は、契約上の理由などで必要なページに絞るのが現実的です。
これとは別に、Googleは2026年6月の発表で、検索の生成AI機能にサイトを出すかどうかを運営者が切り替えられる設定を、Search
Consoleに設けるとしました。8月31日時点で、全世界のサイトに提供されています。対象外にすると、これらの機能での表示と流入はなくなります。生成AI機能以外の検索結果で順位のシグナルに使うことはない、とGoogleは説明しています。
内部対策として追加でやることはあるか
追加の作業は、ほぼありません。Googleが同ドキュメントで続けて求めているのは、クロールを許可する、内部リンクで見つけやすくする、大事な情報を文字で載せる、構造化データを表示内容とそろえる、といった項目です。どれも、第1層から第3層までで扱った内容でした。
よくある質問(FAQ)
内部対策とは、具体的に何をすることですか?
自社サイトの内側を、検索エンジンと利用者の両方に合わせて整えることです。Googleに見つけてもらう層、内容を伝える層、表示の速さや安全性を保つ層の3つに分かれます。記事の執筆や被リンクの獲得は含みません。
内部対策とテクニカルSEOは同じ意味ですか?
完全に同じではありません。テクニカルSEOはサイト全体の仕組みを指します。内部対策は、そこにタイトルや見出しなどページ単位の記述(オンページSEO)を加えた、より広い言葉です。公式の定義はないため、会話では作業名で確かめるのが確実です。
内部対策だけで、上位表示は実現できますか?
内部対策だけで上位に表示されるとは言えません。内部対策は、良い内容が正しく評価されるための前提を作る作業です。技術要件を満たしたページであっても、登録そのものが保証されていない点は、Googleも認めています。
メタディスクリプションは何文字で書けばよいですか?
決まった文字数はありません。Googleは長さに制限を設けていない一方、スニペットは端末の幅などに合わせて切り詰められるとしています。伝えたい内容を前半に置き、ページごとに固有の要約にしてください。
コアウェブバイタルの評価が悪いと、検索結果から消えますか?
消えません。体験面の評価が平均を下回るページでも、関連性が高ければ表示される設計だとGoogleは述べています。とはいえランキングシステムで使われる指標ではあるため、「低速」の判定は解消しておくほうが安全です。
構造化データを追加すると、順位に効果はありますか?
順位への効果は、Googleの文書では説明されていません。構造化データの役割は、内容の理解を助けることと、リッチリザルトの対象になることです。リッチリザルトの表示も保証されていません。
robots.txtとnoindexは、どう使い分けますか?
クロールを減らしたいときはrobots.txt、検索結果に出したくないときはnoindexです。両方を同じページに使うと、Googleがnoindexを読めなくなります。出したくないページは、クロールを許可したうえでnoindexを付けます。
小規模なサイトでも、XMLサイトマップは必要ですか?
およそ500ページ以下で、内部リンクが行き届いているサイトには必須ではありません。新しいサイトや外部からのリンクが少ないサイトでは、ページの発見を早める手段になります。作成の手間は小さいため、用意しておいて損はありません。
まとめ:内部対策は「出られる・伝わる・快適」の順に整える
内部対策は、良い内容が検索で正しく評価されるための前提を作る作業で、直す順番を守れば少ない工数で進められます。
- 検索に出るための技術要件は3つ。Googlebotがブロックされていない、HTTP
200を返す、登録できる内容がある - 検索結果から外す手段はnoindexで、robots.txtではない。重複するURLは301とcanonicalでまとめる
- 順位づけに使われると明記されているのはCore Web
Vitals。良好の基準はLCP 2.5秒、INP 200ミリ秒、CLS 0.1 - メタディスクリプションと構造化データは、順位ではなく検索結果での見え方を整える手段
- 点検ツールの指摘は、件数ではなく、層とページで優先順位をつける
- AIによる概要とAIモードに出るための技術条件は従来の検索と共通で、専用の設定は求められていない
最初の行動は、Search
Consoleで「ページのインデックス登録」レポートを開き、登録されていない理由の一覧に、売上に近いページが入っていないかを見ることです。第1層で最も影響の大きい事故を、短時間で見つけられます。
土台の次に取り組む、指名と引用を育てるための資料
内部対策で土台が整ったら、次は検索とAIの両方で選ばれる中身を作る段階です。「【オーガニック】検索が“答える”時代、指名と引用を資産化する」には、指名検索を育てる考え方と、一次データの柱記事を軸に関連記事を束ねるトピッククラスタの組み方が載っています。90日の計画は、〜30日で現状を見て、〜60日で資産を作り、〜90日で指名を育てる組み立てです。資料は、EREVISTAのサイトにあるお役立ち資料の一覧から、フォームを送信して入手します。
出典・参考資料
記事内のデータは2026年10月4日時点で確認したものです。
- Google 検索セントラル「Google
の検索エンジンの仕組み、検索結果と掲載順位について」(最終更新2025年12月18日) - Google 検索セントラル「Google
検索の技術要件」(最終更新2025年12月18日) - Google 検索セントラル「Google
公式 SEO スターター ガイド」(最終更新2025年12月18日) - Google 検索セントラル「robots.txt
の概要とガイド」(最終更新2025年12月18日) - Google 検索セントラル「noindex
を使用してコンテンツをインデックスから除外する」(最終更新2025年12月31日) - Google 検索セントラル「サイトマップについて」(最終更新2025年12月18日)
- Google 検索セントラル「サイトマップの作成と送信」(最終更新2026年7月13日)
- Google 検索セントラル「URL
正規化とは何か」(最終更新2026年9月11日) - Google 検索セントラル「rel=”canonical”
などを利用して正規ページを指定する方法」(最終更新2026年7月14日) - Google 検索セントラル「リダイレクトと
Google 検索」(最終更新2026年4月17日) - Google 検索セントラル「サイト・ホームページ移行について」(最終更新2026年9月11日)
- Google クロール インフラストラクチャ「HTTP
ステータス コードが Google
のクローラーに及ぼす影響」(最終更新2026年3月6日) - Google 検索セントラル「JavaScript
SEO の基本を理解する」(最終更新2026年3月5日) - Google 検索セントラル「Google
検索における URL 構造のベスト
プラクティス」(最終更新2025年12月31日) - Google 検索セントラル「ページのローカライズ版」(最終更新2026年9月23日)
- Google 検索セントラル「クロール
バジェットを最適化する」(最終更新2026年9月16日) - Google 検索セントラル「Google
検索結果のタイトルリンクの変更」(最終更新2025年12月18日) - Google 検索セントラル「スニペットの管理・メタ
ディスクリプションについて」(最終更新2026年4月22日) - Google 検索セントラル「Google
がサポートしているメタタグと属性」(最終更新2026年3月8日) - Google 検索セントラル「画像の
SEO ベスト プラクティス」(最終更新2026年3月3日) - Google 検索セントラル「Google
の SEO リンクに関するベスト
プラクティス」(最終更新2025年12月31日) - Google 検索セントラル「構造化データ
マークアップとは」(最終更新2025年12月18日) - Google 検索セントラル「Google
検索上の構造化データ ガイドライン」(最終更新2026年9月16日) - Google 検索セントラル「ドキュメントの最新の更新内容」(2026年5月8日の項)
- Google 検索セントラル「Core
Web Vitals と Google
検索の検索結果について」(最終更新2025年12月18日) - Google 検索セントラル「ページ
エクスペリエンスが Google
検索の検索結果に与える影響について」(最終更新2026年9月25日) - Google 検索セントラル「モバイルサイトとモバイルファースト
インデックスに関するおすすめの方法」(最終更新2026年2月20日) - Google 検索セントラル「煩わしいインタースティシャルやダイアログを避ける」(最終更新2025年12月18日)
- Google for Developers「PageSpeed
Insights について」(最終更新2025年7月25日) - Google 検索セントラル「AI
機能とウェブサイト」(最終更新2025年12月31日) - Google 検索セントラル「Google’s
Guide to Optimizing for Generative AI Features on Google
Search」(最終更新2026年7月10日) - Google 検索セントラル「Robots
meta タグ、data-nosnippet、X-Robots-Tag
の設定」(最終更新2026年3月25日) - Google クロール インフラストラクチャ「Google
の一般的なクローラー」(最終更新2026年9月16日) - Google The Keyword「New
opportunities, control and insights for website
owners」(2026年6月3日公開、8月31日更新) - Search Console ヘルプ「ページ
インデックス登録レポート」 - Search Console ヘルプ「URL
検査ツール」 - Search Console ヘルプ「robots.txt
レポート」 - Search Console ヘルプ「サイトマップ
レポートを使用してサイトマップを管理する」 - Search Console ヘルプ「クロールの統計情報レポート」
- Search Console ヘルプ「リンクレポート」
- Search Console ヘルプ「リッチリザルト
テスト」 - Search Console ヘルプ「Core
Web Vitals レポート」 - Search Console ヘルプ「HTTPS
レポート」 - Search Console ヘルプ「セキュリティの問題レポート」
- Ahrefs「We
Studied Over 1 Million Domains to Find the Most Common Technical SEO
Issues」(2023年8月31日公開、2026年8月12日更新) - Ahrefs「6
Important Insights About Title Tags (953,276 Pages
Studied)」(2021年11月16日公開) - Ahrefs「How Often Does
Google Rewrite Meta Descriptions? (New Data
Study)」(2020年3月25日公開) - DebugBear「2025 In
Review: What’s New In Web
Performance?」(2025年12月5日公開、HTTP
ArchiveのCrUX集計を引用)