


llms.txtとは?書き方と設置方法、AI検索への効果と現時点での位置づけ
llms.txtとは、サイトの最上位に「/llms.txt」という名前で置くMarkdown書式のテキストファイルで、生成AIに向けてサイトの概要と主要ページの一覧を手短に伝えるために提案された取り決めです。読むのは人ではなく、ページを読みに来るAIのプログラムです。2024年9月にJeremy Howard氏が提案し、2026年8月に第2版へ改訂されました。
ただし2026年10月の段階では、このファイルは「置けばAIに読まれる」ものとは言えません。Googleは公式ガイドの中で、Google検索では無視されると明記しています。本記事で開いたOpenAI・Anthropic・Perplexityの3社のクローラー解説にも、自社のAIがllms.txtを読むという記載はありませんでした。一方でこの3社は、自社の開発者向け文書サイトにllms.txtを置いており、技術文書の世界では採用が広がっています。
この記事が想定する読み手は、「llms.txtを置くべきか」と社内で聞かれる立場にある、企業のマーケティング責任者と担当者です。定義、書式、似たファイルとの違い、誰が読むのかの公式見解、効果、robots.txtの決め方、作成手順と想定例、失敗、確認と運用の順に説明します。
目次
- llms.txtとは?定義と、提案された経緯
- llms.txtの書式:ファイルを構成する要素
- robots.txt・sitemap.xml・構造化データとの違い
- 誰がllms.txtを読むのか:公式文書で確認できたこと
- AIはいまどのようにサイトの内容を取得しているのか
- llms.txtの効果と位置づけ:分かっていること、それでも置く価値がある場面
- 本当に効くのはrobots.txt:AIクローラーの許可と拒否の決め方
- llms.txtの書き方:8つの手順と想定例
- よくある失敗と、CMS・WordPressでの注意点
- 読まれたかを確かめる方法と、運用の決め方
- よくある質問(FAQ)
- まとめ:llms.txtは「置いて損はないが、成果を期待しない」ファイル
- 出典・参考資料
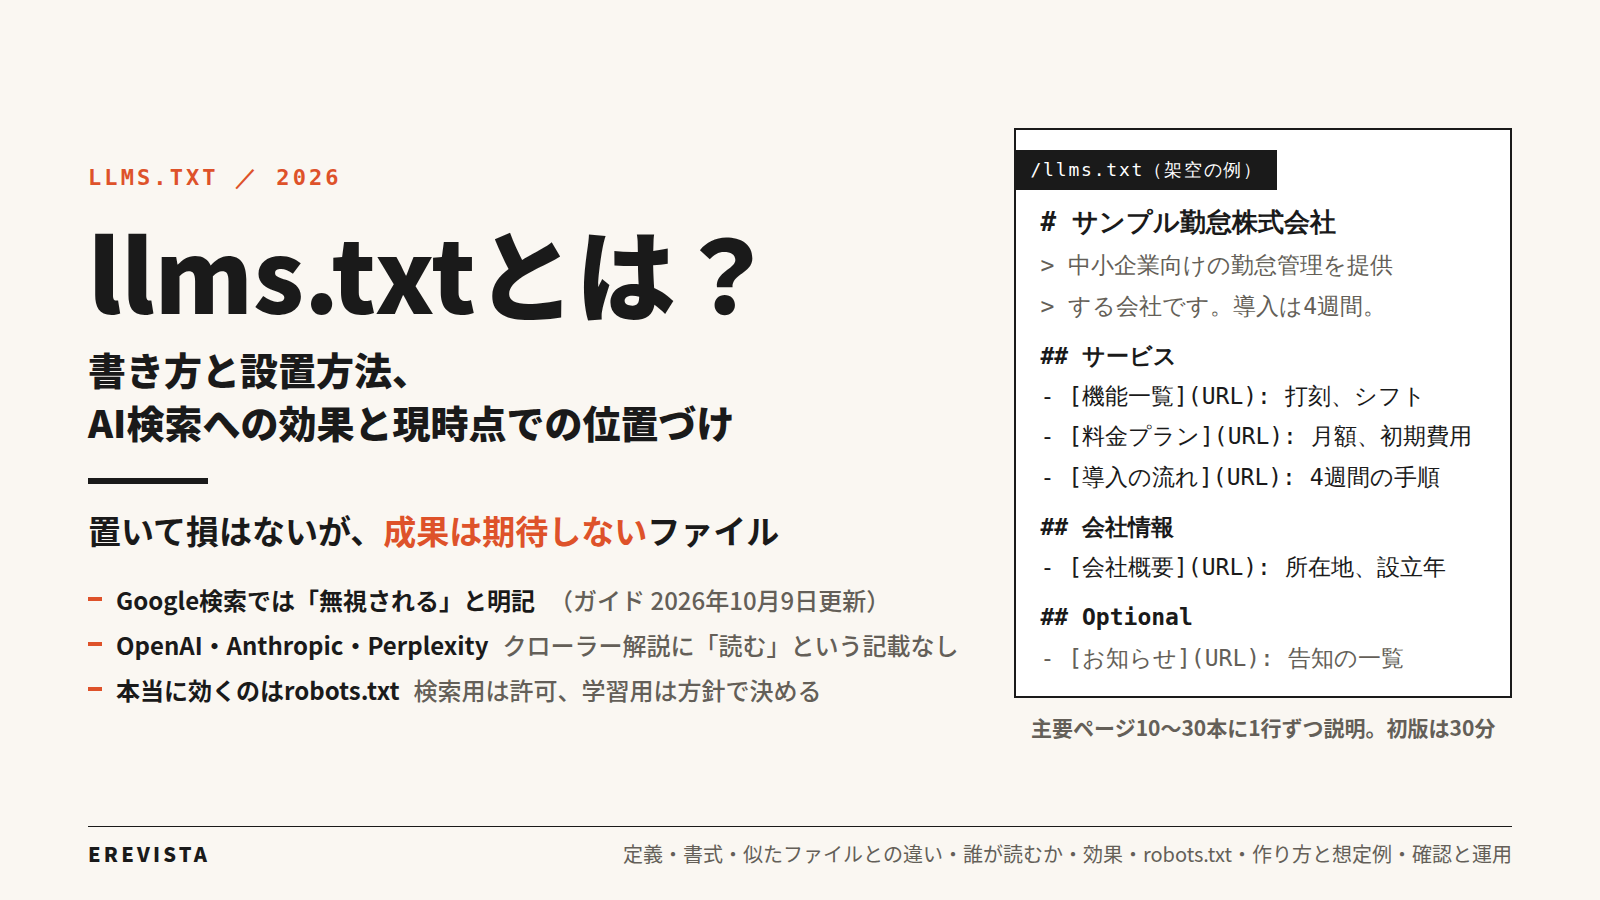
llms.txtの現在地を示す5つの事実
- llms.txtは、サイトの概要と主要ページのリンクをMarkdownで書き、サイトの最上位に置くAI向けの案内ファイルです。標準化機関の規格ではなく、Jeremy Howard氏が2024年9月3日に公開した提案で、必須の要素はH1見出しだけです。
- Googleは2026年10月9日更新の公式ガイドに、llms.txtなどのファイルはGoogle検索では無視され、表示にも順位にも影響しないと書いています。この注記は2026年6月15日に追加されました。
- 本記事で開いた3社(OpenAI、Anthropic、Perplexity)のクローラー解説に、自社のAIがllms.txtを読むという記載はありません。一方、3社の開発者向け文書サイトは、それぞれ約40本、約760本、約170本のリンクを載せたllms.txtを公開しています。
- 影響が大きいのはrobots.txtです。OpenAIは、検索用のクローラーOAI-SearchBotを拒否したサイトはChatGPTの検索回答に表示されないと説明し、GoogleはGoogle-Extendedの拒否が検索の登録状況や順位には影響しないとしています。
- Ahrefsが2026年6月に公開した調査(137,210ドメインが対象)では、llms.txtがあるドメインの97%で、1か月の取得が0件でした。作成自体は主要ページ10〜30本に1行ずつ説明を書く30分ほどの作業ですが、クロールできて引用に値するページがなければ意味を持ちません。
llms.txtとは?定義と、提案された経緯
llms.txtとは、生成AIがサイトの全体像をつかみやすいように、運営者が自分の言葉で書いた「サイトの案内文」を、決まった場所に決まった書式で置く取り決めです。提案ページは、HTMLのページがナビゲーション、広告、JavaScriptに包まれていて、きれいな本文に戻すのが難しいこと、そしてAIが一度に扱える文脈の量(コンテキストウィンドウ)はサイト全体を収めるにはまだ小さいことを、提案の背景に挙げています。観光地の入口にある案内板のように、何のサイトでどこに何があるかを短く示し、本文はリンク先のページに委ねる、という発想です。
llms-full.txtとの関係
llms.txtは「目次」で、サイトの概要とリンク一覧だけを載せます。これに対し、主要な文書の本文をすべてつなげた1本の大きなファイルを「llms-full.txt」という名前で公開するサイトがあります。ただし、llms-full.txtは提案ページの第2版にもGitHubのリポジトリにも登場しない、採用する側で広まった慣行です。本記事で開いた例では、AnthropicとVercelの文書サイトが、llms.txtの中からllms-full.txtへ案内していました。
多くの企業サイトに必要なのはllms.txtだけで、llms-full.txtはAIに丸ごと読ませたい技術文書を大量に持つサイトで意味を持ちます。本文を丸ごと収めるため大きくなりやすく、作るなら公開中の文書から自動生成し、元の文書が更新されたら作り直す仕組みを前提にします。
「規格」ではなく「提案」という位置づけ
llms.txtは、robots.txtのように標準化団体が文書化した仕様ではありません。提案の原文はllmstxt.orgで公開されており、著者はJeremy Howard氏、初版の公開日は2024年9月3日です。2026年8月10日には、2年間の採用で分かったことを反映した第2版に改められました。提案のサイトと、文書の管理や議論の場であるGitHubのリポジトリは、Answer.AIが運営しています。
第2版で変わった3つの点
第2版の変更点のページによると、変わったのは主に3つです。1つ目は置き場所で、サイトの最上位だけでなく「/docs/llms.txt」のように階層の途中に置き、その配下のページを対象にできると定義されました。2つ目は見つけ方で、各ページのHTMLに、Markdown版のURLと、そのページを含むllms.txtの場所を示すlink要素を置く方法が加わりました。
3つ目は読まれ方の想定です。初版は、llms.txtをAIの文脈に展開する専用ツールを前提にしていましたが、第2版ではその前提が外れ、AIエージェントがllms.txtを見て、必要なリンクをたどる、という使い方に改められました。変更点のページには、数千のサイトがllms.txtを公開し、コーディング用のエージェントが利用しているとも書かれていますが、これは提案者自身の記述で、第三者の集計ではありません。
Googleの書き方からも、この位置づけが読み取れます。Google検索セントラルが公開する生成AI機能向けのガイド(2026年10月9日が最終更新)は、このファイルを「LLMS.txt ファイル(または同様のファイル)」と呼び、「ほかのサービスやシステムのために維持する」ことは問題ないとしています。他者が任意に採用し得るファイル形式の一つ、という扱いです。
どんなサイトで使われているか:5社の実例
採用が目立つのは、開発者向けの技術文書を公開するサイトです。本記事では2026年10月12日に、OpenAI、Anthropic、Cloudflare、Perplexity、Vercelの5社のファイルを開きました。OpenAIの開発者向けサイトのllms.txtは、1行目がサイト名の見出し、2行目以降に一言の説明、その下に「Documentation sets」「Common tasks」「Site navigation」「Learning tracks」の4つの節があり、合計で約40本のリンクが並びます。
リンクの大半には「- [ページ名](URL): 1行の説明」という形で補足が付き、リンク先の約半数はURLの末尾に「.md」を付けたMarkdown版です。同サイトのトップページも、URLに.mdを足すとMarkdown版が開けると案内しています。
| サイト(運営者) | 1行目と引用ブロック | 節とリンクの数 | 目についた特徴 |
|---|---|---|---|
| OpenAI(developers.openai.com) | 「# OpenAI Developers」。引用ブロックあり | H2が4節、リンク約40本 | 大半の行に1行の説明。約半数が.md版ページへのリンク |
| Anthropic(platform.claude.com) | 「# Anthropic Developer Documentation」。引用ブロックなし | H2が4節、その下にH3の小節、リンク約760本 | 説明はハイフン区切り。末尾でllms-full.txtを案内 |
| Cloudflare(developers.cloudflare.com) | 「# Cloudflare Developer Documentation」。引用ブロックあり | H2が9節、リンク約113本 | リンク先は製品ごとのllms.txt。階層で分割する構成 |
| Perplexity(docs.perplexity.ai) | 「# Perplexity」。引用ブロックあり | 見出しのない一覧に続き、OpenAPI SpecsとOptionalの2節。リンク約170本 | 大半の行に説明が付く。クローラー解説のページも一覧に含む |
| Vercel(vercel.com) | 「# Vercel」。引用ブロックあり | H2が9節(Optionalを含む)、リンク約25本 | 「エージェントの使い方」の節がある。llms-full.txtも案内 |
5つに共通するのは、H1とリンクの箇条書きです。引用ブロックの有無、説明文の書き方、リンクの本数、Markdown版ページへの誘導の有無は運営者ごとに異なり、提案が「必須はH1だけ」としている通りの自由度が見て取れます。なお、docs.anthropic.com/llms.txtとvercel.com/docs/llms.txtは、それぞれplatform.claude.comとvercel.comの最上位にあるファイルへ転送されました。
llms.txtの書式:ファイルを構成する要素
llms.txtの書式は、Markdownの中でも限られた要素だけを使う、ごく単純なものです。見出し、引用、段落、箇条書きのリンクの4種類を覚えれば書けます。本章では、提案ページの第2版(2026年8月10日更新)の記述をもとに整理します。
: 一行の説明」のリンク行、Optional節という構成と、各要素の必須・任意の区分(提案ページ第2版、2026年8月10日更新をもとに作成)](/wp-content/uploads/2026/10/llms-txt-fig02.png)
図:llms.txtの構成要素(llmstxt.orgの第2版をもとにした架空の例)
構成要素の一覧
| 要素 | 書き方 | 役割 | 位置づけ |
|---|---|---|---|
| H1見出し | 「# サイト名または会社名」を1行目に書く | ファイルが何のサイトのものかを示す | 必須。唯一の必須要素で、1つだけ |
| 引用ブロック | 「> 」で始まる1〜3文 | サイトの要約。AIが最初に読む説明文 | 任意。提案の例では置く |
| 補足の段落 | 見出しなしの文章や箇条書き | 読み方の注意、対象読者、情報の時点 | 任意。見出し以外のMarkdownなら何でもよい |
| H2見出し | 「## 節の名前」 | リンクの一覧をテーマ別にまとめる | 任意。0個でも複数でもよい |
| リンクの行 | 「- [ページ名](URL): 一行の説明」 | 読むべきページと、その中身の要点 | リンク部分は必須。コロン以降の説明は任意 |
| Optional節 | 「## Optional」という名前のH2 | 読み飛ばしてもよい補助的なリンクの置き場 | 任意。慣行として残るが、第2版では特別な意味を持たない |
小さなサイトなら、H1、引用ブロック、節が1つ、リンクが10本という構成で十分です。ファイルの先頭にBOM(文字コードを示す印)を置いてもよいと書かれていますが、通常は不要です。
引用ブロックとリンクの行
引用ブロックには、「誰に向けて、何を提供しているサイトか」を1〜3文で書きます。ファイル全体の中で、AIに読まれる見込みがもっとも高い箇所です。リンクの行は、角かっこにページ名、丸かっこにhttps://から始まる絶対URL、コロンの後ろに「何が書いてあるページか」を事実として述べる一行を置きます。
Optional節の意味
「Optional」という名前の節は、初版では「文脈を短くしたいときは、この節のリンクは省いてよい」という合図でした。初版が想定していた専用ツールが、llms.txtをAIの文脈に展開するときにこの節を省く、という仕組みです。第2版ではそのツールが提案から外れ、Optional節は「慣行として残るが、機械的な意味は持たない」と整理されました。それでも、会社の沿革や過去のお知らせなど優先度の低いリンクをここに分けておけば、読む側は重要なページから順にたどれます。
Markdown版ページと配信形式
第2版で記述が増えたのは、llms.txtそのものより、各ページのMarkdown版とその見つけ方です。HTMLページと同じURLの末尾に「.md」を付けた版(page.html.mdまたはpage.md)を用意し、HTMLのhead内のlink要素で「このページのMarkdown版はこれ」「このページを含むllms.txtはこれ」と示す設計です。本記事で開いた5社のうち、Cloudflare以外の4社はMarkdown版ページへリンクしていました。
提案ページにContent-Typeヘッダー(ファイルの種類をブラウザやプログラムに伝える情報)の指定はありません。実際の運用では、UTF-8で保存し、「text/plain」または「text/markdown」に「charset=utf-8」を添えて返すのが無難です。CMSによっては、拡張子が.txtでもHTMLのテンプレートに包まれて返されることがあるため、公開後にブラウザで開き、Markdownの記号がそのまま見えるかを見ておきます。
robots.txt・sitemap.xml・構造化データとの違い
llms.txtは、robots.txt、sitemap.xml、構造化データのどれとも役割が重なりません。robots.txtは「入ってよい場所」、sitemap.xmlは「登録を望むURL」、構造化データは「ページの意味」を機械に伝える仕組みで、llms.txtは「人が書いたサイトの案内文」です。robots.txtやサイトマップの確認と修正の手順は、SEO内部対策の記事をご覧ください。
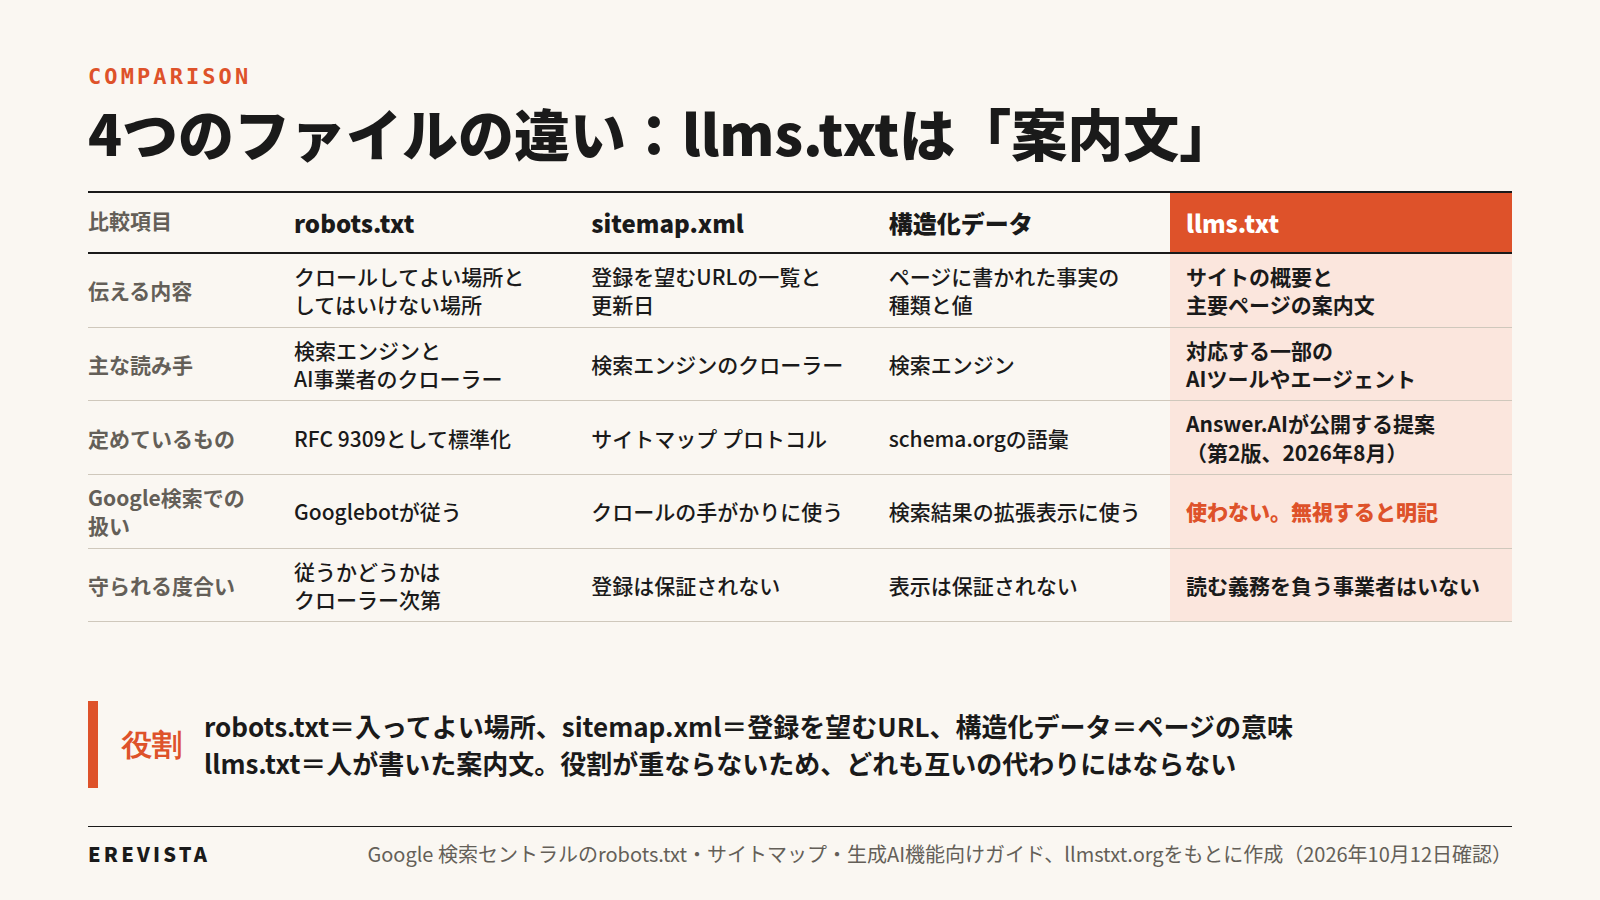
図:4つのファイルの役割の違い(Google 検索セントラルの各ドキュメントとllmstxt.orgをもとに作成)
4つのファイルの比較
| 比較項目 | robots.txt | sitemap.xml | 構造化データ | llms.txt |
|---|---|---|---|---|
| 伝える内容 | クロールしてよいURLとしてはいけないURL | 登録を望むURLの一覧と更新日 | ページに書かれた事実の種類と値 | サイトの概要と主要ページの案内 |
| 主な読み手 | 検索エンジンとAI事業者のクローラー | 検索エンジンのクローラー | 検索エンジン | 対応する一部のAIツールやエージェント |
| 書式 | 専用のテキスト書式 | XMLなど | JSON-LDなど | Markdown |
| 置き場所 | サイトの最上位(/robots.txt) | 任意。robots.txtのSitemap行やSearch Consoleで場所を伝える | 各ページのHTML内 | サイトの最上位(/llms.txt)。階層の途中にも置ける |
| 定めているもの | RFC 9309として標準化 | サイトマップ プロトコル | schema.orgの語彙 | Answer.AIが公開する提案(第2版) |
| Google検索での扱い | Googlebotが従う | クロールの手がかりに使う | 検索結果の拡張表示に使う | 使わない。無視すると明記 |
| 守られる度合い | 従うかどうかはクローラー次第 | 登録を保証しない | 表示を保証しない | 読む義務を負う事業者はいない |
robots.txt:入ってよい場所を伝えるファイル
robots.txtは、クローラー(ページを自動で収集するプログラム)に、サイト内のどのURLへアクセスしてよいかを伝えるファイルです。Google検索セントラルが公開する概要は、このファイルを検索結果から隠す道具ではないと注意し、各クローラーで解釈が異なる可能性があること、従うかどうかはクローラー次第であることも述べています。
Googleのrobots.txtの解釈に関する文書(2026年9月11日に更新)は、元の標準としてRFC 9309を参照し、ファイルはサイトの最上位に置くこと、Googleが読むのは500KiBまでであること、内容は通常最大24時間キャッシュされることを説明しています。AI事業者のクローラーの許可と拒否も、この同じファイルに書きます。
sitemap.xml:登録を望むURLの一覧
サイトマップは、サイト上のページや動画などの情報と、それらの関係を検索エンジンへ渡す一覧です。Googleの解説は、500ページ前後までのサイトを小規模とみなし、ページ同士がリンクでつながっていれば必須ではないという立場で、載せたURLがすべてクロールされ登録される保証はないとも断っています。サイトマップは網羅的な一覧で説明が付かず、llms.txtは少数のページに一行の説明を添えた編集済みの案内です。
構造化データ:ページの意味を機械向けに記述する
構造化データは、社名、価格、著者名、公開日などページ上の事実を、決まった語彙で機械向けに書き込む記述です。Googleの生成AI機能向けのガイドによれば、生成AI検索に構造化データは必要なく、追加が求められる専用の記述もありませんが、拡張された検索結果(リッチリザルト)に出る資格に関わるため、引き続き使うよう勧めています。llms.txtは人が読む文章に近い形で概要を述べるもので、両者は競合せず、置き換えもできません。
誰がllms.txtを読むのか:公式文書で確認できたこと
2026年10月の段階で、本記事が開いた主要事業者の公式文書の中に、「自社のAIがllms.txtを読み取って使う」と明記したものはありませんでした。Googleは使わないと明言し、OpenAI・Perplexity・Anthropicの各クローラー解説には記載がなく、Microsoftについては開けた範囲の文書に言及がありません。事業者が公式に「使う」と述べない限り、効果を前提にした投資は避けるのが安全です。
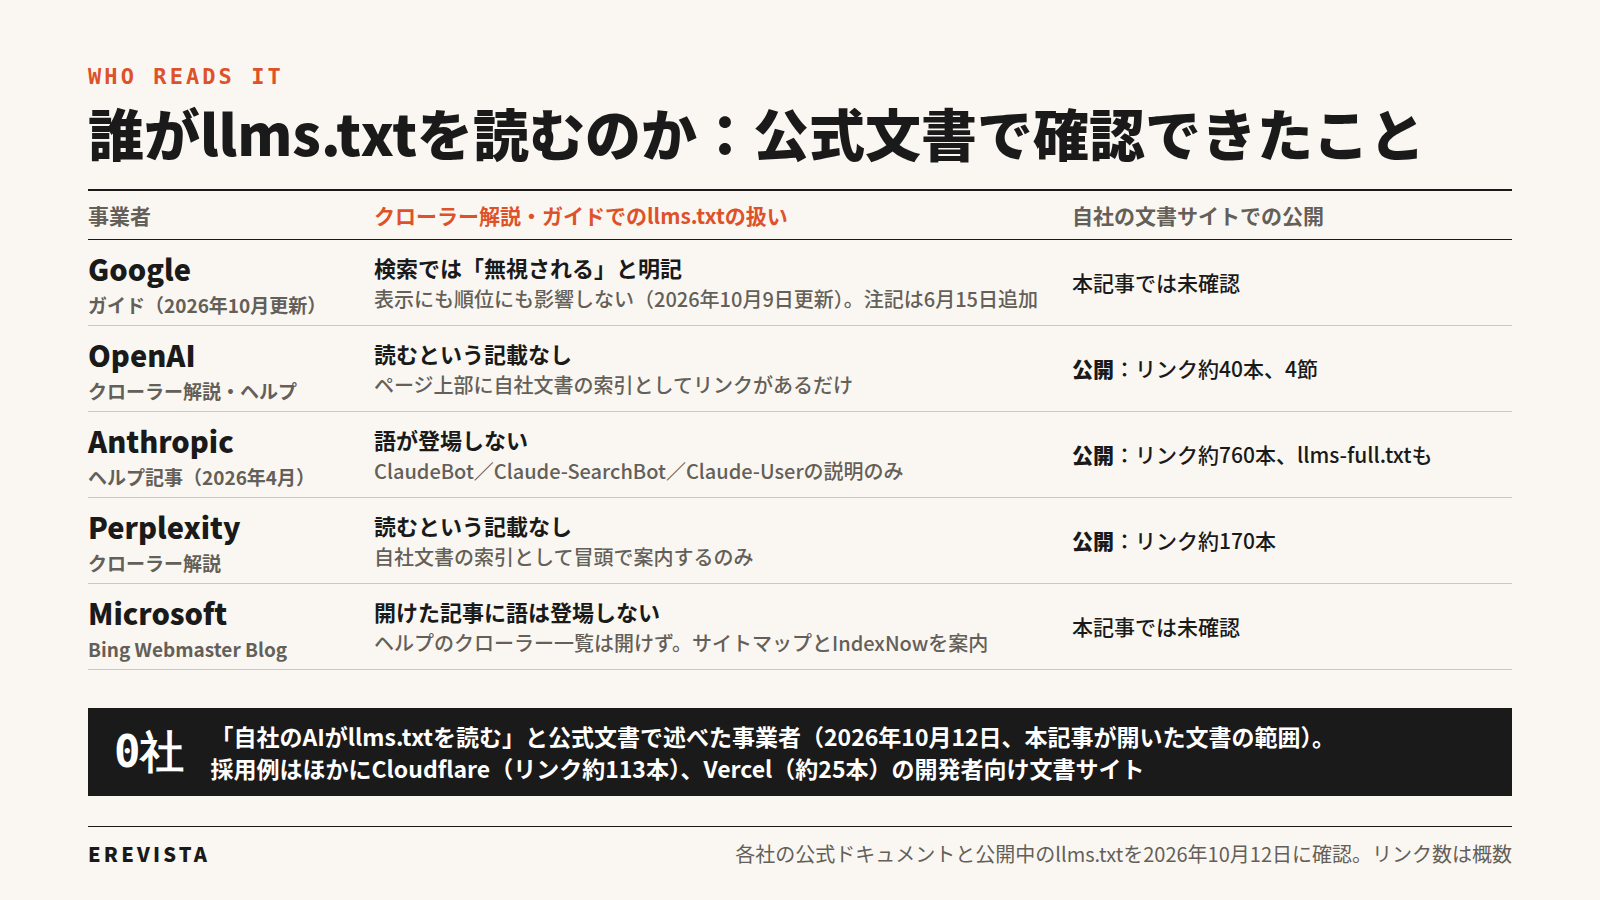
図:主要事業者の公式文書におけるllms.txtの扱いと、文書サイトでの採用(2026年10月12日確認)
Google:検索では無視すると明記
前述の生成AI機能向けのガイドには、LLMS.txtファイルや同様のファイルを他のサービスのために維持するのは問題ないが、Google検索ではそれらは無視されるため、Google検索での表示やランキングに影響しないとあります。要点をまとめた節でも、llms.txtのようなAI向けテキストファイルを作ることは「無視できる戦術」の一つに挙げられています。
Google検索セントラルが公開する更新履歴の2026年6月15日の項には「llms.txt ファイルに関するガイダンスを明確化」とあり、Google検索によるllms.txtの使用を明確にする注記を追加した、と記されています。
OpenAI:クローラー文書に記載はなく、自社サイトでは採用
OpenAIのクローラーの解説は、検索用、学習用、利用者の操作用の3種類のクローラーの役割とrobots.txtでの制御方法を説明していますが、クローラーがllms.txtを参照するという記述はなく、ページ上部に同社の文書全体の索引としてllms.txtへのリンクが置かれているだけです。
同社のChatGPTの検索に関するヘルプと公開者向けのFAQにも、llms.txtの語はありません。検索に載る条件として示されているのは、OAI-SearchBotのクロールを許可することと、公開済みのIPアドレスから届く通信を通すことです。OpenAIは、自社の文書サイトではllms.txtを「提供する側」として採用しつつ、自社のクローラーが「読む側」になるとは説明していない、ということです。
Anthropic・Perplexity:クローラー文書に記載はなく、文書サイトでは公開
Anthropicのクローラーに関するヘルプ記事(2026年4月7日更新)は、生成AIモデルの改善のために収集するClaudeBot、検索結果の品質向上のためにウェブを巡回するClaude-SearchBot、利用者の質問に応じてページを取りに行くClaude-Userの3つを説明しています。自社のボットはrobots.txtの業界標準の指示に従う、とも述べていますが、llms.txtの語はありません。一方、同社の開発者向け文書サイトは、約760本のリンクを載せたllms.txtを公開しています。
Perplexityのクローラーの解説も、検索結果にサイトを出すためのPerplexityBotと、利用者の操作で動くPerplexity-Userの2つを説明するだけです。llms.txtは、ページの冒頭に「文書全体の索引はこちら」という自社サイトの案内として登場するにとどまり、クローラーが読むという説明ではありません。
Microsoft(Bing):ヘルプは開けず、公式ブログに記載なし
MicrosoftのBingについては、クローラー一覧のヘルプページがJavaScriptなしでは開けず、本記事では中身を読めていません。代わりに開いたBing Webmaster Blogの記事(2025年7月31日)は、Bing Copilotのような「AIを使った検索」で内容を見つけてもらう土台として、サイトマップとIndexNow(URLの更新を検索エンジンへ即時に通知する仕組み)を挙げており、llms.txtには触れていません。
| 事業者 | 確認した公式文書 | llms.txtに関する記載 |
|---|---|---|
| 生成AI機能向けのガイド(2026年10月9日更新)、AI 機能とウェブサイト、クローラー一覧、Search Consoleのヘルプ | 検索では無視し、表示にも順位にも影響しないと明記。他の文書には語が登場しない | |
| OpenAI | クローラーの解説、ChatGPTの検索に関するヘルプ、公開者向けFAQ | クローラーが読むという記載はない。文書サイトの索引として自社のllms.txtを公開 |
| Anthropic | クローラーに関するヘルプ記事(2026年4月7日更新) | 語が登場しない。文書サイトでllms.txtとllms-full.txtを公開 |
| Perplexity | クローラーの解説 | クローラーの説明にはなく、自社文書の索引としてのみ案内。文書サイトでllms.txtを公開 |
| Microsoft(Bing) | クローラー一覧のヘルプは開けず。Bing Webmaster Blogの記事(2025年7月31日) | 開けた記事に語は登場しない。AI検索向けの土台としてサイトマップとIndexNowを案内 |
AIはいまどのようにサイトの内容を取得しているのか
AIがサイトの内容を手に入れる経路は、検索インデックスの利用、専用クローラーの巡回、利用者の指示で動く取得の3つです。どの経路にも、llms.txtを読む工程は公式には組み込まれていません。
経路1:検索インデックスから材料を取る
Googleの生成AI機能は、Google検索のインデックス(検索用に蓄えたページの集まり)から材料を取ります。前述のガイドは、この手法を検索拡張生成(RAG)と呼び、検索の中核となるランキングの仕組みを使って、新しく関連性の高いページを取り出して回答の品質と精度を高めるものだと説明しています。表示の前提も、ページがインデックス登録済みで、スニペットを表示でき、Search Consoleの「検索の生成AI」設定でサイトが含まれていることです。Googleの文書「AI 機能とウェブサイト」も、AIによる概要とAIモードに出るための追加の要件はないとしています。
この経路の規模は大きく、Googleの公式ブログ(2026年6月3日公開、8月31日更新)によれば、AIによる概要には月間25億人超、AIモードには月間10億人超の利用者がいます。企業の集客にとって最も大きい入口がここにあります。
ChatGPTも、検索を使うときは似た流れをたどります。OpenAIのヘルプによれば、利用者の質問は一つまたは複数の検索語へ書き換えられて送られ、ChatGPTはほかの検索事業者と組むことがあります。この経路では、サイトは「検索エンジンに評価されたページ」として材料になります。
経路2:専用クローラーがサイトを巡回する
AI事業者は、自社の名前を持つクローラーを運用しています。OpenAIの解説によると、検索用のOAI-SearchBotはChatGPTの検索機能にサイトを出すためのクローラーで、学習用のGPTBotは基盤モデルの学習に使われ得る内容を集めます。Anthropicでは学習用のClaudeBotと検索用のClaude-SearchBot、PerplexityではPerplexityBotが同じ役割を担います。Googleでは、Googlebotが検索の全機能のためにクロールし、Google-Extendedという名前で生成AIへの利用を制御します。llms.txtという特定のファイルを探して読むとは、どの事業者も文書に書いていません。
経路3:利用者の指示で個別のページを取る
3つ目は、利用者が「このURLを読んで」と頼んだときなどに、AIが個別のページを取りに行く経路です。OpenAIのChatGPT-Userはこの用途で、自動巡回には使われず、利用者の操作が起点であるためrobots.txtが及ばない場合があると説明されています。AnthropicのClaude-UserとPerplexityのPerplexity-Userも同じ種類で、Perplexityは利用者の要求による取得のため通常はrobots.txtを無視すると明記しています。Googleのユーザー トリガー フェッチャーの文書(2026年5月14日更新)も、利用者がリクエストした取得であるため、通常robots.txtのルールは無視されると述べています。エージェント(人の代わりにウェブ上の操作を行うAI)向けのGoogle-Agentなどがここに含まれます。
llms.txtが関わり得るのはどこか
llms.txtが入り込める余地は、経路3の周辺に限られます。開発者が使うAIツールやエージェントが、決まった場所にある案内ファイルを先に読んでから作業する、という使い方で、技術文書のサイトで採用が進んでいる理由もここにあります。企業の集客に関わるのは主に経路1で、ここでllms.txtが使われるとは、公式文書のどこにも記されていません。インデックスに入り、スニペットを出せ、引用に値する内容を持つページを増やすことが先です。
| 経路 | 代表的な仕組み | robots.txtの効き方 | llms.txtの位置 |
|---|---|---|---|
| 検索インデックスの利用 | GoogleのRAG(グラウンディング)、ChatGPTの検索語への書き換え | Googlebot、OAI-SearchBotへの許可が前提 | 公式には使われない |
| 専用クローラーの巡回 | GPTBot、ClaudeBot、PerplexityBot(Google-Extendedはrobots.txt用の名前) | 名前ごとに許可・拒否できる | 読むという記載なし |
| 利用者の指示で動く取得 | ChatGPT-User、Claude-User、Perplexity-User、Googleのユーザー トリガー フェッチャー | 及ばない場合がある | 一部のツールが参照する可能性はあるが、公式の記述はない |
llms.txtの効果と位置づけ:分かっていること、それでも置く価値がある場面
llms.txtを置いたことでAIの回答に引用されやすくなった、と示す公式情報も、条件をそろえた比較実験も、本記事の作成時点では見つけられていません。効果は「不明」というより、「主要事業者が使わないと述べているか、使うと述べていない」状況です。それでも、費用がほぼかからず、技術文書では用途があり、作る過程がサイトの棚卸しになるため、30分なら使う価値があります。
公式に確認できる効果はない
Googleは、置いても表示にも順位にも影響しないと明記し、OpenAI・Anthropic・Perplexityは読むとも読まないとも書いていません。「効果がある」と主張しているのは、提案に賛同するツール提供者や、作成を代行する事業者が中心です。公式の裏付けがない以上、llms.txtを置いたことを成果として社内に報告するのは避けてください。
第三者の調査が示す取得の実態
取得の実態を示す調査としては、Ahrefsが137,210ドメインを対象にサーバーログを集計した調査(2026年6月15日公開、8月27日更新)があります。対象はAhrefsのアクセス解析を導入しているドメインで、2026年5月分のログを見たものです。公開していたドメインは28%にあたる約3.8万で、その97%には5月中に1件の要求も届いていませんでした。
取得があったファイルについても、要求の96%はボットからで、名前の分かるAIボットは全体の19.5%にとどまります。内訳は、エージェント系が10.5%、学習用クローラーが5.3%(GPTBotが4.51%、ClaudeBotが0.8%)、AIアシスタントが2.5%、AI検索の取得ボットが1.1%で、SEOの監査ツール(21.7%。Ahrefs自身のクローラーを含む)のほうがAIボットより多く取りに来ていました。
読むときの注意は、著者自身が記しています。対象がSEOに明るい利用者に偏るため28%は上限とみること、ファイルが仕様に沿っているかは確かめていないこと、取得は読まれたことと同じではないこと、AIの回答での引用や流入との関係は測っていないことです。調査を読むときは、対象、期間、指標(取得の有無か、AIの回答での引用か)の3点を見ます。取得は1段階目にすぎず、リンク先の本文が読めなければ引用には至りません。
それでも作る4つの理由
- 低コストである:主要ページ10〜30本に1行ずつ説明を書く作業で、既存のページには何も影響しません。
- 技術文書では実際に使われている:開発者がAIツールに文書を読み込ませる場面があり、本記事で開いた5社の採用はこの用途です。
- 主要ページの棚卸しになる:「AIに最初に読ませたいページはどれか」「1行で説明できるか」という問いは、サイトの点検そのものです。
- 将来の変化に備えられる:ファイルと更新の手順を用意しておけば、どの事業者が対応を表明しても、その日から対象になります。
代わりにならないもの
llms.txtを置いても、次の3つは代替できません。
- クロールできる状態:検索用のクローラーをrobots.txtやCDNで止めていれば、案内文があっても本文は読まれません。
- 引用に値する内容:AIが答えの根拠に選ぶのは、独自の情報、明確な答え、信頼できる発信者を備えたページです。
- 検索エンジンでの評価:インデックスに入っていないページは、案内に載せても候補になりません。
AIの回答に自社が選ばれるための全体像はLLMOの記事で、自社で点検を進める手順はLLMO対策チェックリストの記事でまとめています。llms.txtは、その中の「技術的な土台」の末尾に付け足す1項目という位置づけです。
優先順位の付け方
| 自社の状況 | llms.txtの優先度 | 先にやること |
|---|---|---|
| 開発者向けの技術文書、API仕様、操作マニュアルを公開している | 高い。llms-full.txtも検討 | 文書のMarkdown版の提供 |
| 製品やサービスの情報ページが中心のBtoBサイト | 中。30分で作り、四半期ごとに見直す | 検索用クローラーの許可、主要ページの内容の充実 |
| 記事中心のオウンドメディア | 中〜低。柱となる記事だけを載せる | 一次情報の追加、著者と更新日の明示 |
| 検索用のAIクローラーを止めている、または主要な情報を画像やPDFでしか載せていない | 低。先に土台を直す | robots.txtの見直し、HTMLでの情報の記載 |
| サイトを公開したばかりで、インデックスが進んでいない | 低 | サイトマップの送信、内部リンクの整備 |
本当に効くのはrobots.txt:AIクローラーの許可と拒否の決め方
AIとの関係で実際に結果が変わる設定は、llms.txtではなくrobots.txtです。検索用のクローラーを拒否すれば、そのAIの検索回答から自社が消えます。学習用だけを拒否しても、検索への表示は変わりません。この2つを分けて方針を決め、名前ごとに書き分けるのが、この章の要点です。
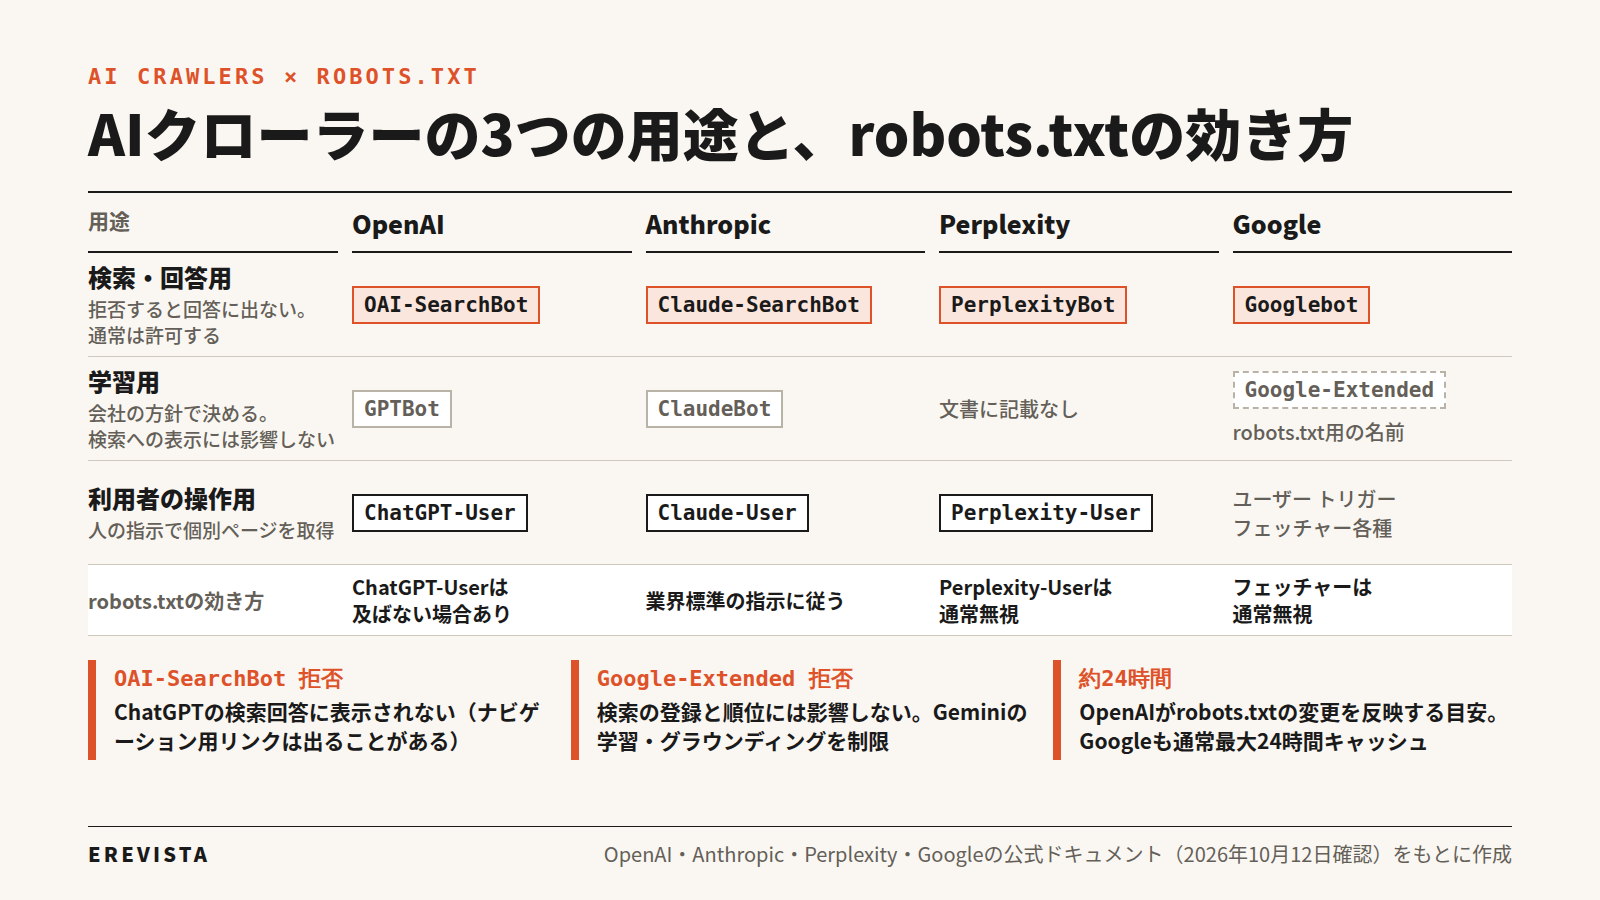
図:AIクローラーの区分とrobots.txtの効き方(OpenAI、Anthropic、Perplexity、Googleの公式ドキュメントをもとに作成、2026年10月12日確認)
学習用と検索・回答用を分けて考える
AI事業者のクローラーは、目的ごとに名前が分かれています。学習用を拒否することは「自社の文章をモデルの学習に使わせない」という意思表示で、検索・回答用を拒否することは「AIの回答に自社を出さない」という選択です。学習への利用の是非は法務や経営の判断事項、回答への表示は集客に直接関わる事項なので、企業のマーケティングの立場では通常、後者を許可したまま前者だけを判断します。
Googleの場合:Googlebot、Google-Extended、Search Consoleの設定
Googleには、名前の異なる3つの制御があり、役割を取り違えると意図と逆の結果になります。
Googlebotは、Googleが公開するクローラーの一覧ページ(最終更新は2026年9月16日)によれば、Discoverとすべての検索機能を含むGoogle検索のためのクローラーです。AIによる概要とAIモードは検索の機能なので、Googlebotを拒否すると、通常の検索結果だけでなくこれらの材料にもなりません。
Google-Extendedは、同じ一覧で、クローラーではなくrobots.txtに書くための独立した名前(プロダクト トークン)として説明されています。制御できるのは、次世代のGeminiモデルの学習への利用、Geminiアプリでのグラウンディング(事実確認と関連性向上のために検索インデックスの内容をモデルに提供すること)、Vertex AIでのGoogle検索によるグラウンディングの3つです。
そして、Google-ExtendedがGoogle検索でのサイトの登録に影響したり、ランキングシグナルとして使われたりすることはない、と明言されています。AIによる概要やAIモードとの関係を述べた文は、この一覧にはありません。この名前は2023年9月28日の公式ブログで、BardとVertex AIの生成APIを改善するためにサイトを使わせるかどうかの制御として登場しました。
検索の生成AI機能への表示を止めたい場合の正式な手段は、Search Consoleの「検索の生成 AI 設定」です。初期値は「含める」で、「除外する」を選ぶとAIによる概要とAIモードに加えて、Discoverの生成AI機能からも外れます。ヘルプには、この設定はAIのトレーニングには影響しないとあり、学習を制限したい場合はGoogle-Extendedを使うよう促しています。
| 制御の名前 | 設定する場所 | 止まるもの | 止まらないもの |
|---|---|---|---|
| Googlebot | robots.txt | 検索結果、AIによる概要、AIモードを含む検索の全機能 | Geminiアプリなど検索以外の利用 |
| Google-Extended | robots.txt | Geminiモデルの学習、GeminiアプリとVertex AIでのグラウンディング | 検索への登録と順位。AIによる概要とAIモードへの影響は文書に記載なし |
| 検索の生成AI設定 | Search Console | AIによる概要・AIモード・Discoverの生成AI機能への表示 | AIの学習、通常の検索結果 |
OpenAIの場合:OAI-SearchBot、GPTBot、ChatGPT-User
OpenAIのクローラーの解説は、3つの名前を使い分けています。OAI-SearchBotは検索のためのもので、これを拒否したサイトはChatGPTの検索回答に表示されません(ナビゲーション用のリンクとして出ることはあります)。GPTBotは学習用で、拒否すれば自社の内容を学習に使わないよう求める合図になります。
ChatGPT-Userは利用者の操作で動くもので、robots.txtが及ばない場合があります。設定は一つずつ独立して効くため、OAI-SearchBotを許可しながらGPTBotを拒否する組み合わせが可能で、反映の目安は約24時間です。
公開者向けFAQによれば、拒否したページでも、第三者の検索事業者やほかのページのクロールからそのURLを把握し、質問に関係すると判断すれば、ブラウザのChatGPT Atlasではタイトルとリンクだけを出すことがあります。これも防ぎたい場合はnoindexのメタタグを使う方法が示されていますが、メタタグを読んでもらうにはクロールを許可しておく必要があるため、robots.txtの拒否と重ねては使えません。
AnthropicとPerplexityの場合:名前と役割
Anthropicが公開するヘルプ記事と、Perplexityの解説によると、両社の名前と役割は次の通りです。考え方はOpenAIと同じで、検索用は許可し、学習用だけを方針に沿って決めます。Perplexityの文書に、学習用の名前はありません。
| 名前 | 運用する事業者 | 役割(公式文書の説明) | 拒否したときの影響(公式文書の説明) |
|---|---|---|---|
| ClaudeBot | Anthropic | 生成AIモデルの有用性と安全性を高めるための収集。学習に使われ得る | 今後の内容を学習データから除外するという意思表示になる |
| Claude-SearchBot | Anthropic | 利用者向けの検索結果の品質を高めるためにウェブを巡回 | 検索向けの索引に自社の内容が入らなくなる |
| Claude-User | Anthropic | 利用者がClaudeに質問したとき、回答のためにページを取りに行く | 質問に応じた取得が止まる |
| PerplexityBot | Perplexity | 検索結果にサイトを出すためのクローラー。学習用ではない | 検索結果に出すには許可するよう推奨されている |
| Perplexity-User | Perplexity | 利用者の操作に応じてページを取得。学習用ではない | 利用者の要求による取得のため、通常robots.txtを無視する |
方針別の設定表
自社の方針を3つから選び、名前ごとに書き分けます。表はGoogleとOpenAIの4つの名前で示しますが、AnthropicとPerplexityの名前も同じ列の考え方で追加できます。名前と役割は、設定の前に各社の最新の文書で確かめてください。
| 方針 | Googlebot | Google-Extended | OAI-SearchBot | GPTBot | 結果 |
|---|---|---|---|---|---|
| A. 検索にも回答にも出し、学習にも使ってよい | 許可 | 許可 | 許可 | 許可 | AIの回答に出る機会が最大。内容が学習に使われ得る |
| B. 検索と回答には出すが、学習には使わせない | 許可 | 拒否 | 許可 | 拒否 | 検索とAIの回答への表示は維持。Geminiモデルの学習とGeminiアプリでのグラウンディング、OpenAIのモデル学習は制限 |
| C. AIの回答には出さない | 許可(検索は維持) | 拒否 | 拒否 | 拒否 | Googleの検索結果には残るが、ChatGPTの検索回答から消える。Googleの生成AI機能はSearch Consoleの設定で除外する |
本記事の提案としては、方針Bが多くの企業サイトにとって妥当な出発点です。ただし、Google-Extendedの拒否でAIによる概要とAIモードへの表示が止まるとはGoogleの文書に書かれていない点(止めるならSearch Consoleの設定)、そしてGeminiアプリでのグラウンディングは止まる点を、社内で共有しておいてください。
robots.txtの書き方と、よくある書き損じ
書式は、User-agentの行にクローラーの名前を書き、続くAllowまたはDisallowの行で対象のパスを指定する形です。Disallowにスラッシュ1文字だけを書くと、サイト全体の拒否を意味します。書き損じで多いのは次の3つです。
- すべてのクローラーを指す「*」のグループにサイト全体の拒否が残っている(テスト環境の設定を本番に持ち込んだ場合など)
- AIと名の付くクローラーを一括で拒否し、検索・回答用まで止めている
- CDN(配信を中継するサービス)やWAF(不正な通信を遮る仕組み)の「AIボットをブロック」という機能が有効で、robots.txtを直しても通信が届かない
robots.txtの限界と、変更後の確認
robots.txtは「お願い」であって、アクセス制御ではありません。従うかどうかはクローラー次第で、利用者の指示で動く取得には及ばない場合があります。公開してはいけない情報は、認証や非公開の設定で守ります。
変更後は、Search Consoleのrobots.txt レポートで、Googleが取得した最新版と構文の警告やエラーを見ます。特定のURLがブロックされているかは、URL検査ツールで調べられます。OpenAI側は約24時間で反映されるため、翌日以降にChatGPTで自社名を含む質問を試し、出典に自社サイトが現れるかを見てください。
llms.txtの書き方:8つの手順と想定例
llms.txtの作成は、ページを選び、1行で説明し、節に分けて並べ、最上位に置いて確かめる、という8つの手順で進めます。所要時間の目安は、ページ数が30本以内なら30分、llms-full.txtまで作るなら半日です。
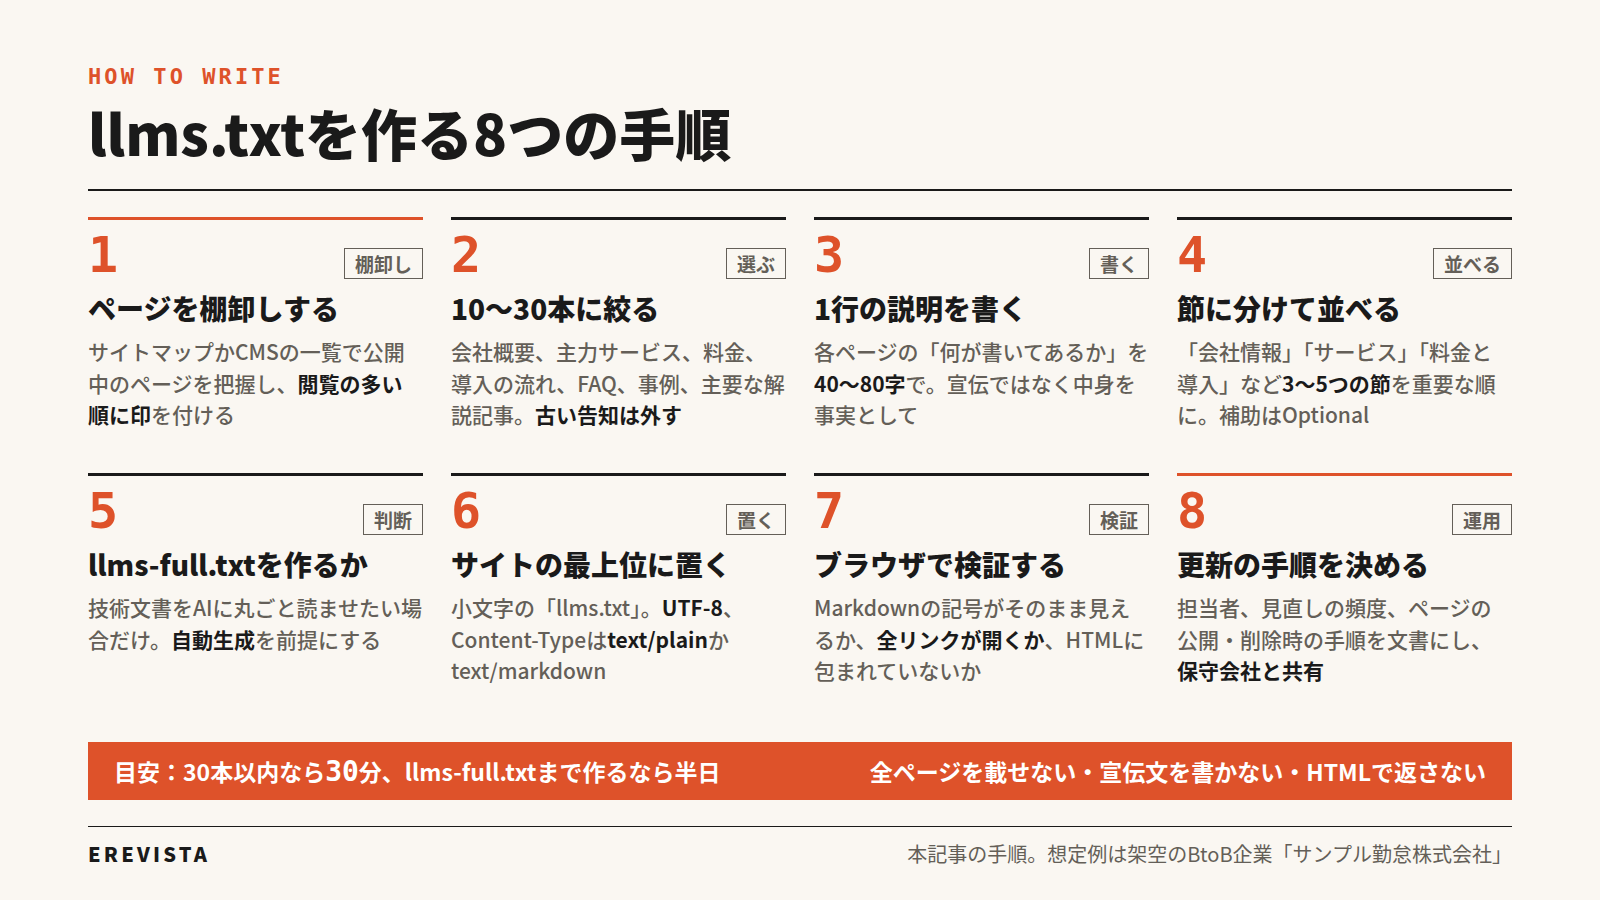
図:llms.txtの作成8ステップ(本記事の手順)
作成の8ステップ
- ページを棚卸しする:サイトマップかCMSの一覧で公開中のページを把握し、閲覧の多いページに印を付ける。
- 載せるページを10〜30本に絞る:会社概要と主力サービス、料金表、導入の流れ、よくある質問、代表的な事例、主要な解説記事を優先し、古い告知は外す。
- 1行の説明を書く:各ページの「何が書いてあるか」を40〜80字で、宣伝ではなく中身として述べる。
- 節に分けて並べる:「会社情報」「サービス」「料金と導入」「資料と事例」のように3〜5つの節を作り、重要な順に置く。補助的なリンクは「Optional」の節にまとめる。
- llms-full.txtを作るか決める:技術文書をAIに丸ごと読ませたい場合だけ、自動生成の仕組みとともに作る。
- サイトの最上位に置く:ファイル名は小文字で「llms.txt」とし、「自社ドメイン名/llms.txt」で開ける場所に置く(第2版では「/docs/llms.txt」のように階層の途中に置き、その配下だけを対象にすることもできる)。UTF-8で保存し、Content-Typeはtext/plainまたはtext/markdownにする。
- 検証する:ブラウザで開き、Markdownの記号がそのまま表示されるか、全リンクが開くか、HTMLに包まれていないかを確かめる。
- 更新の手順を決める:担当者、見直しの頻度、ページの公開・削除時の更新手順を文書にし、保守会社や社内のIT担当と共有する。
想定例:架空のBtoB企業「サンプル勤怠株式会社」のllms.txt
以下は、勤怠管理システムを売る架空の会社を想定した例です。社名、製品名、URL、数字はすべて架空で、実在の企業や製品とは関係ありません。
- 1行目:# サンプル勤怠株式会社
- 2行目:> 従業員30〜300名の企業向けに、クラウド型の勤怠管理システム「サンプル勤怠」を提供する会社です。スマートフォンでの打刻、シフト管理、給与計算ソフトとの連携に対応し、導入から運用開始までの標準期間は4週間です。
- 節1:## 会社情報
- 「- [会社概要](https://example.co.jp/company/): 所在地、設立年、代表者、従業員数、事業内容を掲載しています。」
- 「- [お問い合わせ](https://example.co.jp/contact/): 資料請求と無料トライアルの申し込み窓口です。営業時間と返答までの日数を記載しています。」
- 節2:## サービス
- 「- [サンプル勤怠の機能一覧](https://example.co.jp/product/features/): 打刻方法、シフト作成、残業の自動集計、有給休暇の管理など全機能の説明です。」
- 節3:## 料金と導入
- 「- [料金プラン](https://example.co.jp/pricing/): 1ユーザーあたりの月額料金、初期費用、無料トライアルの条件を掲載しています。」
- 「- [導入の流れ](https://example.co.jp/onboarding/): 契約から運用開始までの4週間の標準スケジュールと、お客様側の準備事項です。」
- 「- [よくある質問](https://example.co.jp/faq/): 対応する雇用形態、他社サービスからの移行、解約の条件など、問い合わせの多い質問と回答です。」
- 節4:## 導入事例と資料
- 「- [導入事例一覧](https://example.co.jp/cases/): 業種別の導入事例と、導入前の課題、導入後の変化を掲載しています。」
- 節5:## Optional
- 「- [お知らせ一覧](https://example.co.jp/news/): 機能追加やメンテナンスの告知です。」
実際のファイルでは、行頭の「1行目」「節1」といった案内は書かず、全体で20〜30行に収めます。
1行説明の書き方のコツ
説明の良し悪しは、「ページを開かずに、質問に合うページを選べるか」で決まります。
- 中身を列挙する事実の文にする:「料金プランを掲載」ではなく、「月額料金、初期費用、無料トライアルの条件を掲載」と書く
- ページ名と重複させない:ページ名が「料金プラン」なら、説明に「料金プランのページです」とは書かない
- 数字や条件を含める:対象人数、標準期間など、ページにある具体的な値を入れる。「業界最高水準」のような評価の言葉は使わない
よくある失敗と、CMS・WordPressでの注意点
失敗の多くは、「全部載せる」「宣伝文を書く」「更新しない」「読みに来るボットを止めている」「HTMLで返している」の5つに集約されます。どれも、ファイルの目的が「AIが読む案内」であることを忘れたときに起こります。
失敗1:サイトの全ページを載せる
全ページを載せたllms.txtは、説明のないサイトマップと同じです。案内の価値は選別にあり、載せるのは問い合わせや比較の場面で参照されるページに限ります。
失敗2:説明文が宣伝のコピーになっている
「業界をリードする」「圧倒的な使いやすさ」といった表現は、ページの中身を伝えず、AIがページを選ぶ手がかりにもなりません。説明には、対象、機能、条件、数字といった事実だけを書きます。
失敗3:リンク切れと古い内容が残る
サイトの改修でURLが変わったのに、llms.txtだけが古いままになる例は多く見られます。開けないリンクは信頼を下げ、料金の数字が本文と食い違えば誤情報の出どころになります。公開・削除・URL変更の手順にllms.txtの更新を組み込み、四半期に1回は全リンクを機械的に確認します。
失敗4:読みに来るはずのボットをrobots.txtで止めている
robots.txtでAIと名の付くクローラーを一括で拒否していれば、案内もリンク先の本文も読まれません。検索・回答用のクローラーは許可し、学習用だけを方針に沿って判断します。CDNやWAFの遮断機能も見ておきます。
失敗5:テキストではなくHTMLで返している
CMSによっては、「/llms.txt」というURLが固定ページとして処理され、ヘッダーやフッターを含むHTMLで返されることがあります。見た目は表示されていても中身はMarkdownではないので、ブラウザでソースを表示し、HTMLのタグが付いていないかを見ます。
WordPressなどCMSでの置き方
置き方は3通りあります。どの方法でも、公開後に「自社ドメイン名/llms.txt」をブラウザで開き、手順7の検証を行ってください。プラグインは多くありますが、本記事ではそれぞれの機能や効果の主張を確認していないため、個別の名前は挙げません。
| 方法 | 手順 | 向いている場合 | 注意点 |
|---|---|---|---|
| サーバーに直接置く | FTPや管理画面のファイルマネージャーで、公開ディレクトリの最上位にllms.txtをアップロードする | 自社でサーバーを管理している | CMSの書き換え規則(リライトルール)が.txtを横取りしないかを確認する |
| CMSの機能やプラグインで生成する | 対応するプラグインやテーマの機能で、投稿やページから自動生成する | ページの追加・削除が多い | 全ページを自動で載せる設定は避け、対象を手で選ぶ。「AIに読まれる」という宣伝文句があっても、効果は本記事の説明のとおり未確認 |
| 保守会社やIT担当に依頼する | 載せるページと説明文の一覧を渡し、配置と検証を依頼する | 自社でサーバーを触れない | 依頼書に、ファイル名、置き場所、Content-Type、文字コードの4点を明記する |
読まれたかを確かめる方法と、運用の決め方
llms.txtが取得されたかどうかは、サーバーのアクセスログで「/llms.txt」へのリクエストを、User-Agent(アクセス元のプログラムが名乗る名前)ごとに数えれば分かります。アクセス解析ツールでは分かりません。
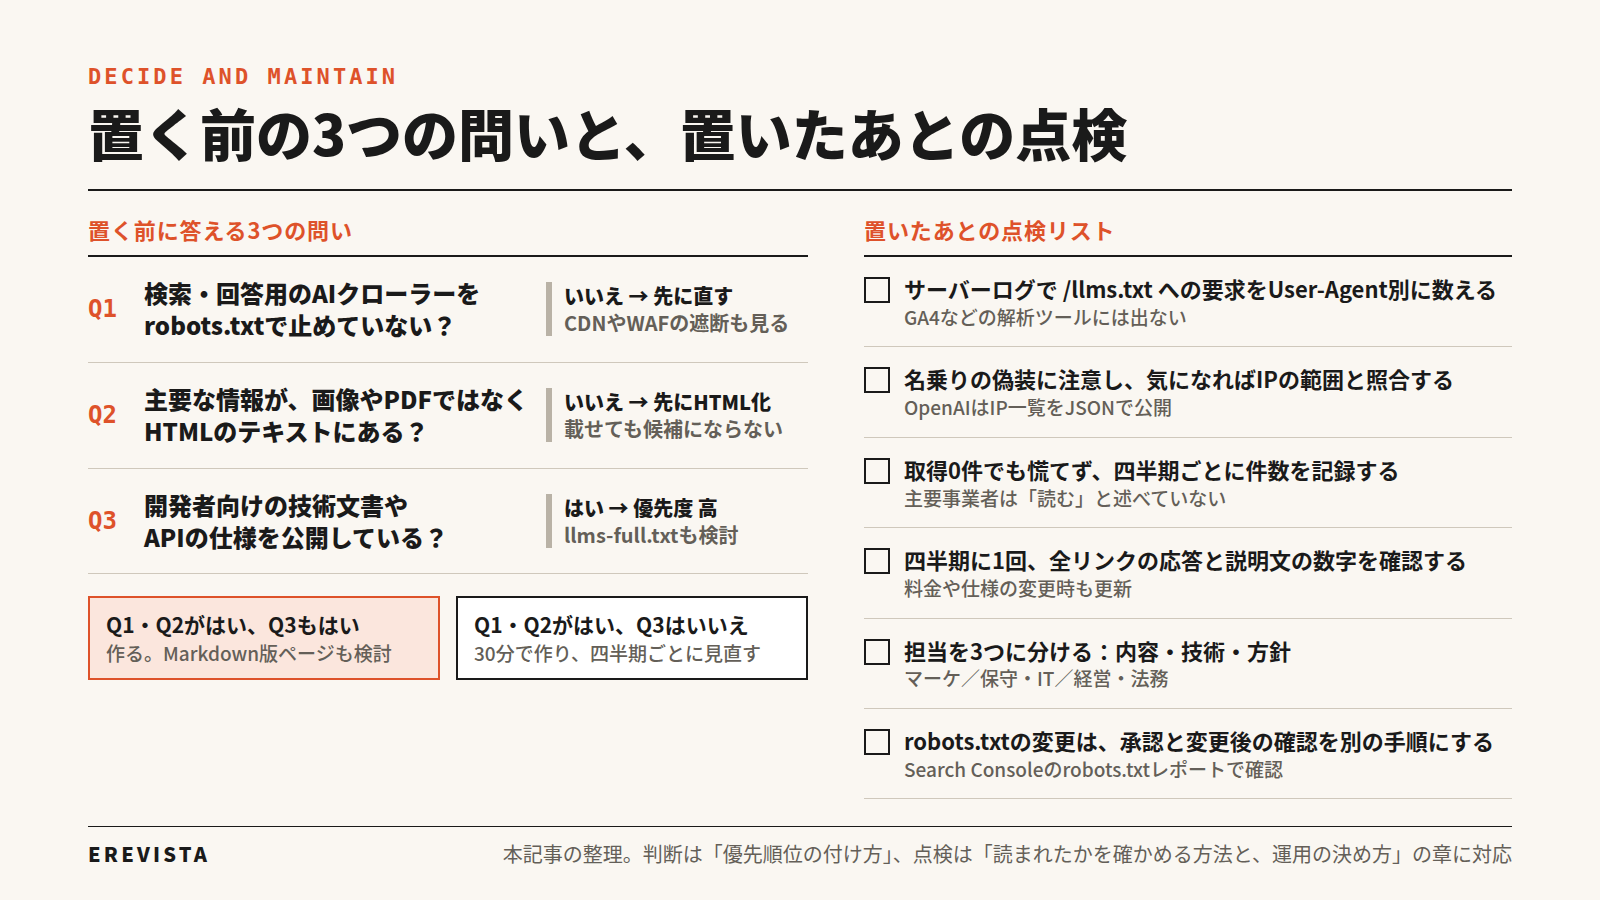
図:置く前の3つの問いと、置いたあとの点検項目(本記事の整理)
サーバーログでUser-Agentを見る
GA4などのアクセス解析ツールは、ブラウザで動く計測タグに依存するため、テキストファイルへのアクセスを記録しません。見るのはサーバー側のログです。
- リクエストされたパスが「/llms.txt」または「/llms-full.txt」である行を抽出する
- User-Agentの文字列ごとに件数を集計する
- 月ごとに並べ、どのプログラムが何回取得したかを表にする
名乗り方は各社の文書に載っています。OpenAIの解説によれば、検索用は「OAI-SearchBot/1.4」、学習用は「GPTBot/1.4」、利用者の操作による取得は「ChatGPT-User/1.0」という文字列を含みます。前述の各社の文書によれば、Anthropicの3つはClaudeBot、Claude-SearchBot、Claude-User、Perplexityの2つはPerplexityBotとPerplexity-Userという名前を名乗ります。Google-Extendedはrobots.txtに書くための名前であり、ログにこの名前が現れることはありません。
名乗りは偽装されることがある
User-Agentは自己申告なので、無関係なプログラムが有名なクローラーの名前を名乗ることがあります。Googleもユーザー トリガー フェッチャーの文書で、文字列は偽装され得ると注意しています。OpenAIはクローラーごとのIPアドレスの一覧をJSON形式で公開しているので、件数が気になるときはIPの範囲と照らし合わせます。
取得が0件でも、慌てない
公開から数か月たっても取得が0件、という結果は珍しくありません。主要事業者はこのファイルを読むと述べていないからです。四半期ごとに件数を記録し、変化が出たときに調べれば十分です。
誰がファイルを持つか
役割は3つに分かれます。
- 内容の責任者(マーケティング):載せるページと説明文を決め、四半期ごとに見直す
- 技術の担当(保守会社・IT担当):配置、Content-Type、リンクの自動確認、ログの抽出を行う
- 方針の決定者(経営・法務):学習用クローラーへの対応方針を決め、robots.txtの記述に反映する
robots.txtの変更は影響が大きいため、llms.txtとは別に、変更前の承認と変更後の確認を手順に入れてください。
見直しのタイミング
| タイミング | 行うこと |
|---|---|
| 主要ページの公開・削除・URL変更のたび | llms.txtの該当行を追加・削除・修正する |
| 四半期に1回 | 全リンクの応答を機械的に確認し、説明文の数字を本文と照合する。ログの取得件数を記録する |
| 料金や主要な仕様の変更時 | 引用ブロックと説明文の数字を更新する |
| AI事業者が公式文書を更新したとき | llms.txtへの言及が加わったかを確認し、robots.txtのクローラー名の変更も反映する |
| 年に1回 | 載せるページの顔ぶれと節の構成を見直す |
よくある質問(FAQ)
llms.txtを置けばAIに引用される?
いいえ。引用されやすくなるという公式の説明は、本記事の作成時点ではありません。Googleは検索で使わないと明記し、OpenAI・Anthropic・Perplexityのクローラー解説にも読むという記載はありません。引用を左右するのは、クロールできること、内容が質問に合い信頼できること、第三者にも語られていることです。
robots.txtと両方必要?
robots.txtは必要で、llms.txtは任意です。robots.txtは検索エンジンとAIのクローラーが入ってよい場所を伝えるファイルで、AIの回答に自社を出すかどうかにも関わります。点検の順番は、robots.txtが先です。
llms-full.txtは必要?
多くの企業サイトには不要です。llms-full.txtは提案ページに定義がなく、AnthropicやVercelの文書サイトのように、採用する側で広まった慣行です。必要になるのは、APIの仕様や操作手順のような技術文書を、開発者がAIツールに丸ごと読み込ませる場面があるサイトです。作る場合は、公開中の文書から自動生成し、手作業で維持しない前提にしてください。
GoogleはAIモードでllms.txtを見る?
見ません。Googleの生成AI機能向けのガイドは、Google検索ではこのファイルが無視され、表示にも順位にも影響しないと述べています。AIモードに出るための前提は、インデックス登録済みで、スニペットを表示でき、Search Consoleの設定で生成AI機能に含めていることです。
日本語で書いてよい?
構いません。書式の記号(#、>、-、角かっこ、丸かっこ、コロン)は半角で書き、見出しや説明文は日本語で書けます。AIに質問する人が日本語を使うなら、説明も日本語のほうが質問との照合に向きます。
サイトマップがあれば、llms.txtは要らない?
役割が違うため、置き換えにはなりません。サイトマップは登録を望むURLを網羅的に渡す一覧で、llms.txtは選んだ少数のページに一行の説明を添える案内です。ただし、サイトマップは検索エンジンが実際に使う仕組みであり、llms.txtは使う事業者が確認されていないという違いがあります。
作成を外部に頼むと費用はかかる?
内容を決めるのは社内でできる作業なので、外部に頼む部分は配置と検証に限られます。載せるページの一覧と説明文を自社で用意し、配置だけを保守契約の範囲で依頼するのが、出費を抑える方法です。「AIに読まれる状態にする」と成果を約束する提案には、どの事業者の文書を根拠にしているかを尋ねてください。
置いてあるかどうかを調べる方法は?
ブラウザで「自社ドメイン名/llms.txt」を開きます。Markdownの記号がそのまま表示されれば置かれています。HTMLのページや404が返る場合は、置かれていないか、CMSが別の処理をしています。競合のサイトも同じ方法で見られますが、置いてあることと効果があることは別です。
まとめ:llms.txtは「置いて損はないが、成果を期待しない」ファイル
llms.txtは、AI向けのサイト案内として提案された低コストのファイルで、2026年10月の段階では主要事業者が使うと表明していない、という位置づけです。要点は次の6つです。
- llms.txtは、サイトの概要と主要ページのリンクをMarkdownで書き、最上位に置く提案段階の取り決め。2024年9月の初版、2026年8月の第2版とも必須はH1だけ
- Googleは、検索では無視し、表示にも順位にも影響しないと明記。各社(OpenAI、Perplexity、Anthropic)のクローラー解説に読むという記載はない
- robots.txt、サイトマップ、構造化データのどれとも役割が違い、置き換えにはならない
- 実際に結果が変わるのはrobots.txt。検索・回答用のクローラーは許可し、学習用は方針に沿って判断する
- 作るなら、主要ページ10〜30本に事実だけの1行説明を添え、四半期ごとに見直す。全ページを載せない、宣伝文を書かない、HTMLで返さない
- 効果は取得のログで確かめ、引用の増減とは切り離して評価する
最初の一歩は、自社のrobots.txtを開き、回答や検索に使われるAIクローラーをうっかり止めていないかの確認です。それが済んでから、主要ページ10本を選んで1行ずつ説明を書けば、llms.txtの初版は30分で完成します。
「AIの答えに選ばれているか」を先に確かめる資料
llms.txtの設置より前に確かめたいのは、AIに自社が出てくるか、その情報が正しいかです。EREVISTAの資料「【AIO・LLMO】AIが“答え”を出す時代、その答えに選ばれているか」は、「AIに聞いても自社が出てこない」をはじめとする3つの“あるある”を起点に、引用される4条件と最初の90日の進め方を示した資料です。お役立ち資料のページのフォームからお受け取りください。
出典・参考資料
記事内のデータは2026年10月12日時点で確認したものです。
- llms.txt 提案ページ「The /llms.txt file, v2」(2024年9月3日公開、2026年8月10日更新、著者 Jeremy Howard)
- llms.txt 提案ページ「Changes」(v2、2026年8月)
- GitHub(AnswerDotAI)「llms-txt: The /llms.txt file, helping language models use your website」(2026年10月12日閲覧)
- OpenAI Developers「llms.txt」(2026年10月12日閲覧)
- OpenAI Developers「OpenAI Developers」(2026年10月12日閲覧)
- Anthropic(Claude Developer Platform)「llms.txt」(2026年10月12日閲覧。docs.anthropic.com/llms.txt から転送)
- Cloudflare Docs「llms.txt」(2026年10月12日閲覧)
- Perplexity Docs「llms.txt」(2026年10月12日閲覧)
- Vercel「llms.txt」(2026年10月12日閲覧。vercel.com/docs/llms.txt から転送)
- Google 検索セントラル「Google 検索における生成 AI 機能に向けた最適化のための Google ガイド」(最終更新2026年10月9日)
- Google 検索セントラル「ドキュメントの最新の更新内容」(2026年5月15日、6月15日の項)
- Google 検索セントラル「AI 機能とウェブサイト」(最終更新2025年12月31日)
- Google 検索セントラル「Google の一般的なクローラー」(最終更新2026年9月16日)
- Google「Google ユーザー トリガー フェッチャー」(最終更新2026年5月14日)
- Google 検索セントラル「robots.txt の概要とガイド」(最終更新2025年12月18日)
- Google「Google による robots.txt の指定の解釈」(最終更新2026年9月11日)
- Google 検索セントラル「サイトマップについて」(最終更新2025年12月18日)
- Search Console ヘルプ「検索の生成 AI 設定」(2026年10月12日閲覧)
- Search Console ヘルプ「robots.txt レポート」(2026年10月12日閲覧)
- Google「New opportunities, control and insights for website owners」(2026年6月3日、8月31日更新)
- Google「An update on web publisher controls」(2023年9月28日)
- OpenAI「Overview of OpenAI Crawlers」(2026年10月12日閲覧)
- OpenAI Help Center「Searching the web with ChatGPT」(2026年10月12日閲覧)
- OpenAI Help Center「Publishers and Developers – FAQ」(2026年10月12日閲覧)
- Anthropic(Claude Help Center)「Does Anthropic crawl data from the web, and how can site owners block the crawler?」(最終更新2026年4月7日)
- Perplexity「Perplexity Crawlers」(2026年10月12日閲覧)
- Bing Webmaster Blog「Keeping Content Discoverable with Sitemaps in AI Powered Search」(2025年7月31日)
- Ahrefs「We Analyzed 137K Sites: 97% of llms.txt Files Never Get Read」(2026年6月15日公開、8月27日更新)