


エンティティとナレッジグラフとは?AIが会社を「一つの実体」として認識する仕組み
エンティティとは、人、組織、場所、製品、概念のように、名前の文字列とは切り離して「一つのもの」として識別できる対象のことで、ナレッジグラフとは、そのエンティティ同士を関係でつなぎ、事実を付けて蓄えたデータベースのことです。検索エンジンも生成AIも、社名という文字の並びではなく、「どの会社を指しているか」という単位で情報を集め、答えを組み立てます。
Googleは2012年にナレッジグラフを発表し、検索を「文字列ではなく、もの」を理解する仕組みへ切り替えました。一方で大規模言語モデル、略してLLMは、知名度の低い対象ほど事実を正しく答えられないことが研究で示されています。会社名の表記が場所ごとに違えば、機械の側では一つの会社が複数の実体に割れ、古い情報や他社の情報が混ざった説明が生まれます。
この記事は、「エンティティ」「ナレッジグラフ」の意味を調べているITや集客の実務者と、自社がAIにどう説明されているかを気にかける責任者の方が読者です。前半では2つの用語の定義、Googleのナレッジグラフの歴史とAPI、Wikidataなどの公開ナレッジグラフ、検索エンジンとLLMがエンティティを使う仕組みを整理します。後半では、会社が一つのものとして認識されるための7つの条件、自社の状態を点検する手順、混同の型と直し方、30-60-90日の進め方へ進みます。
目次
- エンティティとは:文字列ではなく「もの」を指す、識別できる単位
- ナレッジグラフとは:エンティティを関係でつなぎ、事実を蓄えた知識の網
- 公開ナレッジグラフと企業内ナレッジグラフ:Wikidata・DBpedia・YAGOと、社内データの名寄せ
- 検索エンジンはエンティティをどう使うか:クエリの意味理解からナレッジパネルまで
- LLMとエンティティ:言語モデルと知識グラフを組み合わせる研究が示すこと
- エンティティSEOとは:会社が「一つの実体」として認識されるための7つの条件
- 点検の手順:API、検索、AIへの5つの質問で自社のエンティティ状態を確かめる
- エンティティの一貫性を作る30-60-90日のロードマップ
- よくある質問(FAQ)
- まとめ:エンティティは「名前」ではなく「同じ事実の反復」で定まる
- 出典・参考資料

エンティティとナレッジグラフを数字でつかむ5つの事実
- Googleは2012年5月16日にナレッジグラフを発表し、当時の規模は5億を超えるオブジェクトと35億を超える事実でした(Google公式ブログ)。
- Wikimedia財団が運営する公開ナレッジグラフWikidataの項目数は、2026年11月1日に開いたトップページの表示で9,031万818件でした。
- GoogleのKnowledge Graph Search APIは、1回の検索で最大500件(既定は20件)のエンティティを返し、1プロジェクトあたり1日10万回まで無料で呼び出せます(公式リファレンス、2025年8月更新)。
- Meta Reality Labsの研究者が18,000問で16のLLMを試した研究(2024年4月改訂)では、GPT-4の正答率は知名度の高い対象で40.3%、低い対象で19.0%でした。
- 2026年2月に国内の消費者800名に行われた調査では、生成AIが誤った情報を答えた場合に、その企業や商品への信頼が「下がる」とした人は71.4%に達しました。
エンティティとは:文字列ではなく「もの」を指す、識別できる単位
エンティティとは、情報検索と知識表現の分野で、名前の書き方とは独立に「同じもの」として扱える対象を指す言葉で、会社、人物、場所、製品、作品、概念がこれに当たります。架空の会社を例にすると、同じ会社を「株式会社みどり測器」「みどり測器(株)」「Midori Sokki」と書いても、指しているものは一つです。この「一つであること」を機械が認識できる状態が、エンティティとして認識された状態です。
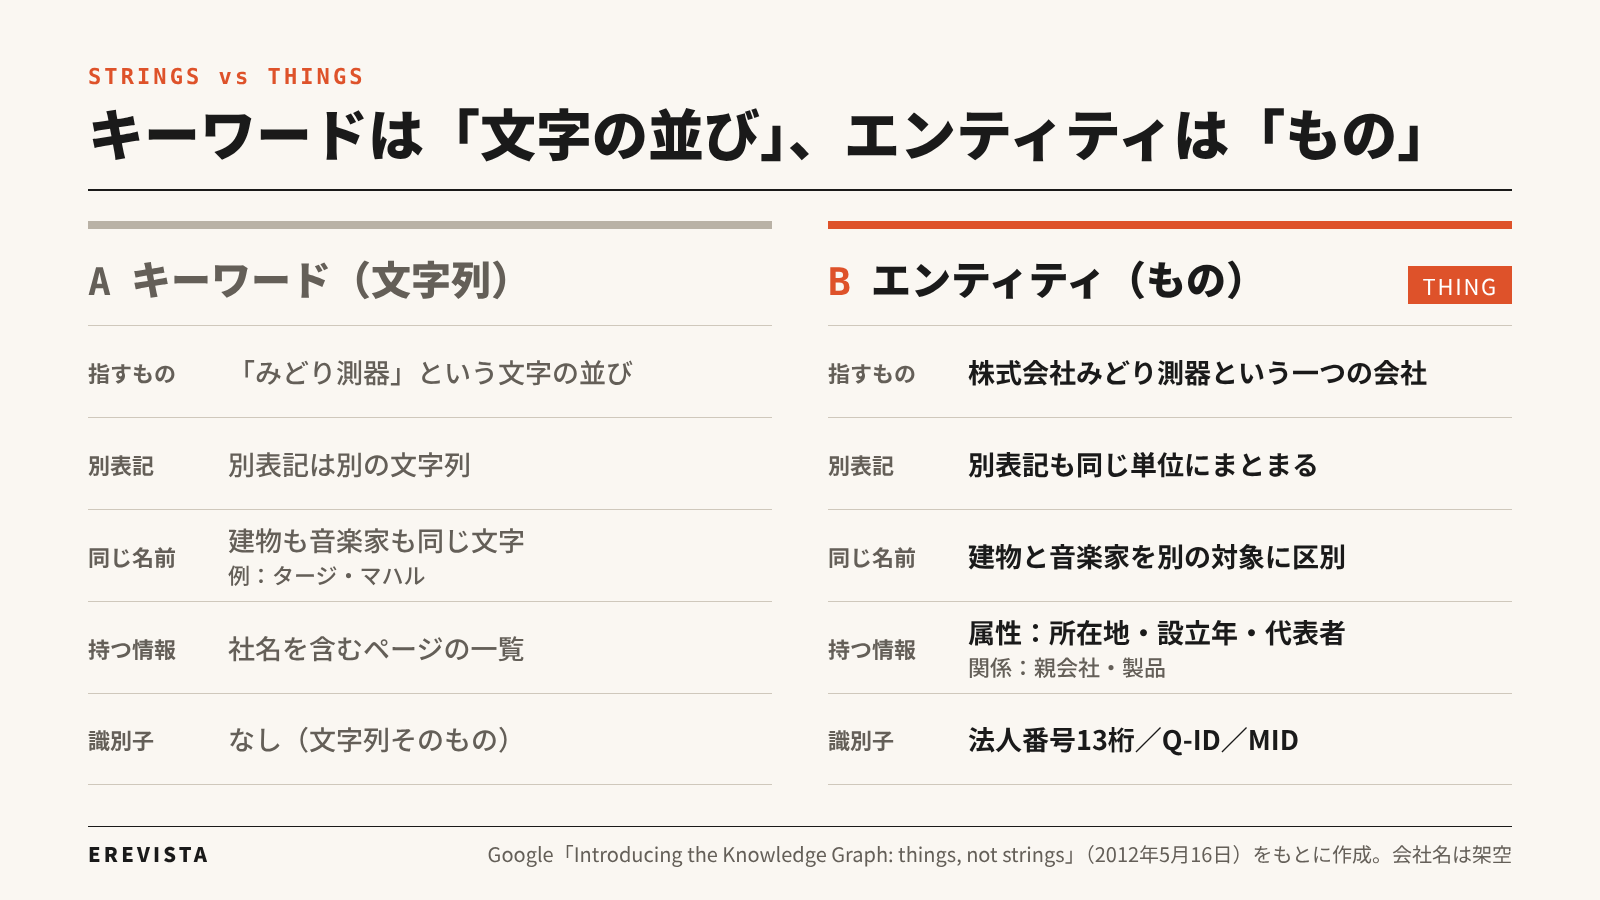
図:キーワード(文字列)とエンティティ(もの)の違い(Googleの2012年の発表「things, not strings」をもとに作成。会社名は架空)
情報検索と知識表現での定義
英語版Wikipediaの「Named entity(固有表現)」の項目は、固有表現を「人、場所、組織、製品などの実世界の対象で、固有名で指し示せるもの」と定義し、「抽象的なものでも、物理的に存在するものでもよい」と付け加えています。同じ項目は、「大統領」という語はさまざまな対象を指しうるため固有表現ではない、という例も示しています。役職や業種のような一般名詞は、単独ではエンティティに数えられません。
知識表現の側では、18人の研究者が書いた総説論文「Knowledge Graphs」(Hogan他、2021年改訂、ACM発行)が、ナレッジグラフの「ノードは関心のあるエンティティを表し、エッジはエンティティ間の関係を表す」と書いています。点がエンティティで線が関係、点に付く情報(所在地、設立年、代表者)が属性です。
Googleのクラウドサービスにも、同じ考え方が文書化されています。Google Cloud Natural Language APIのリファレンス(2025年6月13日更新)は、エンティティを「人、組織、場所など、既知のエンティティであるテキスト中の句」と定義しています。文章の中の「みどり測器」という句が、既知のどの対象を指すかを判定する、という使い方です。
キーワード(文字列)とエンティティ(もの)の違い
キーワードは文字の並びで、エンティティはその並びが指す対象です。Googleが2012年5月16日に公開した発表文は、この違いを「things, not strings(文字列ではなく、もの)」という言葉で表しました。発表文は、検索が40年以上にわたってキーワードの一致に基づいてきたと振り返り、ナレッジグラフによって「実世界のエンティティと、それらの相互関係」を理解するようになると述べています。
実務で効く違いを4つの観点で表にまとめます。
| 観点 | キーワード(文字列) | エンティティ(もの) |
|---|---|---|
| 単位 | 入力された文字の並び | 文字が指す対象。同義語や別表記は同じ単位にまとまる |
| 曖昧さ | 「タージ・マハル」が建物か音楽家かは区別しない | 建物と音楽家を別の対象として区別する |
| 情報の持ち方 | 文字列が含まれるページの一覧 | 対象に属性(所在地、設立年)と関係(親会社、代表者)が付く |
| 会社にとっての意味 | 社名を含むページが多いほど見つかりやすい | 社名の表記が違っても同じ会社だと認識される |
同名の会社・人物をどう区別するか(曖昧性解消)
同じ名前を持つ対象を見分ける処理を、曖昧性解消(ディスアンビギュエーション)と呼びます。Googleの2012年の発表文は、「タージ・マハルは建物か、音楽家か」という例を挙げ、ナレッジグラフによって「その違いを理解し、意図した一方だけに検索結果を絞れる」と説明しました。
会社の場合、手がかりになるのは名前以外の属性です。所在地、業種、設立年、代表者、親会社、公式サイトのドメインといった属性がそろって一致すれば同じ会社、食い違えば別の会社と判定しやすくなります。同名の会社が同じ市にあり、どちらも「製造業」としか書いていなければ、機械にとっては区別の材料がありません。英語版Wikipediaの「Knowledge graph」の項目も、別々のグラフにあるエンティティのうちどれが同じ実世界の対象かを解決することは「簡単ではない作業」だと述べています。
エンティティを一つに定める識別子:Q-ID、MID、法人番号
名前の代わりにエンティティを一つに定めるのが識別子です。Hogan他の総説は、エンティティを一意に識別するために「長期間持続する永続識別子(PID)」を作れると述べています。会社に関わる主な識別子は次のとおりです。
| 識別子 | 発行・管理 | 形 | 例 |
|---|---|---|---|
| Wikidataの項目ID | Wikidataの編集コミュニティ(Wikimedia財団が運営) | 大文字のQに続く整数 | Q303(エルヴィス・プレスリー) |
| Googleナレッジグラフの機械ID(MID) | /m/ または /g/ で始まる文字列 | kg:/m/0dl567(APIの応答例) | |
| 法人番号 | 国税庁長官が指定 | 13桁の数字 | 4000012090001(経済産業省) |
| LEI(法人識別子) | ISO 17442で定義 | 法人を一意に識別するコード | schema.orgではleiCodeとして記述 |
| DUNSナンバー | Dun & Bradstreet | 組織や事業者を識別する番号 | schema.orgではdunsとして記述 |
英語版Wikipediaの「Wikidata」の項目によると、Wikidataの各項目には「大文字のQを前に付けた正の整数」が、各プロパティ(属性の種類)には「大文字のPを前に付けた数字」が割り当てられます。たとえば「分類(instance of)」はP31です。Googleの機械IDについては、WikidataのプロパティP2671が「Google Knowledge Graph APIの識別子で、/g/ で始まる。/m/ で始まるIDはFreebase ID(P646)を使う」と説明しています。/m/ は旧Freebase由来のID、/g/ はそれ以外のGoogleのIDという区分です。
日本の会社にとって最も確実な公的識別子は法人番号です。国税庁の法人番号公表サイトによると、法人番号は「株式会社などの法人等が持つ13桁の番号」で、国税庁長官が指定し、本人に通知したうえで、商号または名称、本店または主たる事務所の所在地、法人番号の「基本3情報」を公表します。「利用範囲の制約がなく、誰でも自由に利用できます」という一文も同じページにあります。会社概要に法人番号を載せることは、同名の会社と自社を切り分ける、公的な根拠を置く作業です。
schema.orgの型は「名付けの語彙」
schema.orgは、エンティティの種類と属性を機械が読める形で書くための共通語彙で、組織、人、製品といった型(英語の型名はOrganization/Person/Product)を定めています。組織の型の定義ページ(バージョン30.1、2026年9月16日)は「学校、NGO、企業、クラブなどの組織」と説明し、その下に企業を表すCorporationや地域のビジネスを表す型、政府機関を表す型など20の下位の型を並べています。属性には、登記上の正式名称を書くlegalName、別名を書くalternateName、設立日、そして親組織と子組織を結ぶ2つのプロパティ(parentOrganizationとsubOrganization)があります。
エンティティの観点で最も重要なプロパティがsameAsです。schema.orgの定義は「その項目の同一性を明確に示す参照ウェブページのURL。例:その項目のWikipediaページ、Wikidataの項目、または公式ウェブサイトのURL」です。会社のマークアップにsameAsとして公式SNSやWikidataの項目を並べると、「このページの組織と、あのプロフィールの組織は同じ実体だ」と宣言できます。書き方と検証の手順は構造化データを主題にした記事に譲り、本記事では概念と、エンティティの観点で何を書くべきかにとどめます。
ナレッジグラフとは:エンティティを関係でつなぎ、事実を蓄えた知識の網
ナレッジグラフとは、エンティティを点、エンティティ間の関係を線として表し、「みどり測器の本店所在地は長野市である」といった事実を線の単位で蓄えたデータベースのことです。Googleのナレッジグラフは検索結果の材料になる非公開のもの、Wikidataは誰でも読み書きできる公開のもの、企業内ナレッジグラフは一つの会社の社内データを束ねたもので、同じ考え方が3つの場所で使われています。
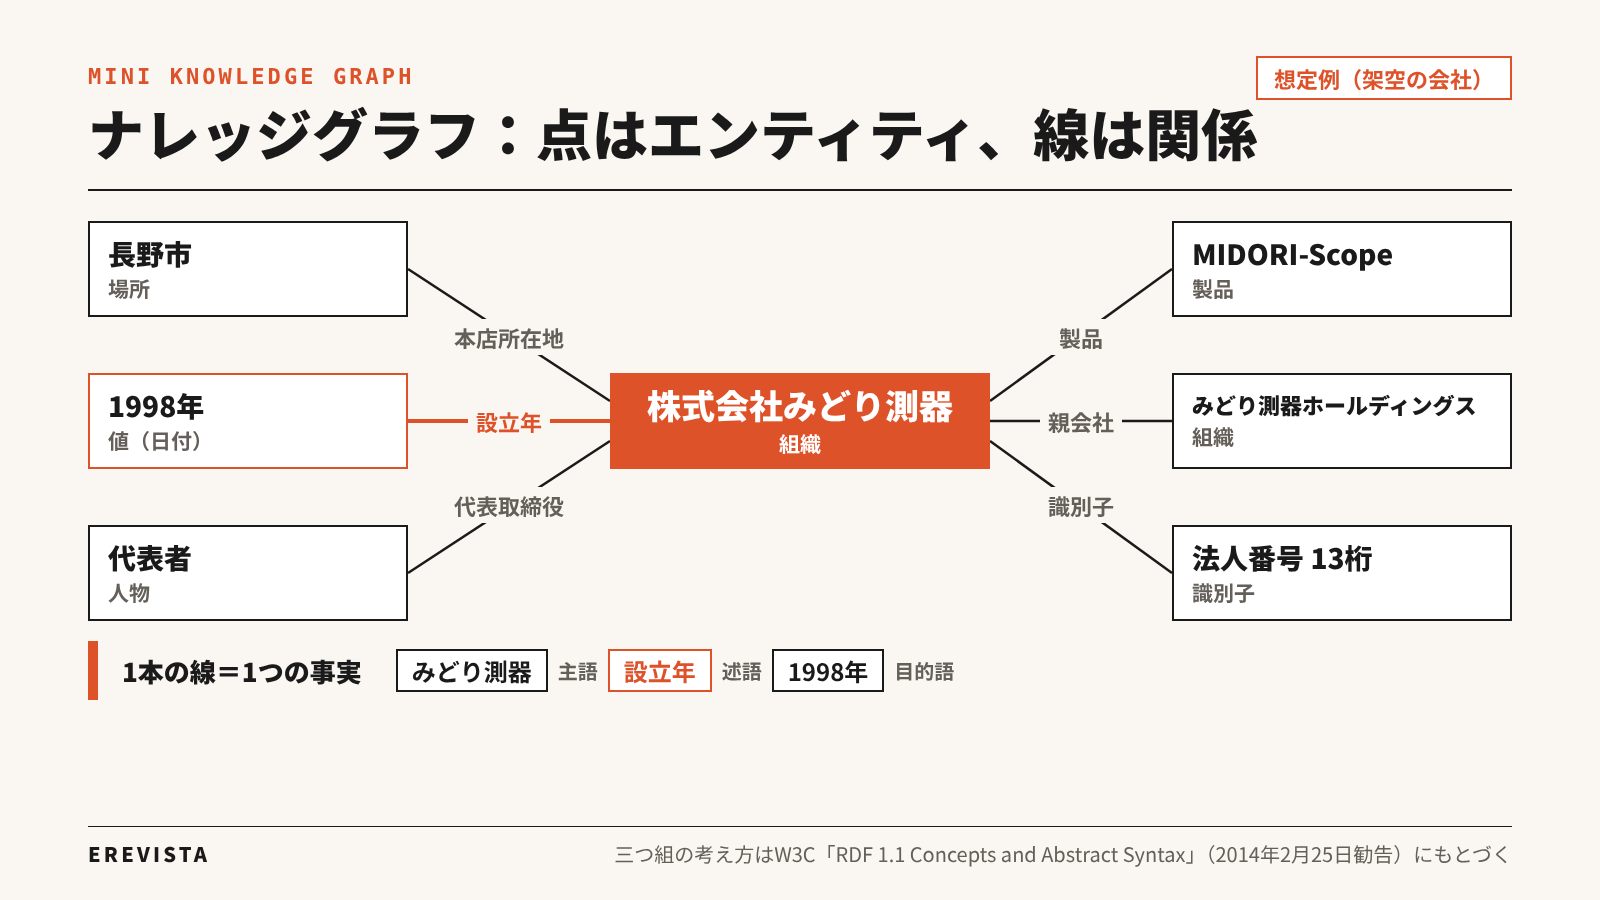
図:ナレッジグラフの考え方——エンティティを点、関係を線で表した想定例(架空の会社。三つ組の定義はW3C RDF 1.1をもとに作成)
定義:「主語・述語・目的語」の三つ組の集まり
ナレッジグラフの最小単位は、「主語、述語、目的語」の三つ組(トリプル)です。ウェブ技術の標準化団体W3CのRDF 1.1 Concepts and Abstract Syntax(2014年2月25日勧告)は、RDFトリプルを主語、述語、目的語の3要素で構成されるものと定め、「RDFグラフはRDFトリプルの集合である」と書いています。主語と述語は主にIRI(国際化されたURI)で表され、目的語はIRIか、文字列や数値のリテラルです。「みどり測器(主語)の設立年(述語)は1998年(目的語)」が1本の線に当たります。
LLMと知識グラフの統合を論じた総説「Unifying Large Language Models and Knowledge Graphs: A Roadmap」(Pan他、IEEE TKDE掲載、arXiv 2306.08302)も、知識グラフを「構造化された知識を三つ組の集まりとして保存するもの」と定義し、頭のエンティティh、関係r、尾のエンティティtの組(h, r, t)の集合として書いています。Hogan他の総説の表現を借りれば、「実世界の知識を蓄積し伝えることを意図したデータのグラフ」です。英語版Wikipediaの項目は、ナレッジグラフを「グラフ構造のデータモデルで表現し操作する知識ベース」とし、「物体、出来事、状況、抽象概念といったエンティティの相互にリンクした記述」を保存するもの、と言い表しています。
Googleのナレッジグラフの歴史:2012年の発表からAPIの移行まで
Googleのナレッジグラフは2012年5月16日に発表され、公開ナレッジグラフを情報源の一つに取り込みながら育ってきました。公式に確認できる出来事を時系列で並べます。
| 年月 | 何が起きたか | 確認した出典 |
|---|---|---|
| 2007年 | Freebase(共同編集型の知識ベース)が始まる。DBpediaも同年に始まる | Googleの開発者向けサイトのFreebaseページ、DBpedia |
| 2012年5月16日 | Googleがナレッジグラフを発表。5億超のオブジェクトと35億超の事実。情報源としてWikipedia、Freebase、CIA World Factbookを挙げる | Google公式ブログ |
| 2012年10月29日 | Wikimedia財団のWikidataが公開される | 英語版Wikipedia「Wikidata」 |
| 2014年 | GoogleがFreebaseの内容をWikidataのコミュニティに提供することを決める(12月に終了を発表) | Google ResearchとWikimediaの共著論文(2016年)、英語版Wikipedia |
| 2015年 | Freebaseの運営が終わる(2007〜2015年) | Freebaseページ |
| 2016年8月31日 | Freebase Search APIが廃止される | 同上 |
| 2024年4月(文書の更新日) | Knowledge Graph Search APIの文書に、Cloud Enterprise Knowledge Graphへ移行中との注記 | Googleの開発者向けサイト |
| 2026年10月26日 | Google CloudのEnterprise Knowledge Graphの概要文書が更新(プレビュー提供) | Google Cloud |
Google自身は、検索の仕組みを説明する「情報の整理」のページで、検索インデックスの情報は「クロールを通じて、パートナーシップを通じて、Googleに送られるデータフィードを通じて、そしてGoogle独自の事実の百科事典であるナレッジグラフを通じて収集された」と述べています。「事実の百科事典」という表現が、ナレッジグラフの位置づけを端的に示しています。なお、2020年に公表されたエンティティ数と事実数は、ナレッジパネルを主題にした別の記事で紹介しているため、本記事では繰り返しません。
Freebaseの終わり方は、公開ナレッジグラフ同士の関係を示す例です。Freebaseの解説ページ(Googleの開発者向けサイト、2023年11月20日更新)は、Freebaseを「2007年から2015年まで続いたデータ共有プロジェクト」と説明し、最後のデータダンプには19億件のトリプルが含まれると記しています。同じページに、2013年10月28日時点のWikidataのダンプを基に作られたFreebaseとWikidataの対応表(210万件のトリプル)も残っています。GoogleとWikimedia財団の研究者が2016年のWorld Wide Web Conferenceで発表した論文の要旨には、「Googleは2014年、Freebaseの内容をWikidataのコミュニティに提供することを決めた」とあります。
Knowledge Graph Search APIが返すもの、返さないもの
Knowledge Graph Search APIは、GoogleのナレッジグラフにあるエンティティをキーワードやIDで検索し、JSON-LD形式で返す読み取り専用のAPIです。開発者向けの概要ページ(2024年4月26日更新)は、用途として「条件に一致する最も著名なエンティティのランキングを得る」「検索ボックスでエンティティを予測入力する」「コンテンツにナレッジグラフのエンティティで注釈を付ける」の3つを挙げています。
返ってくる項目は、リファレンス(2024年6月26日更新)の応答例で確かめられます。
| 応答の項目 | 内容 | 会社の点検で見るところ |
|---|---|---|
| @id | kg:/m/… または kg:/g/… の形の機械ID | 自社に固有のIDが振られているか |
| name | エンティティの名前 | 正式名称か、略称や旧社名か |
| @type | schema.orgの型。会社なら組織型かその下位の型 | 会社として分類されているか |
| description | 短い説明(例:「日本の測定機器メーカー」) | 業種や所在地の説明が正しいか |
| detailedDescription | 長めの説明文と、その出典URL、ライセンス | 説明文がどのページに基づいているか |
| url | 公式サイトのアドレス | 自社のドメインが結び付いているか |
| resultScore | 検索条件への一致度を示す数値 | 同名の他社より自社が上に出るか |
検索の条件は、キーワード(query)、ID(ids)、言語(languages)、型の絞り込み(types)、前方一致(prefix)、件数(limit)で指定します。limitは「最大500、既定は20」で、大きな値では「タイムアウトの可能性が高くなる」と注記されています。型の絞り込みにはschema.orgの型名を使います。概要ページは、ナレッジグラフにあるエンティティの型の「一部」として、本、出来事、地域のビジネス、組織、人、場所、ウェブサイトなど21種類を挙げています。利用上限のページ(2025年8月28日更新)によると、無料枠は1プロジェクトあたり1日10万回の読み取りです。
返さないものも明記されています。概要ページは、このAPIが「本番環境で重要なサービスとしての利用には適さない」と断り、個々の一致したエンティティを返すだけで、つながったグラフ全体は返さないと説明しています。グラフ全体が必要ならWikidataのデータダンプを勧める、という書き方です。さらに「このAPIをCloud Enterprise Knowledge Graphへ移行中」で、新規の利用者にはGoogle CloudのEnterprise Knowledge Graphを使うよう勧める注記があります。APIに自社が出ないことは、Googleが自社を知らないことと同義ではなく、「著名なエンティティのランキング」に入っていないことを意味するにとどまります。
公開ナレッジグラフと企業内ナレッジグラフ:Wikidata・DBpedia・YAGOと、社内データの名寄せ
公開ナレッジグラフは誰でも読み書きや利用ができる知識ベースで、企業内ナレッジグラフは一つの会社が社内データを束ねたものですが、どちらも「同じものを一つにまとめる」照合を中心に動いています。会社の担当者にとっては、前者は自社がどう記述されているかを確かめる場所、後者は社外で起きている名寄せの問題を社内の言葉で理解する手がかりです。
Wikidata:9,031万件超の項目を持つ最大の公開ナレッジグラフ
誰でも読み書きできる最大の公開ナレッジグラフがWikidataです。Wikidataのトップページは、自らを「人間と機械の双方が読み書きできる、自由でオープンな知識ベース」と定義し、2026年11月1日に開いた時点で9,031万818件のデータ項目があると表示していました。あわせて、Wikipediaをはじめとする関連プロジェクトが使う構造化データの「中央保管庫」の役目も担う、と書かれています。
英語版Wikipediaの「Wikidata」の項目によると、Wikidataは2012年10月29日に公開され、データはCC0(著作権を放棄するパブリックドメイン宣言)で提供されます。2025年初めの時点で項目に付いた記述(ステートメント)は16億5,000万件とされ、AppleのSiriやAmazon Alexaといった音声アシスタントにも使われてきました。Pan他の総説はWikidataを「最も広く使われている百科事典型ナレッジグラフの一つ」と位置づけ、Freebase、DBpedia、YAGOも「いずれもWikipediaから派生した」同種の知識グラフだとしています。
DBpediaとYAGO:Wikipedia由来の2つの知識ベース
DBpediaは、Wikimediaのプロジェクトから構造化された内容を抽出する「コミュニティによる取り組み」で、2007年に始まり、「数百万の概念」にリンクトデータのURIを与えています。YAGOは「人、都市、国、映画、組織に関する一般知識を持つ大規模な知識ベース」で、2026年7月に4.6版が公開されました(Télécom Parisがホスト)。いずれもWikipediaやWikidataの記述を元にしているため、日本の会社がこれらに載る経路も、まずWikipediaとWikidataに記述が存在することになります。
企業内ナレッジグラフ:社内データの名寄せに使われる
企業内ナレッジグラフとは、一つの会社が自社の顧客、製品、取引、文書といった社内データを、エンティティと関係のグラフとして統合したものです。Hogan他の総説は「企業内ナレッジグラフは通常その会社の内部にあり、商用の用途に使われる」とし、使われている業界としてウェブ検索(Bing、Google)、商取引(Airbnb、Amazon、eBay、Uber)、ソーシャルネットワーク(Facebook、LinkedIn)、金融(Bloomberg、Capital One、Wells Fargoなど)を挙げています。用途には検索、推薦、個人向けエージェントなどがあります。
Google CloudのEnterprise Knowledge Graphの概要(2026年10月26日更新、プレビュー提供)は、この製品を「サイロ化した情報を組織の知識へ整理する」ものと説明します。中核は「表形式データの軽量でAIを使った意味的クラスタリングと重複排除のサービス」であるEntity Reconciliation API(エンティティ照合)で、「数十億のノードと数兆のエッジ」までの規模を扱うとしています。照合の結果、同じ対象だと判定された行には「エンティティのクラスタごとに固有の識別子」であるMID(機械ID)が振られます。社内の顧客台帳にある「みどり測器」「ミドリ測器株式会社」「Midori Sokki Co.」を1社に束ねる処理です。
検索で求められる「エンティティの一貫性」と、社内データ統合で求められる「名寄せ」は、同じ問題の裏表です。社外で表記がばらついていれば、Googleの側で行われる照合も失敗しやすくなります。
3つのナレッジグラフの比較
| 比較項目 | Googleのナレッジグラフ | Wikidata | 企業内ナレッジグラフ |
|---|---|---|---|
| 維持する主体 | Wikimedia財団が運営し、編集コミュニティが維持 | その会社(Google CloudのEnterprise Knowledge Graphなどの製品を使う場合もある) | |
| 規模 | 2012年の発表時で5億超のオブジェクト、35億超の事実。現在の全体像は非公開 | 9,031万818件の項目(11月1日の表示)、16億5,000万件のステートメント(2025年初め) | 会社ごとに異なる。Google Cloudの製品は数十億ノード・数兆エッジまで対応 |
| 会社が載る経路 | 公開情報からの自動抽出。申請窓口はない | 収載基準を満たす項目を編集者が作成。基準を満たさないデータは受け入れられない | 社内データを登録し、エンティティ照合で名寄せする |
| 何に使われるか | Google検索の意味理解、ナレッジパネル。AIモードの情報源の一つでもある(Googleの2025年の発表。ナレッジパネルの記事で引用) | Wikipediaなどの構造化データの保管庫、音声アシスタント、研究用データ | 社内検索、推薦、データ統合、LLMと組み合わせた社内の質問応答 |
| 会社が確かめる方法 | Knowledge Graph Search APIで検索、社名で検索 | Wikidataで社名を検索し、項目と記述を確認 | 自社のデータ基盤で確認 |
検索エンジンはエンティティをどう使うか:クエリの意味理解からナレッジパネルまで
検索エンジンは、入力された語をエンティティに結び付けて意図を読み取り、ウェブから集めた事実をそのエンティティに紐づけて蓄え、ナレッジパネルやAIの回答として表示します。Googleが公開している説明は「どう理解しているか」の方針にとどまり、個々の会社をどう照合しているかの手順は非公開です。本章では、公式に確認できる範囲と、そこから推測できる範囲を分けて整理します。
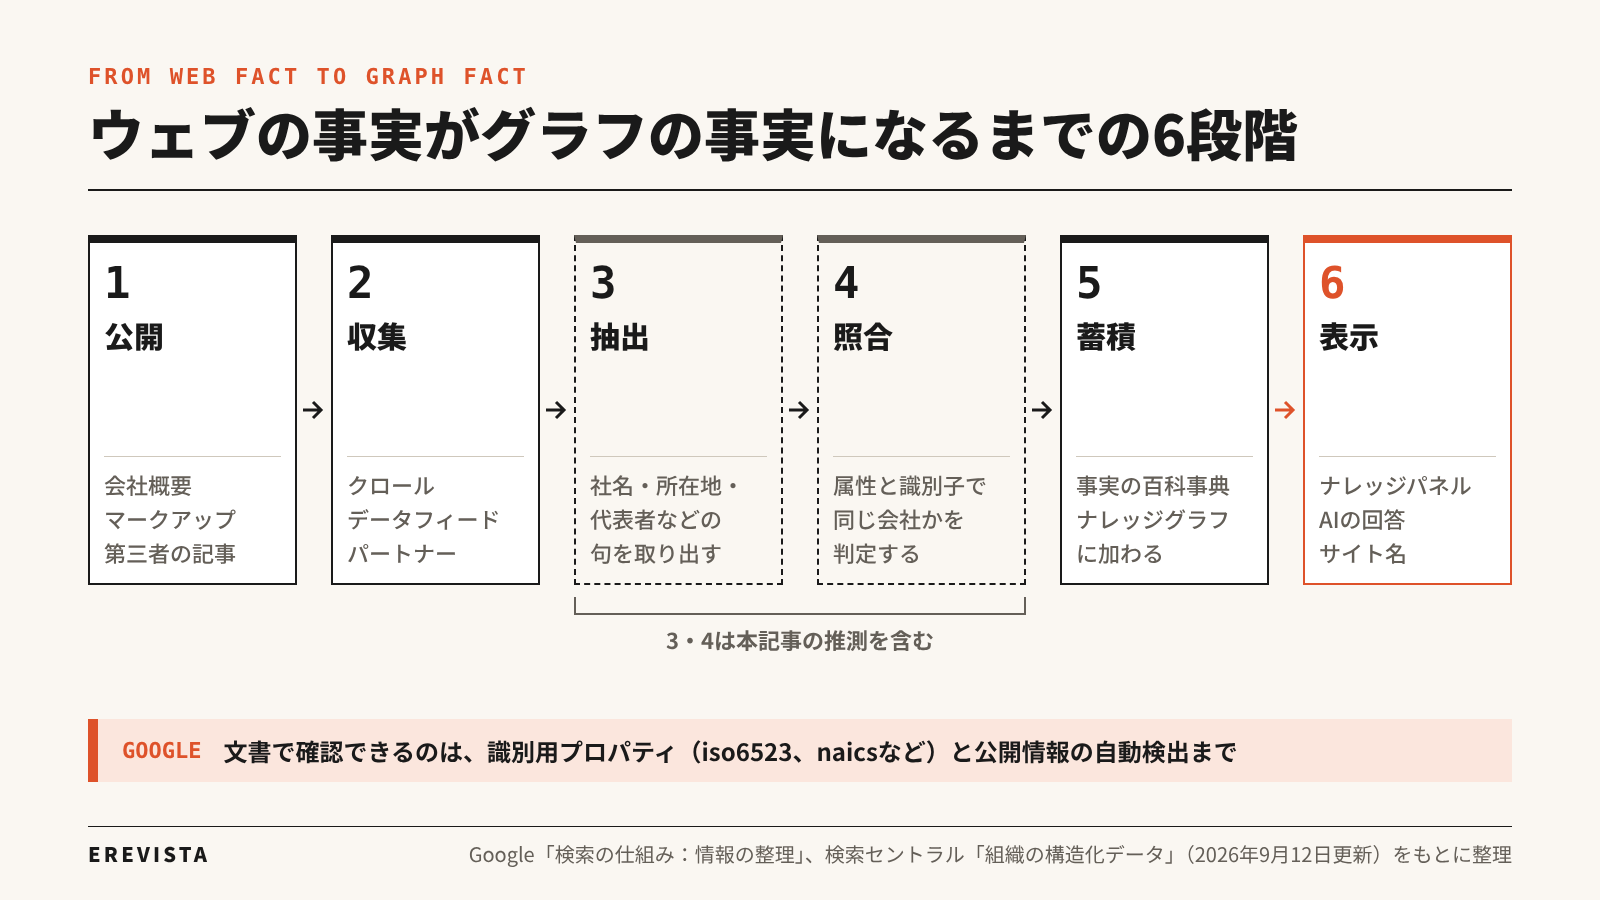
図:ウェブ上の会社情報がナレッジグラフの事実になるまでの6段階(Googleの公式文書をもとに本記事が整理。3・4は推測を含む)
文字列一致から意味の理解へ:同義語、BERT、MUM
Googleは、検索語を文字どおりに照合する段階から、語の意味と文脈を読む段階へ移ってきました。Googleの「ランキング結果の決定方法」のページは、検索クエリの意味を理解するために言語モデルを構築していると説明し、同義語のシステムについて「開発に5年以上かかりましたが、さまざまな言語での検索の30%以上で大幅に検索結果が改善しました」と述べています。「ノートパソコンの明るさ変更」で「明るさ調整」と書かれたページが見つかる、という例が添えられています。
言語理解の節目として、Googleは2つのモデルを公表しています。2019年10月25日の公式ブログは、BERTというモデルが「前後の語を見ることで、ある語の文脈全体を考慮できる」と説明し、米国の英語検索の10件に1件の理解が改善するとしました。同じ記事は、毎日の検索のうち15%が初めて見るクエリだとも書いています。2021年5月18日の公式ブログで発表されたMUMは、「BERTの1,000倍強力」で「75の言語と多数のタスクで同時に学習」したモデルです。複雑な作業では人が平均8回の検索を重ねているという観察も、この記事に載っています。
どれも「語の意味を読む」技術の説明で、エンティティの照合そのものについての説明は含みません。ただ、同義語や文脈を読む能力があるからこそ、表記の違う社名を同じ会社に結び付ける土台ができます。
テキストからエンティティを取り出す:Natural Language APIの例
文章の中の句を既知のエンティティに結び付ける処理は、Googleのクラウド製品の仕様で具体的に確かめられます。Google Cloud Natural Language APIのEntityのリファレンスによると、検出されたエンティティの型はPERSON(人)、LOCATION(場所)、ORGANIZATION(組織)、EVENT(出来事)、WORK_OF_ART(作品)、CONSUMER_GOOD(消費財)など13種類です。
注目したいのはメタデータの項目です。同リファレンスは、エンティティのメタデータとして、利用できる場合は「WikipediaのURL(wikipedia_url)とナレッジグラフのMID(mid)」が返ると書いています。つまり、文章中の「みどり測器」という句が既知の対象と結び付くと、その対象のWikipediaページとGoogleの機械IDが添えられます。あわせて返るsalience(顕著性)は、そのエンティティが文章の中でどれだけ中心的かを示す0から1.0の値で、「0に近いほど目立たず、1.0に近いほど顕著」と説明されています。
検索エンジンが同じ部品を使っているとGoogleが明言した文書は見つかりません。とはいえ、「句を既知のエンティティに結び付け、識別子を付ける」処理が製品として存在する事実は、ウェブ上の社名の記述がどう扱われるかを考える手がかりになります。
ウェブの事実がグラフの事実になるまで(本記事の整理)
公式サイトに書かれた一文が、検索エンジンの持つ「会社に関する事実」になるまでの流れを、公式文書で確認できる要素から本記事が整理したのが次の6段階です。
- 公開:会社の事実が、公式サイトの企業情報ページ、マークアップ、プレスリリース、第三者の記事に書かれる
- 収集:クローラーがページを読み、Google検索インデックスに加える。Googleはインデックスの情報がクロール、パートナーシップ、データフィード、ナレッジグラフから集められると説明している
- 抽出:ページの中の社名、所在地、代表者などの句がエンティティの候補として取り出される
- 照合:候補が既存のエンティティと同じかどうかを、名前以外の属性と識別子で突き合わせる。Googleが組織向けのマークアップについて公開している文書(2026年9月12日版)には、「ユーザーの組織とそれ以外の組織を識別するためにバックグラウンドで使用されるプロパティ(iso6523とnaicsなど)」があると書かれている
- 蓄積:同じ会社だと判定された事実がエンティティに結び付き、「事実の百科事典」であるナレッジグラフに加わる
- 表示:ナレッジパネル、サイト名、AIによる概要やAIモードの回答の材料として使われる
3と4は本記事の推測を含みます。Googleが文書で述べているのは、組織の構造化データに識別用のプロパティがあること、サイト名や連絡先などの公開情報をアルゴリズムが検出すること(2025年12月18日版)、公式サイトのURLが組織の一意な識別に役立つことまでです。
見える出力としてのナレッジパネル
ナレッジパネルは、社名などを検索したときに検索結果の脇に出る情報ボックスで、ナレッジグラフにあるエンティティの事実を表示する「見える出力」です。パネルが出る条件、認証の受け方、誤りを直す手続きはナレッジパネルの表示条件と修正の手順の記事が受け持っています。本記事の観点では、パネルに他社の情報が混ざる、旧社名が出るといった症状は、エンティティの照合がうまくいっていない結果として読めます。
LLMとエンティティ:言語モデルと知識グラフを組み合わせる研究が示すこと
LLMは、学習したテキストの統計から次の語を生成する仕組みのため、事実の想起が不安定で、知名度の低い対象ほど誤りや無回答が増えることが研究で確かめられています。この弱点を補うために、知識グラフをLLMと組み合わせる研究が進んでいます。会社の立場で読むべきは、「AIは知名度の低い会社ほど正しく語れない」という測定結果と、「外部の構造化された事実を足せば改善する」という方向性の2点です。
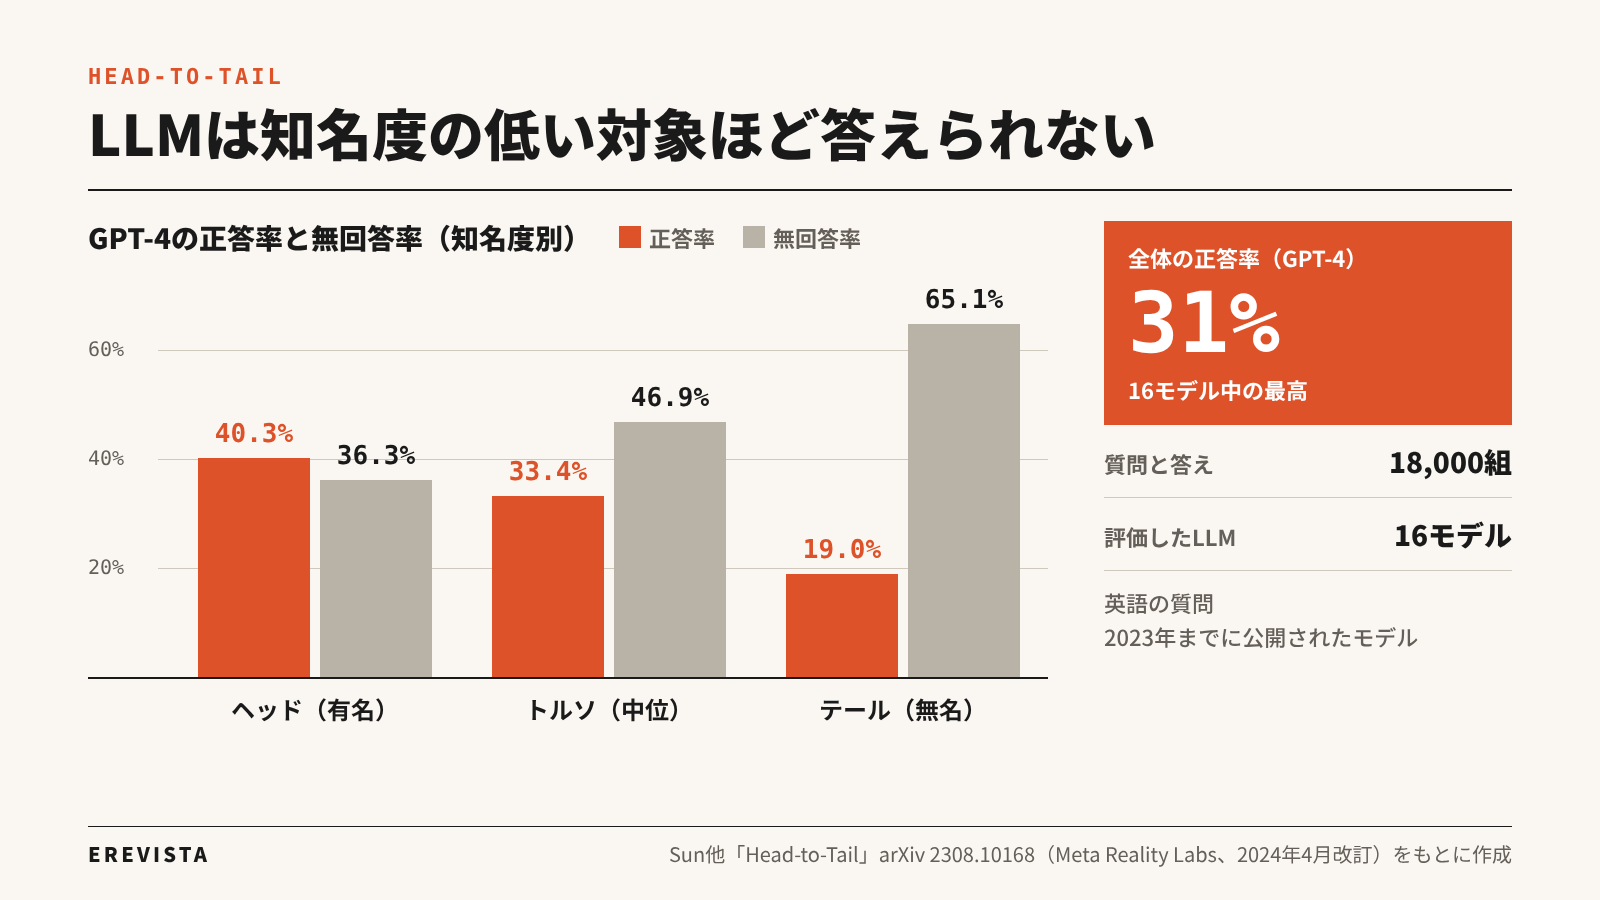
図:LLMは知名度の低い対象ほど答えられない——GPT-4の知名度別の正答率と無回答率(Sun他「Head-to-Tail」arXiv 2308.10168、2024年4月改訂をもとに作成)
LLMの弱点:事実の想起とハルシネーション
Pan他の総説(IEEE TKDE、arXiv 2306.08302)は、LLMを「事実知識の把握と参照にしばしば失敗するブラックボックスのモデル」と位置づけ、「LLMは事実を思い出せず、事実と異なる文を生成するハルシネーションをしばしば起こす」「この問題はLLMの信頼性を大きく損なう」と書いています。対照的に知識グラフは「豊富な事実知識を明示的に保存する構造化された知識モデル」ですが、「構築が難しく、性質として変化し続ける」ため、新しい事実や未知の知識を表すのが苦手だとも指摘しています。
知名度の低い対象ほど答えられない:Head-to-Tailの測定
Meta Reality Labsの研究者による論文「Head-to-Tail: How Knowledgeable are Large Language Models (LLMs)?」(arXiv 2308.10168、2024年4月3日改訂)は、18,000組の質問と答えで16のLLMを試しました。対象となる事実を、人気度(閲覧数などのトラフィック、なければ事実の密度)の累積が全体の3分の1までの「ヘッド(有名)」、3分の1から3分の2の「トルソ(中位)」、残りの「テール(無名)」に分けて測った点が特徴です。
| 対象の知名度 | GPT-4の正答率 | 誤答(ハルシネーション)率 | 無回答率 |
|---|---|---|---|
| ヘッド(有名) | 40.3% | 23.3% | 36.3% |
| トルソ(中位) | 33.4% | 19.7% | 46.9% |
| テール(無名) | 19.0% | 15.9% | 65.1% |
| 全体 | 31% | — | — |
全体で最も高かったのはGPT-4の31%で、論文は既存のLLMを「事実知識の把握において完全とは言い難い」と評しました。分野別の正答率は映画が41.7%、学術が10.0%と開きがあり、「すべてのモデルが映画で最も良く、学術で最も悪い」結果です。英語の質問で、2023年までに公開されたモデルを対象にした測定です。それでも、知名度の低い対象では「答えない」が3分の2近くに達し、答えた場合も誤りが混ざるという構図は、全国的な知名度を持たない大半の企業に当てはまると考えられます。著者らは、記号で表した知識(知識グラフ)とニューラルな知識(LLM)を「継ぎ目なく融合する」研究領域を提案し、次世代の知識グラフを「Dual Neural KGs」と呼んでいます。
統合の3つの枠組み:グラフで補うLLM、LLMで育てるグラフ、相乗
Pan他の総説は、LLMと知識グラフの組み合わせ方を3つに分類しています。
- KG-enhanced LLMs(知識グラフで強化したLLM):事前学習や推論の段階で知識グラフを取り込み、LLMの事実性を補う。LLMが何を学んだかの解釈にも使う
- LLM-augmented KGs(LLMで拡張した知識グラフ):知識グラフの埋め込み、補完、構築、グラフから文章への変換、質問応答にLLMを使う
- Synergized LLMs + KGs(LLMと知識グラフの相乗):両者を対等な部品として、データと知識の両方で駆動する双方向の推論を行う
同じ総説は、知識グラフを百科事典型、常識型、分野特化型、マルチモーダル型の4群に分け、Wikidataを百科事典型の代表としています。会社に関わるのは百科事典型で、LLMが参照するときの「事実の供給元」に当たります。
企業文書からエンティティのグラフを作るGraphRAG
RAG(検索拡張生成)は、質問のたびに文書を検索してLLMに渡す手法ですが、文書群全体を見渡す質問には弱いことが知られています。Microsoft Researchなどの研究者による論文「From Local to Global: A Graph RAG Approach to Query-Focused Summarization」(arXiv 2404.16130、2025年2月19日改訂)は、LLMに「重要なエンティティと、その間の関係」を文書から抽出させて「エンティティ知識グラフ」を作り、関連の深いエンティティ群ごとに要約を先に用意する手法を提案しました。
評価では、約100万トークン規模のポッドキャスト書き起こしとニュース記事の2つのデータセットで、従来のベクトル検索型RAGと比較しています。包括性の勝率はポッドキャストで72〜83%、多様性の勝率はポッドキャストで75〜82%、ニュースで62〜71%でした。社内文書に対する手法の研究ですが、「文書からエンティティと関係を取り出してグラフにすると、LLMの答えがまとまる」という結果は、ウェブ上の会社情報にも同じ構造が働くことを示唆します。示唆であって、検索サービスの内部が同じだという証明ではありません。
GoogleとAI検索サービスが公表していること、していないこと
Googleの文書で確認できるのは、AI機能の前提となる会社情報は最新に保て、という推奨と、AIの回答が文脈を取り違えることがあるという注意です。Google 検索セントラルの、AI機能についての説明文書(AI 機能とウェブサイトという文書で、2025年12月31日に最終更新)は、推奨事項の一つとして、Merchant CenterとGoogleビジネスプロフィールの情報を最新の状態に保つことを挙げています。会社の基本情報を古いままにしないことが、Googleの示す数少ない具体策の一つです。
Google 検索ヘルプのAIモードの解説には、AIモードがウェブの内容を誤って解釈したり、コンテキストを認識できなかったりする場合があるとの注意があります。会社の説明が誤る原因の一つは、この「コンテキストの誤認」、つまり同名の別の対象や古い情報との取り違えです。
GoogleのGeminiやMicrosoftのCopilot、OpenAIのChatGPT、Perplexityといったサービスが、ブランド名をどの手順でエンティティに解決しているかは、いずれも公表されていません。各社の公開資料から分かるのは、検索結果やウェブページを根拠として回答を組み立てる設計を取っている、という点までです。AI検索全体の見取り図はAI検索の仕組みと種類の記事にあります。
GeminiがGoogle検索の結果をどう根拠にして回答を作るか、そしてGeminiに引用される側の対策は、Geminiを取り上げた別記事に書きました。
本記事の線引き:文書で確認できること、推測にとどまること
| 論点 | 何に基づくか | 本記事の扱い |
|---|---|---|
| Googleはエンティティと関係の理解を検索の基盤にしている | 2012年の公式発表、検索の仕組みの公式ページ | 確認できる事実 |
| 組織の構造化データに、組織を識別するための項目がある | Google 検索セントラルの文書 | 確認できる事実 |
| Merchant CenterとGoogleビジネスプロフィールの情報は最新に保つ | Google 検索セントラルの推奨事項 | 確認できる事実(推奨) |
| LLMは知名度の低い対象ほど事実を誤る・答えない | 研究論文の測定(arXiv 2308.10168 ほか) | 研究で確認された傾向(英語、2023年までのモデル) |
| 表記の統一がAIの回答の正確さを直接高める | 公式文書・研究に直接の測定なし | 仕組みからの推測。効果の保証はない |
| 各AIサービスが社名をエンティティに解決する手順 | 公表なし | 不明。本記事は推測を事実と書かない |
研究から会社が受け取るべき結論は一つです。LLMが強くなるほど、根拠として参照する「構造化された事実」の質が答えの質を左右します。会社情報の整備はAIの回答の材料を正しく置く作業であり、AIの進歩で要らなくなる種類の仕事ではありません。
エンティティSEOとは:会社が「一つの実体」として認識されるための7つの条件
エンティティSEOとは、検索エンジンと生成AIが自社を同名の他社や旧情報と混同せず、一つの会社として正しい属性とともに認識できるよう、会社の事実の「出どころ」と「表記」をそろえる取り組みのことです。本記事が提案する条件は、正典となる会社情報ページ、表記の統一、組織型の構造化データとsameAs、Wikidataの確認、第三者による同じ事実の反復、指名検索、定期点検の7つです。どれも認識を約束する手段ではなく、照合の材料を増やして矛盾を減らす作業です。
取り組む理由は、誤った説明が信頼と購買に響くと消費者自身が答えているからです。マーケティング支援を手がける会社が、2026年3月にPR TIMESで公表した消費者調査(調査は同年2月、直近1年にSaaS・士業・美容医療・保険・化粧品のいずれかを購入・契約した20〜50代の800名、インターネット調査)では、生成AIが誤った情報を回答した場合にその企業や商品への信頼度が「下がる」とした人が71.4%(とても下がる23.6%、やや下がる47.8%)に達しました。回答者の8割超は生成AIの回答が購入や利用に「影響した」とし、約16%は回答から直接の購入や問い合わせに進んでいます。1社の調査で5業種の購入者に限られますが、AIの説明が検討の入口になっている様子は読み取れます。

図:会社が「一つの実体」として認識されるための7つの条件(本記事の提案)
条件1:正典となる会社情報ページを一つ持つ
最初の条件は、会社の事実の「正本」となるページを公式サイトに一つ置き、そこに次の項目を一度だけ、正式な表記で書くことです。
- 正式名称(登記上の商号)と、使っている略称・英字表記
- 法人番号(13桁)
- 本店所在地(登記上の住所と、実際の事務所が違うなら両方)
- 設立年月日、資本金、従業員数(時点を添える)
- 代表者の氏名と役職、連絡先の電話番号
- 事業内容、主要サービス・製品の正式名称
- 親会社・子会社・グループ会社との関係
- 公式SNS、公式の外部プロフィールへのリンク
法人番号を載せる意味は、公的なデータベースと自社ページを同じ鍵でつなげることにあります。経済産業省のgBizINFOは「500万社以上の政府保有法人データ提供サイト」で、法人番号または法人名から法人のプロフィールを参照できます。同サイトの脚注には経済産業省自身の法人番号4000012090001が記されており、公的機関も13桁の番号で自らを識別している例になっています。会社概要ページの法人番号が公的データと一致していれば、同名の会社と区別する根拠が機械にも人にもはっきりします。
このページは、運営者情報として信頼の判断にも使われます。誰が運営し、どう連絡できるかを示すことが品質評価でどう見られるかは、E-E-A-Tの考え方と企業サイトでの示し方の記事に書きました。
条件2:社名・所在地・連絡先の表記をそろえる(エンティティの一貫性)
二つ目の条件は、自社が管理するすべての場所で、社名、所在地、電話番号(NAPと呼ばれます)の書き方を一つにそろえることです。Googleはビジネス情報のガイドラインで、Googleビジネスプロフィールのビジネス名を、店舗、ウェブサイト、ビジネスレターなどで一貫して使われ、顧客に認知されている実際の名称にするよう求め、「ビジネス名に不要な情報を含めることはできません」と定めており、「ビジネス プロフィールはビジネスにつき1つのみ作成します」とも書いています。一つの会社に一つの表記という原則は、エンティティの照合全般に通じます。
表記が割れやすいのは、次のような場所です。
| ゆれの型 | 例(架空) | 機械側で起きうること |
|---|---|---|
| 法人格の位置と省略 | 株式会社みどり測器/みどり測器株式会社/みどり測器(株)/みどり測器 | 別名として学習されるが、別会社の候補にもなる |
| 英字と片仮名 | Midori Sokki/ミドリソッキ/MIDORI SOKKI Co., Ltd. | 英字表記だけが海外の別エンティティに結び付く |
| 旧社名・合併前の名称 | 旧「みどり計測器製作所」が求人サイトや名簿に残る | 旧社名と新社名が二つの会社として併存する |
| 略称・ブランド名 | 「みどり測器」と製品ブランド「MIDORI-Scope」 | 製品名が会社名として、または会社名が製品名として語られる |
| 住所の書き方 | 「1-2-3」と「一丁目2番3号」、ビル名の有無、移転前の住所 | 所在地の照合に失敗し、別の拠点や他社と見なされる |
| 全角・半角・スペース | 「みどり測器 株式会社」のスペース、全角英数字 | 文字列としては別物になる。多くは吸収されるが、確実ではない |
点検する場所は、公式サイトの全ページ(フッターや問い合わせページを含む)、Googleビジネスプロフィール、LinkedIn・X・Facebook・YouTubeなどの公式アカウント、プレスリリースの会社概要欄、求人媒体の企業ページ、取引先サイトの導入事例、業界団体や信用調査会社の名簿です。自社で直せる場所から順に直し、第三者の掲載は訂正を頼みます。
条件3:組織型の構造化データとsameAsで同一性を宣言する
三つ目の条件は、トップページもしくは会社概要のページに組織型のマークアップを置き、sameAsで公式プロフィールを結ぶことです。Googleが公開している組織向けマークアップの文書(2026年9月12日が最終更新日)は、ホームページにこの記述を加えるとGoogleが組織の管理情報を把握でき、検索結果で組織を他と区別して示せるようになると説明し、識別のために「バックグラウンドで使用される」プロパティとしてiso6523とnaicsを挙げています。DUNSナンバーは接頭辞0060、LEIは接頭辞0199を付けてiso6523Codeに書く、という推奨もあります。日本の法人番号には、この文書は触れていません。
エンティティの観点で書くべき項目は、サイト名と同じ表記のname、登記名のlegalName、略称や旧社名を入れる別名、url、logo、設立日、住所、そしてsameAsです。sameAsに並べるのは、公式SNS、Wikidataの項目(あれば)、Wikipedia記事(あれば)、公的データベースの自社ページのように「同じ組織を指す」ページだけです。他社のページや業界団体のトップページを入れると、宣言そのものが矛盾します。親会社や子会社がある場合は、親組織と子組織を結ぶプロパティで関係を書き、グループ各社の会社概要でも同じ関係を文章で明記します。JSON-LDの書き方、置き場所、検証ツールでの確認は構造化データの実装手順とテストの記事が受け持っています。
条件4:Wikidataの項目を確かめる(作るのは要件を満たすときだけ)
四つ目の条件は、Wikidataに自社の項目があるかを確かめ、あれば記述の正確さを点検することです。トップページの検索窓に正式社名、略称、英字表記を入れ、項目が出れば「分類(instance of)」が企業になっているか、本社所在地、設立日、公式サイトなどの記述が最新かを見ます。項目が複数あれば、同名の別会社か、重複項目かを判別します。
項目がない場合に自社で作ってよいかは、Wikidataの収載基準で決まります。基準は、Wikipediaなど関連プロジェクトのページへの有効なリンクがあること、「真剣で公開されている参照情報で記述できる、明確に識別可能な概念的または物質的な実体の実例」であること、他の項目の記述を有用にする構造上の必要があること、のいずれかを満たすことです。基準を満たさないデータは「残念ながらWikidataでは受け入れられない」と明記され、代わりにWikibaseの自前環境が案内されています。宣伝のためにWikipedia記事を作ることは勧めません。利害関係者の編集に対するWikipediaの方針は、ナレッジパネルの記事で原文を引いて説明しています。
条件5:第三者が同じ事実を繰り返す
五つ目の条件は、自社以外のページが自社と同じ事実を書いていることです。ナレッジグラフは公開情報から事実を集めるため、公式サイトにしかない事実より、報道、公的データベース、取引先の導入事例、業界団体の会員一覧に同じ所在地・設立年・事業内容が載っている事実のほうが、照合の裏づけになります。第三者の言及(サイテーション)を増やす考え方と、国内外の調査データは、サイテーション(第三者による言及)の集め方の記事に譲ります。
言及にリンクが付いている場合の評価は、別の論点です。リンクの集め方と注意点は被リンクの基本と集め方の記事に委ねます。ここで強調したいのは、リンクの有無より「書かれている事実が公式と一致しているか」です。第三者のページに旧社名や移転前の住所が残っていれば、掲載しているサイトに訂正を頼む作業が、エンティティの整備に含まれます。
条件6:指名検索という需要側の信号
六つ目の条件は、社名で検索する人がいることです。供給側(公式サイトと第三者の記述)がそろっても、その名前を探す人がいなければ、検索エンジンにとって区別する価値のある対象になりにくいはずです。これは仕組みからの推測で、Googleが条件として公表した事実ではありません。社名で探される状態をどう作り、どう測るかは、指名検索の意味と増やし方の記事が引き受けています。
条件7:検索とAIでの見え方を定期的に点検する
七つ目の条件は、整えた情報が実際にどう認識されているかを、同じ手順で繰り返し確かめることです。会社の事実は移転、代表者交代、社名変更、サービスの改称で変わり、第三者の掲載は放置されます。点検の具体的な手順を、次の章で示します。
点検の手順:API、検索、AIへの5つの質問で自社のエンティティ状態を確かめる
点検は、Knowledge Graph Search APIでの検索、Google検索での確認、4つのAIサービスへの同じ質問、混同の型の特定、記録と再点検の5手順で進めます。最初の一巡は半日、以後は月1回の繰り返しというのが本記事の見積もりです。
手順1:Knowledge Graph Search APIで社名を検索する
- Google CloudのプロジェクトでKnowledge Graph Search APIを有効にする(無料枠は1日10万回)
- 検索語(query)に正式社名を入れ、言語(languages)にja、型(types)に組織の型を指定して呼び出す。略称、英字表記でも同じ条件で呼び出す
- 応答の各エンティティについて、機械ID(@id)、名前、短い説明、長い説明の出典URL、公式サイトのURL、一致度(resultScore)を記録する
- 自社の名前で複数のエンティティが返るなら、同名他社か重複かを見分ける。短い説明にある業種や所在地が手がかりになる
- 自社が返らない場合は「著名なエンティティのランキングに入っていない」と記録し、Googleが自社を知らないと断定しない
応答に含まれるdetailedDescriptionの出典URLは、Googleがその説明文をどのページに基づいて作ったかを示します。出典がWikipediaなら、その記述が説明の元になっています。APIはリファレンスが示すとおり読み取り専用で、ここから修正を申し出ることはできません。
手順2:正式社名・略称・英字表記でGoogle検索する
- 正式社名、略称、英字表記、主要サービス名の4通りで検索し、PCとスマートフォンそれぞれの結果を保存する
- ナレッジパネルの有無と、出ている場合の名称、説明文、画像、リンク先を記録する
- 1ページ目に同名の他社、旧社名、無関係の対象が出ていないかを見る
- 検索結果のサイト名とタイトルに表示される社名の表記が、会社概要と一致しているかを見る
パネルに誤りがあった場合の直し方はナレッジパネルの記事に従い、ここでは「何が、どの表記で出たか」を記録することに集中します。
手順3:4つのAIサービスに同じ5つの質問をする
- 「〇〇(正式社名)はどのような会社ですか」
- 「〇〇の本社所在地と設立年を教えてください」
- 「〇〇の代表者は誰ですか」
- 「〇〇の主なサービスや製品は何ですか」
- 「〇〇と同じ名前、または似た名前の会社はありますか」
この5問を、Gemini、ChatGPT、Copilot、Perplexityの4つに同じ日に投げ、回答の全文、示された出典、誤りの箇所、古い情報の箇所を記録します。想定例として、4サービスに5問を月1回続けると、1年で4×5×12=240件の回答が蓄積され、どのサービスがどの出典をもとに自社を語るかの傾向が見えます。5問目は、同名他社との混同をAIの側がどう扱っているかを直接確かめる質問です。Copilotでの回答の見え方と出典の確かめ方は、Copilotを取り上げた別記事にあります。
手順4:混同の型を特定し、直し方を決める
| 混同の型 | 典型的な症状 | 主な原因 | 直し方 |
|---|---|---|---|
| 同名の他社 | 他社の所在地や事業がAIの説明に混ざる。APIで同名のエンティティが複数返る | 名前以外の属性が両社とも乏しい | 会社概要に法人番号・所在地・設立年・業種を明記し、構造化データとsameAsで公式プロフィールを結ぶ。第三者の記事にも所在地や業種を添えてもらう |
| 親会社と子会社 | 子会社の売上や代表者が親会社のものとして語られる。グループの代表的な会社に吸収される | グループ各社の情報が1ページに混在 | 会社ごとに会社概要ページを分け、parentOrganizationとsubOrganizationで関係を宣言し、文章でも関係を明記する |
| 旧社名・合併前の名称 | 旧社名で説明される。旧社名と新社名が別会社として扱われる | 第三者サイトに旧社名が残り、変更の告知が見つからない | 社名変更の告知ページを残し、会社概要とalternateNameに旧社名を書き、掲載元に更新を依頼する |
| 製品名と社名の混同 | 製品の説明が会社の説明になる、または社名が製品名として語られる | 製品と会社を同じ名前で呼び、別のエンティティとして記述していない | 会社は組織の型、製品は製品の型(Product)として分けて記述し、製品ページに提供元を明記する |
| 創業者・代表者の個人名 | 個人の経歴が会社の歴史として語られる。個人の別の活動が会社に結び付く | 個人と会社の情報が同じページに混在 | 代表者の紹介ページを分けて人の型(Person)で記述し、会社側はfounderなどで関係を書く |
表の「直し方」はいずれも本記事の提案であり、成果を約束するものではありません。原因の切り分けには、手順1のdetailedDescriptionの出典URLと、手順3でAIが示した出典が手がかりになります。
手順5:記録して月1回繰り返す
点検の結果は、日付、調べた表記、サービス名、出た内容、誤りの有無、対処の担当と期限を1行ずつ残します。翌月に同じ条件で繰り返し、変化だけを見れば、どの修正が効いたかを追えます。この点検は、AI検索対策全体の点検項目の最初の1つに当たり、ほかの項目との関係は自社でできるLLMOの10のチェック項目の記事で合否形式の一覧にしてあり、あわせて使うと漏れが出にくいでしょう。
エンティティの一貫性を作る30-60-90日のロードマップ
90日の計画は、最初の30日で棚卸しを済ませ、次の30日で正典ページと表記統一とマークアップを整え、最後の30日で第三者の掲載とWikidataを点検して再計測する、という3段で組みます。会社情報の整備は一度で終わらず、変更が起きるたびに同じ順序で回すため、最初の90日は「手順を作る期間」でもあります。
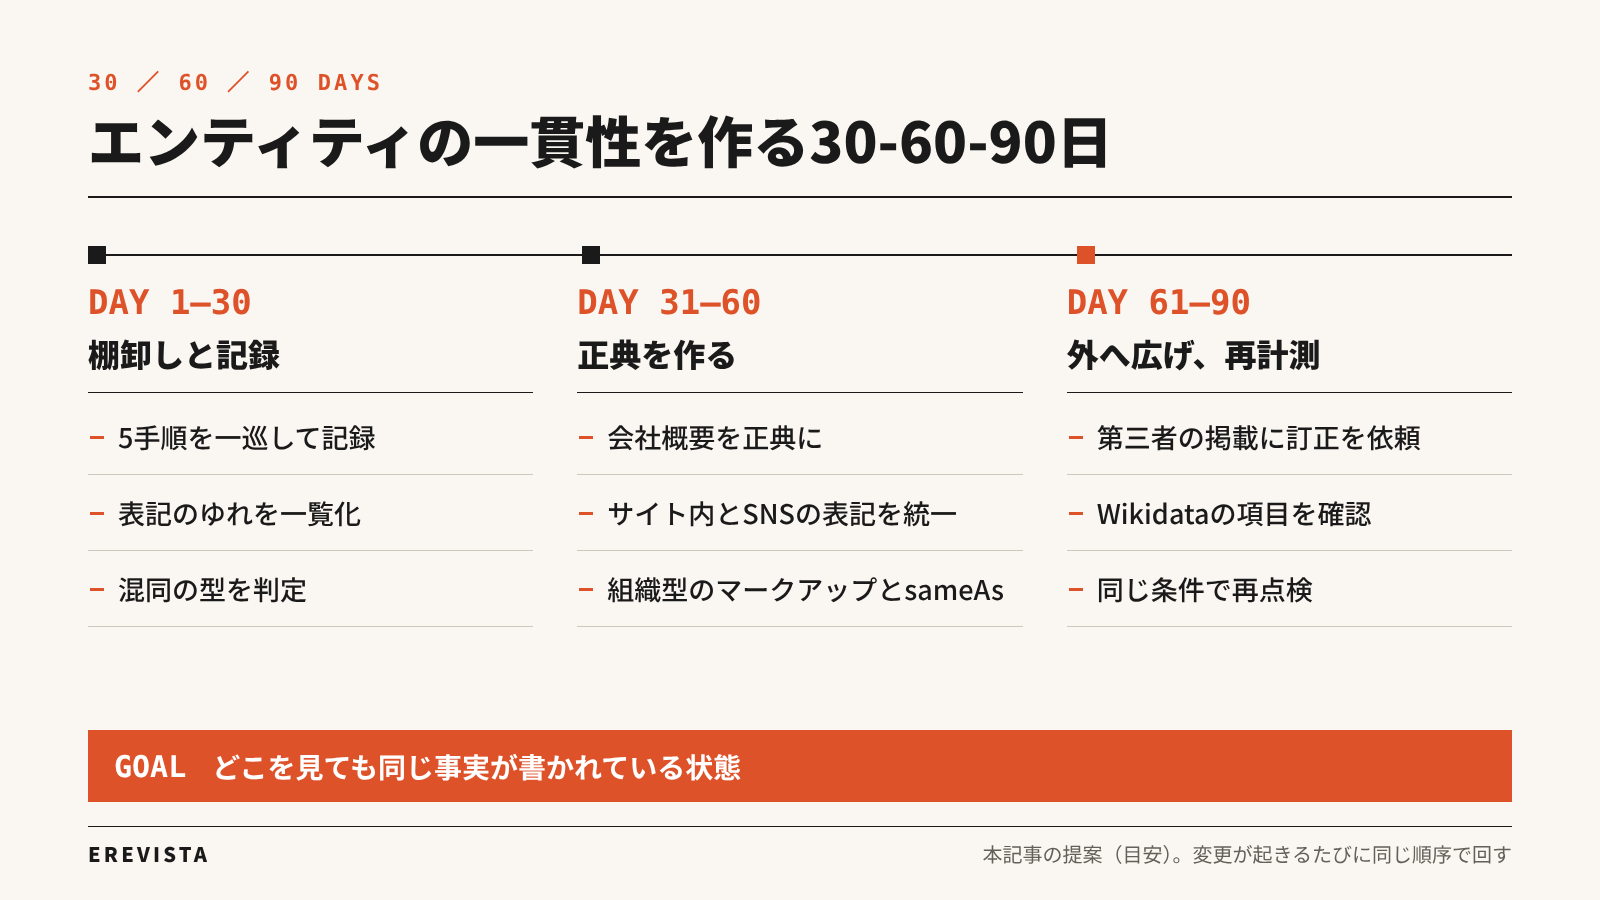
図:エンティティの一貫性を作る30-60-90日のロードマップ(本記事の提案)
1〜30日目:棚卸しと現状の記録
- 前章の5手順を一巡し、API、検索、4つのAIサービスでの見え方を日付つきで記録する
- 社名、代表者、所在地、電話番号、設立年、サービス名の表記を、公式サイト、公式SNS、求人媒体、プレスリリース、名簿から集めて一覧にする
- 表記のゆれと、誤り・古い情報の箇所に印を付け、自社で直せるものと第三者に依頼するものに分ける
- 混同の型(同名他社、親子会社、旧社名、製品名、個人名)のどれに当たるかを判定する
この段階の成果物は、「どこに、何が、どう書かれているか」の一覧表です。直す作業は始めず、全体像を先に持ちます。
31〜60日目:正典を作り、自社の管理下をそろえる
- 会社概要ページを正典として作り直し、正式名称、法人番号、所在地、設立年月日、代表者、事業内容、グループ関係、公式SNSを載せる
- 公式サイト内のフッター、問い合わせページ、採用ページの表記を正典に合わせる
- 組織型の構造化データをトップページまたは会社概要のページに置き、登記名、別名、sameAs、設立日、住所を正典と同じ値で書く
- Googleビジネスプロフィール、LinkedIn、X、Facebook、YouTubeの名称と所在地を正典に合わせる
- 社名変更や移転の履歴があれば、告知ページを残し、旧社名を別名として記述する
61〜90日目:第三者とWikidataを点検し、再計測する
- 第三者のページ(報道、名簿、取引先の事例、求人媒体)にある古い情報の修正を依頼し、依頼日と結果を記録する
- Wikidataに自社の項目があれば記述を確認し、なければ収載基準に照らして、満たさない場合は作らないと決める
- プレスリリースや寄稿の会社概要欄を、正典と同じ文面に統一する
- 30日目と同じ条件で、API、検索、4つのAIサービスへの5問を再び実施し、変化を比べる
- 社名で検索された回数を記録し、需要側の変化も並べて見る
体制:更新のきっかけを決めておく
会社情報が変わるきっかけは、移転、代表者の交代、社名やサービス名の変更、グループ再編、決算期の数字の更新です。それぞれについて「正典ページ、構造化データ、公式SNS、プレスリリースのひな形、第三者への依頼」をどの順で誰が直すかを決めておくと、ゆれは再発しにくくなります。担当は広報と情シスの2部署にまたがることが多いため、最終責任者を1人決めておくと更新が止まりません。
よくある質問(FAQ)
エンティティとキーワードの違いは何ですか?
キーワードは入力された文字の並びで、エンティティはその文字が指す対象です。「みどり測器」という文字列は、会社を指すこともあれば製品を指すこともありますが、エンティティとしての「株式会社みどり測器」は所在地や設立年といった属性を持つ一つの会社です。Googleはこの違いを2012年に「things, not strings」と表現しました。
ナレッジグラフとナレッジパネルは同じですか?
別のものです。ナレッジグラフはエンティティと関係と事実を蓄えたデータベースで、ナレッジパネルはその一部を検索結果に表示する情報ボックスです。パネルの表示条件や修正はナレッジパネルの記事で、データベースの側の考え方は本記事で扱っています。
ナレッジグラフとRAGの違いは何ですか?
ナレッジグラフは知識の保存の形式で、RAG(検索拡張生成)はLLMが答える前に外部の情報を検索して渡す手法です。両者は対立せず、文書からエンティティと関係を抽出してグラフを作り、それをRAGに使うGraphRAGのような手法があります。論文では、約100万トークン規模のポッドキャスト書き起こしに対する包括性の勝率が72〜83%と報告されています。
自社がGoogleのナレッジグラフに登録されているか調べる方法はありますか?
Knowledge Graph Search APIで正式社名を検索し、組織の型を持つエンティティが返るかを見る方法があります。返れば機械ID、説明文、説明文の出典URL、一致度が確かめられます。返らない場合でも、APIは著名なエンティティしか返さないため、認識されていないと断定はできません。社名でのGoogle検索の結果と突き合わせて判断します。
Wikipedia記事がないと、エンティティとして認識されませんか?
認識されないとは言えません。Googleは複数の情報源からエンティティの事実を集めると説明しており、Wikipediaはその一つです。会社概要ページ、法人番号などの公的な識別子、報道や名簿での一致した記述がそろっていれば、記事がなくても照合の材料はあります。宣伝目的でWikipedia記事を作ることは、Wikipediaの方針上も勧められません。
社名の表記ゆれはAIの回答に影響しますか?
影響しうると考えられますが、各AIサービスは社名をエンティティに解決する手順を公表しておらず、表記統一の効果を直接測った公開データもありません。根拠として示せるのは、Googleがビジネス名を実際に使われ顧客に知られている名称にそろえるよう求めていることと、LLMが知名度の低い対象ほど事実を誤る・答えないという研究結果です。表記をそろえる作業は、効果の保証ではなく、誤認の原因を一つ減らす作業として位置づけてください。
構造化データを入れればナレッジグラフに載りますか?
載る保証はありません。構造化データは組織の属性と識別子を宣言する手段で、Googleの文書も組織の把握に「役立つ」と述べるにとどまります。本文の記述、第三者の記述、マークアップの3つが同じ事実を示している状態が到達点です。
同名の会社と混同されているときはどうしますか?
まず、会社概要に法人番号、所在地、設立年、業種を明記し、同名他社との違いが属性で分かる状態を作ります。次に、組織型の構造化データとsameAsで公式プロフィールを結び、第三者の記事にも所在地や業種を添えてもらいます。ナレッジパネルに他社の情報が混ざっている場合は、ナレッジパネルの記事にある手順でGoogleに伝えます。
エンティティSEOとLLMOは何が違いますか?
エンティティSEOは、会社を一つの対象として正しく認識させるための会社情報の整備で、LLMO(Large Language Model Optimization)はAIの回答に自社が正しく登場するための取り組み全体です。エンティティの整備はLLMOの土台の一つで、コンテンツの作り方、クローラーの扱い、計測といった他の領域と組み合わせて進めます。全体の構成はLLMOの考え方と対策の全体像の記事に整理してあります。
まとめ:エンティティは「名前」ではなく「同じ事実の反復」で定まる
会社が一つのものとして認識されるかどうかは、社名という文字列ではなく、公式サイト、公的データベース、第三者のページ、構造化データが同じ事実を繰り返しているかで決まります。
- エンティティは名前の文字列と切り離して識別できる対象で、ナレッジグラフはエンティティ同士を関係でつなぎ事実を蓄えたデータベース。Googleは2012年5月16日に「things, not strings」として発表した
- Googleのナレッジグラフは非公開、Wikidataは9,031万818件(11月1日の表示)の項目を持つ公開ナレッジグラフ、企業内ナレッジグラフは社内データの名寄せに使われ、同じ考え方が3か所で働く
- Knowledge Graph Search APIは著名なエンティティを最大500件返すが、本番用途には適さず移行中。出ないことは「知られていない」ことを意味しない
- LLMは知名度の低い対象ほど事実を誤る・答えない(GPT-4の正答率はヘッド40.3%、テール19.0%)。知識グラフで補う研究が進む
- 会社側の条件は、正典ページ、表記の一貫性、組織型の構造化データとsameAs、Wikidataの確認、第三者による同じ事実の反復、指名検索、定期点検の7つ
- 点検はAPI、検索、4つのAIへの5問、混同の型の特定、記録の5手順で、月1回繰り返す
最初の一歩は、会社概要ページを開き、正式名称、法人番号、所在地、設立年月日、代表者が一度ずつ正式な表記で載っているかの確認です。そこが正典になっていなければ、ほかのどこを直しても基準が定まりません。
AIの中の自社情報が古い・誤っているときに、実体の問題として点検する資料
AIの説明が古い、あるいは他社と混ざっている状況は、本記事で整理した照合の失敗として読み解けます。EREVISTAの資料「【AIO・LLMO】AIが“答え”を出す時代、その答えに選ばれているか」は、6つの典型的な状況を点検する欄を用意し、AIに引用される条件の一つとしてエンティティを、一次情報や第三者言及や構造化と並べて示しています。資料の90日計画では、30日までの可視化が本記事の点検手順に、60日までの「実体を作る」段階が正典ページとマークアップの整備に相当します。
出典・参考資料
記事内のデータは2026年11月1日時点で確認したものです。
- Google「Introducing the Knowledge Graph: things, not strings」(2012年5月16日)
- Google for Developers「Google Knowledge Graph Search API」(2024年4月26日更新)
- Google for Developers「Method: entities.search(Knowledge Graph Search API REST リファレンス)」(2024年6月26日更新)
- Google for Developers「Usage Limits(Knowledge Graph Search API)」(2025年8月28日更新)
- Google Cloud「Enterprise Knowledge Graph overview」(2026年10月26日更新)
- Google for Developers「Freebase」(2023年11月20日更新)
- Google Research「From Freebase to Wikidata: The Great Migration」(World Wide Web Conference、2016年)
- Google「Google 検索の仕組み:Google によるランキング結果の決定方法」(2026年11月1日閲覧)
- Google「Google 検索の仕組み:情報の整理」(2026年11月1日閲覧)
- Google「Understanding searches better than ever before」(2019年10月25日)
- Google「MUM: A new AI milestone for understanding information」(2021年5月18日)
- Google 検索セントラル「AI 機能とウェブサイト」(2025年12月31日更新)
- Google 検索ヘルプ「Google 検索の AI モードで AI による回答を取得する」(2026年11月1日閲覧)
- Google Cloud「Natural Language API REST リファレンス:Entity」(2025年6月13日更新)
- Google 検索セントラル「組織(Organization)の構造化データ」(2026年9月12日更新)
- Google 検索セントラル「Google にビジネスに関する情報を提供する」(2025年12月18日更新)
- Google ビジネス プロフィール ヘルプ「Google に掲載するビジネス情報のガイドライン」(2026年11月1日閲覧)
- schema.org「sameAs」(V30.1、2026年9月16日)
- schema.org「Organization」(V30.1、2026年9月16日)
- W3C「RDF 1.1 Concepts and Abstract Syntax」(2014年2月25日勧告)
- Wikidata「Wikidata:Main Page」(2026年11月1日閲覧)
- Wikidata「Wikidata:Notability」(2026年11月1日閲覧)
- Wikidata「Property:P2671 Google Knowledge Graph ID」(2026年11月1日閲覧)
- Wikipedia(英語版)「Wikidata」(2026年11月1日閲覧)
- Wikipedia(英語版)「Named entity」(2026年11月1日閲覧)
- Wikipedia(英語版)「Knowledge graph」(2026年11月1日閲覧)
- DBpedia「About DBpedia」(2026年11月1日閲覧)
- YAGO「YAGO(公式サイト)」(2026年11月1日閲覧)
- arXiv(Hogan他)「Knowledge Graphs」(2021年9月11日改訂、DOI 10.1145/3447772)
- arXiv(Pan他)「Unifying Large Language Models and Knowledge Graphs: A Roadmap」(2024年1月25日改訂、DOI 10.1109/TKDE.2024.3352100)
- arXiv(Sun他、Meta Reality Labs)「Head-to-Tail: How Knowledgeable are Large Language Models (LLMs)? A.K.A. Will LLMs Replace Knowledge Graphs?」(2024年4月3日改訂)
- arXiv(Edge他、Microsoft Research)「From Local to Global: A Graph RAG Approach to Query-Focused Summarization」(2025年2月19日改訂)
- 国税庁 法人番号公表サイト「法人番号とは」(2026年11月1日閲覧)
- 経済産業省「gBizINFO」(2026年11月1日閲覧)
- マーケティング支援会社(PR TIMES)「AIの誤回答は「企業への不信感」に直結 71.4%が信頼低下と回答 2026年最新 生成AI回答がユーザーにもたらす影響を調査」(2026年3月12日)